

Në kuadër të projektit kërkimor ka filluar puna për të shtuar në GCC një mundësi që lejon ndarjen e procesit të kompilimit në disa rrjedha që ekzekutohen paralelisht. Në këtë moment, për të rritur shpejtësinë e ndërtimit në sistemet me shumë bërthama, në nivelin e utilitarit make, përdoret nisja e proceseve të veçanta të kompilatorit, secili prej të cilëve kryen ndërtimin e një skedari të veçantë të kodit. Projekti i ri eksperimenton me sigurimin e parallelizimit në nivelin e kompilatorit, çka potencialisht do të lejojë rritjen e efikasitetit të punës në sistemet me shumë bërthama.
Për testim një degë e veçantë paralelizuese e GCC, për të cilën është propozuar një parametr i ri "—param=num-threads=N" për të caktuar numrin e rrjedhave. Në fazën fillestare, është realizuar nxjerrja në rrjedha të veçanta të optimizimeve ndërprocedurale, të cilat thirren ciklikisht për çdo funksion dhe janë të përshtatshme për paralelizim. Janë kaluar në rrjedha të veçanta operacionet GIMPLE, të cilat janë përgjegjëse për optimizimet që nuk varen nga pajisjet, të cilat vlerësojnë ndërveprimin mes funksioneve.
Në fazën e ardhshme, është planifikuar gjithashtu që të kalohen në rrjedha të veçanta optimizimet RTL ndërprocedurale, të cilat marrin parasysh karakteristikat e platformës harduerike. Pas kësaj, planifikohet të realizohet parallelizimi i optimizimeve brendaprocedurale (IPA), të aplikuara në kodin brenda funksionit, pavarësisht karakteristikave të thirrjes. Një faktor limitues deri tani është mbledhësi i plehrave, në të cilin është shtuar një bllokim global, që çaktivizon operacionet e mbledhjes së plehrave gjatë punës në mënyrë shumërrjedhëshe (në të ardhmen, mbledhësi i plehrave do të adaptohet për ekzekutimin shumërrjedhëshe të GCC).
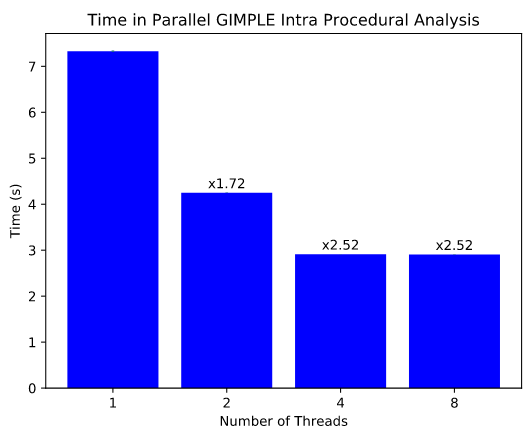
Për vlerësimin e ndryshimit të performancës është përgatitur një grup testesh, që realizon ndërtimin e skedarit gimple-match.c, i cili përfshin mbi 100 mijë rreshta kodi dhe 1700 funksione. Testet në një sistem me CPU Intel Core i5-8250U me 4 bërthama fizike dhe 8 virtuale (Hyperthreading) treguan një ulje të kohës së ekzekutimit të optimizimeve Intra Procedural GIMPLE nga 7 në 4 sekonda me nisjen e 2 rrjedhave dhe në 3 sekonda me nisjen e 4 rrjedhave, dmth, u arrit rritja e shpejtësisë në këtë fazë të ndërtimit me 1.72 dhe 2.52 herë, përkatësisht. Testet gjithashtu treguan se përdorimi i bërthamave virtuale gjatë Hyperthreading nuk shkakton rritje të performancës.
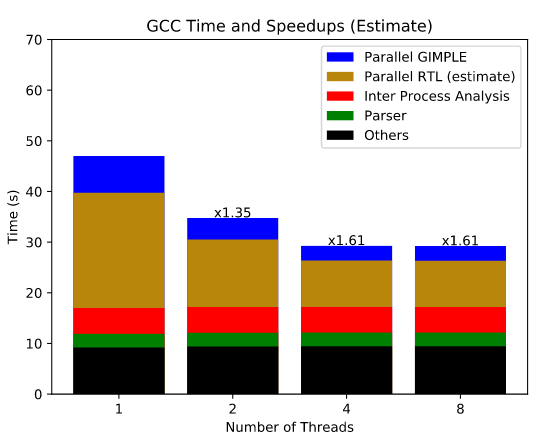
Koha e përgjithshme e ndërtimit u reduktua përafërsisht me 10%, por sipas parashikimeve, paralelizimi i optimizimeve RTL do të mundësojë rezultate më të dukshme, pasi ky fazë merr ndjeshëm më shumë kohë gjatë kompaktimit. Përafërsisht pas paralelizimit të RTL, koha e përgjithshme e ndërtimit do të reduktohet me 1.61 herë. Pas kësaj, koha e ndërtimit mund të reduktohet me 5-10% të tjera përmes paralelizimit të optimizimeve IPA.
Burimi: opennet.ru
