

Në kuadër të projektit Qwenputer, studiuesit kanë përgatitur një variant të avancuar të modelit AI Qwen3.5-4B, në të cilin është implementuar një simulator i plotë 32-bit CPU bazuar në arkitekturën RISC-V (RV32IM), që mbështet zgjerimin Zba dhe është i pajisur me një koprocessor bignum për operacione aritmetike me numra të mëdhenj. Implementimi i bërthamës CPU është kompaktuar në një grup peshash dhe është integruar në një model të madh gjuhësor në formën e 11 shtresave shtesë të transformatorëve, të shtuar para shtresave kryesore Qwen. Llogaritjet kryhen direkt gjatë procesit të kalimit përpara (forward pass) të rrjetit nervor, pa u lidhur me mjete ose plugina të jashtme.
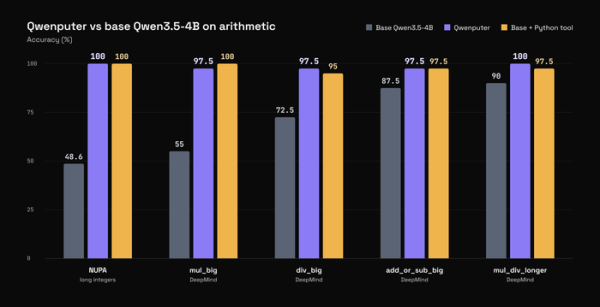
Implementimi kalon me sukses të gjitha verifikimet nga grupi zyrtar i testeve riscv-tests dhe është në gjendje të ekzekutojë kodin e kompajluar në C dhe MicroPython. Kur kryen llogaritje aritmetike me numra të mëdhenj, Qwenputer siguron saktësi prej 97.5-100%, e cila është e krahasueshme ose e tejkalon rezultatet e modelit bazë Qwen3.5 me interpretuesin e jashtëm Python të lidhur.
Për simuluar kujtesën operative në model, janë angazhuar shtresa të veçanta Gated DeltaNet (RNN lineare), të aplikuara në modelin standard AI Qwen për ruajtjen e gjendjes së ndryshuar gjatë punës me dritare të mëdha kontekstuale. Duke qenë se gjendja e derës fiksohet dhe aplikohet kodifikimi unitar (one-hot), çdo kërkesë për shkrim riprogramon pikërisht një rresht të matricës së gjendjes, duke e bërë të mundur që gjendja DeltaNet të përdoret si memorie e adresueshme me madhësi fikse, duke shmangur rritjen lineare të cache-it KV (Key-Value) me rritjen e gjatësi së kontekstit. Në këtë memorje vendosen regjistrat e CPU, të dhënat dhe kodi i ekzekutueshëm i makinerisë.
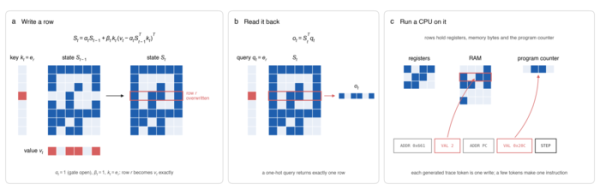
Udhëzimet e procesorit, si leximi i regjistrave, operacionet aritmetike dhe kalimet kushtore, kompilohet drejtpërdrejt në peshat e shtresave të transformatorit. Çdo udhëzim përputhet me simbolet speciale (ADDR, VAL, STEP), të cilat shtresat e modelit AI i interpretojnë si logjikën e përpunimit të CPU. Për inicializimin e CPU dhe ngarkimin e firmware-it përdoret një drejtues i vogël i jashtëm RvChat, por vetë kodi i makinerisë përpunon krejtësisht brenda peshave të modelit.
Në kufijtë e projektit përmendet rreth dyfishi në krahasim me modelin origjinal Qwen, me një rritje të madhësisë (18.8 GB) duke ruajtur piketat e gjendjes (checkpoint), që origjinon kryesisht nga mbushja shtesë e shtresave të reja. Gjithashtu vërehet një shpejtësi e relativisht ulët e llogaritjeve (rreth 3200 tokene në sekondë në GPU L4), e cila bën që llogaritjet e ndërlikuara të mund të zgjasin sekonda, dhe jo milisekonda.
Për më tepër, është realizuar një variant i modelit të AI me një sistem eksperimental skedarësh, i cili lejon ruajtjen brenda peshave të modelit të AI deri në 512 skeda me 53 mijë.tokenesh teksti. Njësoj si në realizimin e memorjes operative, ruajtja është organizuar në lidhje me gjendjet DeltaNet, por ndryshon sepse FS ofron ruajtje të përhershme, që nuk humbet gjendjen midis seancave.
Qwenputer gjithashtu ka shërbyer si bazë për studimin e problemeve të reja potenciale të sigurisë në AI. Me shembullin e Qwenputer, është treguar se si një model AI i modifikuar mund të fshehë arsyetimet e saj në gjendjen RNN dhe të anashkalojë mekanizmat e monitorimit të arsyetimeve të modelit (CoT, Chain-of-Thought). Gjithashtu është demonstruar
mundësia e krijimit të mekanizmave të kontrollit dhe monitorimit të sigurisë, të integruar në peshat e modelit AI, të cilat vetë modeli nuk mund t'i çaktivizojë ose ndryshojë.
Burimi: opennet.ru
