

Zhvilluesit e OrioleDB analizuan gjendjen aktuale të API-t të nivelit të ulët, të përdorur për qasjen e zgjerimeve në tabela dhe indekse në PostgreSQL (Tabela/Indeksi Qasja Metodë (AM) API), dhe propozuan rrugë për përmirësimin e tij. Që nga shfaqja e këtij API në PostgreSQL 12, zhvilluesit kanë marrë mundësinë të krijojnë mekanizma alternativë për ruajtjen e të dhënave. Megjithatë, pavarësisht nga egzistenca e këtij API dhe kufizimeve të njohura të mekanizmit të ruajtjes së integruar, ende nuk janë shfaqur motorë të plotë tranzaksionalë të ruajtjes, të realizuar vetëm në formën e zgjerimeve.
Funksionet më të kërkuara për motorët alternativë të tabelave PostgreSQL janë:
- Realizime alternative të MVCC, për shembull, depozitë mbi bazën e regjistrit UNDO.
- Tabelat e organizuara sipas indekseve, ku indeksi nuk është një shtesë e panevojshme për tabelën që përshpejton kërkesat, por përfaqëson strukturën kryesore të dhënash, në të cilën ruhen të dhënat e tabelës.
Ndryshimet e nevojshme në API-në Table/Index AM për të mbështetur realizimet alternative të MVCC shqyrtohen me vëmendje në zgjerimin OrioleDB, të zhvilluar për të eliminuar të metat e njohura të mekanizmit të ruajtjes të integruar në PostgreSQL. Problemi është se për integrimin e plotë të OrioleDB me PostgreSQL kërkohen modifikime në kodin e PostgreSQL, gjë që e vështirëson zbatimin e projektit dhe thekson nevojën për modernizimin e API-t aktual të Table AM.
API Table AM nuk e imponon drejtpërdrejt mënyrën e realizimit të MVCC. Megjithatë, API Table AM dhe API Index AM bëjnë këtë supozim: çdo TID (Tuple/Rreshti Identifikues) ose indeksohet nga të gjitha indekset, ose nuk indeksohet fare. Edhe nëse Index AM ka disa referenca në një TID (p.sh., GIN), të gjitha këto referenca duhet të përputhen me të njëjtin vlerë të indeksuar.
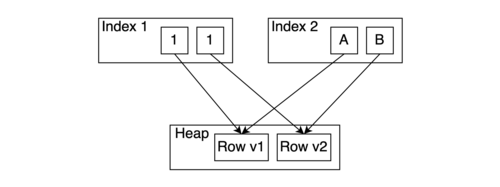
Ky kyç është kritikuar për rritjen e numrit të operacioneve të shkruar («write amplification») — nëse përditësohet një atribut i indekseve, është e nevojshme të përditësohet çdo indeks në tabelë. Nëse është e nevojshme të shfrytëzohen në mënyrë të plotë përfitimet e regjistrit UNDO ose të ndërtohet një metodë tjetër ruajtjeje pa «forcimin e shkruar» (p.sh., metoda WARM), duhet të prishim këtë supozim.
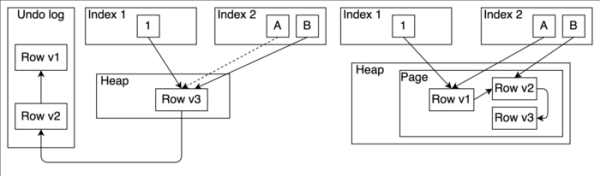
Tabela AM e cila bazohet në UNDO, e cila nuk do të dëmtojë këtë supozim, i ngjan metodës ekzistuese HOT (Heap-Only Tuples), përveç faktit se versionet e vjetra të rreshtave ruhen në regjistrin UNDO dhe nuk duhet të përshtaten në të njëjtën faqe. Por, sipas autorëve, ky avantazh nuk është i mjaftueshëm për të justifikuar ekzistencën e një Table AM të veçantë.
Kufizimet praktike të API ekzistues:
- Gjatë përditësimit të rreshtit të tabelës, indekset përditësohen sipas parimit «të gjitha ose asgjë».
- Mungesa në API të Index AM e mundësisë për fshirjen e pikës së caktuar të caktuarve. Aktualisht, caktuesit mund të fshihen nga indekset masivisht nëpërmjet metodave ambulkdelete dhe amvacuumcleanup. Përpjekja për të realizuar fshirjen e pikës së caktuar përmes këtij API do të çonte në efektivitet të ulët, pasi shumica e implementimeve aktuale duhet të skanojnë të gjithë indeksin. Për më tepër, API nuk lejon të specifikohet se cilët prej caktuesve që referohen në të njëjtin TID duhet të fshihen. Ai mund të fshijë vetëm të gjithë ata.
- Indekset aktualisht i referohen rreshtave të tabelës sipas numrit të bllokut (32 bit) dhe numrit të offset-it (16 bit). Dhe vetëm 11 bit të numrit të offset-it mund të kalohen në mënyrë të sigurueshme nga TID i tabelës në të gjitha metodat e qasjes në indeks. Në këtë rast, realizimet alternative të MVCC mund të kërkojnë të ruajnë një ngarkesë shtesë (payload) së bashku me TID. Për shembull, në OrioleDB kërkohet një ose më shumë bit për të realizuar indekset «delete-marking» ose informacionin e plotë të dukshmërisë.
Janë propozuar dy mënyra për të kapërcyer kufizimet në praktikë:
Qasja 1: API Index AM ofron mundësi për implementimin alternativ të MVCC.
Ndërsa Table AM vazhdon të përgjigjet për të gjithë komponentët e MVCC, Index AM ofron mundësitë e nevojshme për realizimin alternativ të MVCC, domethënë: ruajtjen e ngarkesës dytësore (payload) së bashku me TID, metodën e fshirjes pikës dhe madje metodën e përditësimit pikës (nëse TID në indeks nuk mund të ndryshohet, ngarkesa dytësore – mund). Përveç kësaj, pasi është e nevojshme të lejohet që shumë tuplë të indeksit të referojnë të njëjtin TID, metodat e API-t që përdoren gjatë skanimit të indeksit gjithashtu kanë nevojë për përditësim.
Qasja 2: Indekset që mbështesin MVCC.
Një alternativë do të ishte të lejohet indekset që mbështesin MVCC. Domethënë, «executor» (ose ndoshta Table AM) thjesht thërret metodat insert() dhe delete() në Index AM, ndërsa Index AM ofron mundësinë e skanimit me MVCC. Kjo do ta thjeshtonte ndjeshëm skanimin duke përdorur vetëm indekset (index-only). Madje e gjithë Table AM në këtë rast mund të bëhej një shtresë ndërmjetëse, duke ruajtur të dhënat në indeks.
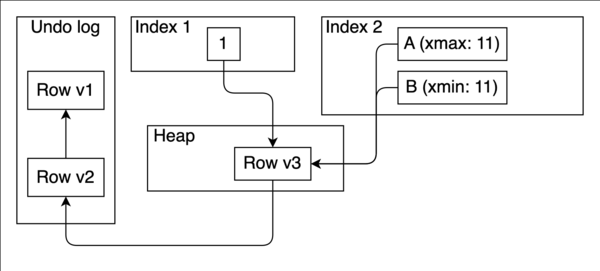
Në diagramin më poshtë është një shembull. Vlera e indeksit 2 përditësohet nga transaksioni 11 nga vlera "A" në vlerën "B". Prandaj, vlera "A" shënohet si xmax == 11, ndërsa vlera "B" shënohet si xmin == 11. Kështu, mund të skanohet indeksi 2 dhe të merren vetëm të dhënat e dukshme sipas MVCC pa verifikime të grumbullit (heap). Grumbullimi i plehrave për indeksin 2 gjithashtu mund të realizohet pa përdorimin e grumbullit.
Me implementimin e të gjitha novacioneve të renditura në API-në e metodave të aksesit për indekset, është e pamundur që të përfundojnë të gjitha indekset për të mbështetur të gjitha karakteristikat e reja më njëherë. Më realist është të lejohet disa realizime për një metodë të vetme aksesimi të indeksit. Për shembull, së bashku me B-tree-në e zakonshme, zgjatja do të jetë në gjendje të implementojë një B-tree alternativ me mbështetje për MVCC brenda indeksit dhe mbështetje për identifikuesit e shënimeve me gjatësi të rastit.
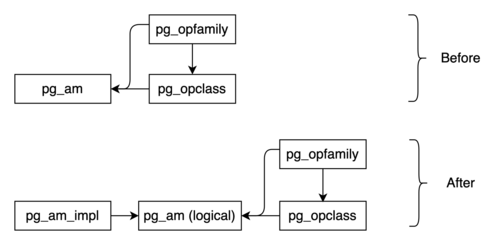
Prandaj, propozohet që të rishikohet jo vetëm API Table AM, por edhe API Index AM, i cili i ka shërbyer komunitetit PostgreSQL për shumë vite. Më shumë, propozohet ndarja e Index AM në një shtresë logjike dhe një shtresë implementimi. Kjo arkitekturë e rishikuar do të lejojë PostgreSQL të mbështesë modele të ndryshme ruajtjeje.
Burimi: opennet.ru
