

Artikulli shqyrton disa mënyra për të përcaktuar ekuacionin matematikor të vijës së regresionit të thjeshtë (dyfishtë).
Të gjitha metodat e shqyrtuara këtu për zgjidhjen e ekuacionit bazohen në metodën e katrorëve minimalë. Do të shënojmë metodat si më poshtë:
- Zgjidhja analitike
- Zbritja gradiente
- Zbritja gradiente stokastike
Për secilën nga metodat e zgjidhjes së ekuacionit të vijës, artikulli paraqet funksione të ndryshme, të cilat kryesisht ndahen në ato që janë të shkruara pa përdorimin e bibliotekës NumPy dhe ato që për kryerjen e llogarive aplikojnë NumPy. Kërkohet se përdorimi i aftë i NumPy do të lejojë të reduktojë shpenzimet për llogaritë.
I gjithë kodi i paraqitur në artikull është shkruar në gjuhën python 2.7 duke përdorur Jupyter Notebook. Kodi burimor dhe skedari me të dhënat e mostrat janë publikuar në
Artikulli është më shumë i orientuar si për fillestarët ashtu edhe për ata që kanë filluar ngadalë të studiojnë këtë pjesë shumë të gjerë në inteligjencën artificiale — mësimin e makinerive.
Për ilustrimin e materialit do të përdorim një shembull shumë të thjeshtë.
Kushtet e shembujve
Kemi pesë vlera, të cilat karakterizojnë varësinë Y nga X (Tabela nr. 1):
Tabela nr. 1 "Kushtet e shembujve"
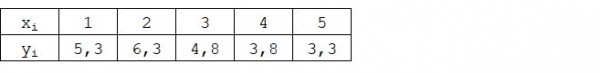
Le të mendojmë se vlerat  janë muaji i vitit, ndërsa
 është të ardhurat në këtë muaj. Në terma të tjera, të ardhurat varen nga muaji i vitit, ndërsa
 është vetëdijësimi i vetë vetëm mbi të cilin varen të ardhurat.
Shembulli është disi i dobët, si në aspektin e varësisë kushtore të të ardhurave nga muaji i vitit, ashtu edhe në aspektin e numrit të vlerave — ato janë shumë të pakta. Megjithatë, kjo thjeshtësi do të lejojë, siç thuhet, të shpjegohet, jo gjithmonë me lehtësi, materiali që është i vështirë për fillestarët. Gjithashtu, thjeshtësia e numrave do të lejojë pa shumë përpjekje të atyre që dëshirojnë të zgjidhin shembuj në "papir".
Le të supozojmë se varësia e paraqitur në shembuj mund të aproximohet mjaft mirë me një ekuacion matematikor të vijës së regresionit të thjeshtë (dyfishtë) të llojit:

ku  — është muaji kur janë arritur të ardhurat,
 — të ardhurat përkatëse për muajin,
 dhe
 — koeficientët e regresionit të vijës të vlerësuar.
Vlen të theksohet se koeficienti  shpesh quhet koeficienti këndor ose gradijenti i vijës së vlerësuar; ai përfaqëson sasinë me të cilën do të ndryshojë
 në rastin e ndryshimit të
 .
Do të jetë e qartë se detyra jonë në shembull ka për të përzgjedhur në ekuacion të tillë koeficientët.  dhe
 , ku të cilat devijimet e vlerave tona të llogaritura të të ardhurave për muajt do të jenë minimale nga përgjigjet reale, dmth, nga vlerat e paraqitura në mostër.
Metoda e katrorëve minimalë
Sipas metodës së katrorëve minimalë, devijimi duhet të llogaritet duke e ngritur atë në katror. Ky qasje shmang ripagesën e devijimeve në rastin kur ato kanë shenja të kundërta. Për shembull, nëse në një rast, devijimi është +5 (plus pesë), ndërsa në një tjetër -5 (minus pesë), atëherë shuma e devijimeve do të paguhet dhe do të jetë 0 (zero). Mund të mos e ngremë devijimin në katror, por të përdorim pronën e modulus dhe atëherë të gjitha devijimet do të jenë pozitive dhe do të akumulohet. Ne nuk do të ndalemi në këtë moment në hollësi, por thjesht do ta shënjojmë që për lehtësinë e llogaritjeve, është zakon të ngremë devijimin në katror.
Kështu duket formula, me ndihmën e së cilës do të përcaktojmë shumën më të vogël të katrorëve të devijimeve (gabimeve):

ku  — kjo është funksioni i aproksimimit të përgjigjeve reale (dmth, të ardhurat e llogaritura nga ana jonë),
 — këto janë përgjigjet reale (të ardhurat e siguruara në mostër),
 — kjo është indeksi i mostrës (numri i muajit, në të cilin ndodh përcaktimi i devijimit)
Do ta diferencojmë funksionin, do të përcaktojmë ekuacionet e pjesshëm të derivatave dhe do të jemi gati për të kaluar në zgjidhjen analitike. Por përpara se të vazhdojmë, do të bëjmë një shikim të vogël mbi atë që është diferencimi dhe do të kujtojmë kuptimin gjeometrik të derivatës.
Diferencimi
Diferencimi është operacioni për gjetjen e derivatës së funksionit.
Për çfarë i duhen derivatës? Derivata e funksionit karakterizon shpejtësinë e ndryshimit të funksionit dhe na tregon drejtimin e tij. Nëse derivata në një pikë të caktuar është pozitive, atëherë funksioni po rritet, përndryshe — funksioni po zvogëlohet. Dhe sa më e madhe të jetë vlera e derivatës në modulus, aq më e lartë është shpejtësia e ndryshimit të vlerave të funksionit, si dhe këndi i pjerrësisë së grafikës së funksionit.
Për shembull, në kushtet e sistemit të koordinatave dekartiane, vlera e derivatës në pikën M(0,0) e barabartë +25 do të thotë se në pikën e caktuar, me zhvendosjen e vlerës  dhe djathtas për një njësi të kushtueshme, vlera
 rritet me 25 njësi të kushtueshme. Në grafik, kjo duket si një kënd mjaft i pjerrët rritjeje të vlerave
 nga pika e caktuar.
Një shembull tjetër. Vlera e derivatës e barabartë me -0,1 nënkupton se kur zhvendosim  me një njësi të kushtezuar, vlera
 vjen duke rënë vetëm 0,1 njësi të kushtezuar. Në këtë rast, në grafikun e funksionit, mund të vëzhgojmë një pjerrësi të lehtë poshtë. Duke bërë një analogji me malet, është si të zbresim ngadalë nga një kodrinë të butë, në krahasim me shembullin e mëparshëm, ku duhej të ngjiteshim në maja shumë të larta:)
Kështu, duke kryer diferencimin e funksionit  për koeficientët
 dhe
 , do të përcaktojmë ekuacionet e derivatave pjesore të rendit të parë. Pas përcaktimit të ekuacioneve, ne do të marrim një sistem me dy ekuacione, duke zgjidhur të cilin do të jemi në gjendje të gjejmë vlera përkatëse të koeficientëve
 dhe
 , për të cilat vlerat e përkatshme të derivatave në pika të caktuara ndryshojnë në një sasi të vogël shumë të vogël, dhe në rastin e zgjidhjes analitike nuk ndryshohen aspak. Me fjalë të tjera, funksioni i gabimeve me koeficientët e gjetur do të arrijë minimumin, pasi vlerat e derivatave pjesore në këto pika do të jenë të barabarta me zero.
Pra, sipas rregullave të diferencimit, ekuacioni i derivatës pjesore të rendit të parë për koeficientin  do të marrë formën:

ekuacioni i derivatës pjesore të rendit të parë për  do të marrë formën:

Si rezultat, morëm një sistem ekuacionesh, i cili ka një zgjidhje analitike mjaft të thjeshtë:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Para se të zgjidhim ekuacionin, fillimisht do të ngarkojmë, do të kontrollojmë saktësinë e ngarkesës dhe do të formatizojmë të dhënat.
Ngarkimi dhe formatizimi i të dhënave
Duhet theksuar se për zgjidhjen analitike, dhe më pas për rënien e gradientit dhe rënien stohastike të gradientit, ne do të aplikojmë kodin në dy variacione: me përdorimin e bibliotekës NumPy dhe pa përdorimin e saj, prandaj do të na duhet formatizimi përkatës i të dhënave (shih kodin).
Kodi për ngarkimin dhe përpunimin e të dhënave
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Vizualizimi
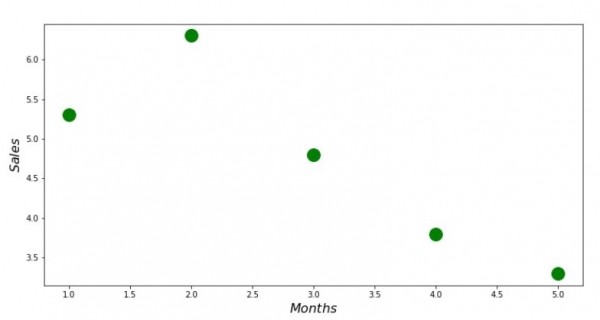
Tani, pasi së pari ngarkuam të dhënat, së dyti kontrolluam saktësinë e ngarkesës dhe në fund formatizuam të dhënat, do të kryejmë vizualizimin e parë. Shpesh për këtë përdoret metoda pairplot bibliotekës Seaborn. Në shembullin tonë, për shkak të kufizimeve të numrave nuk ka sens të përdorim bibliotekën Seaborn. Ne do të përdorim bibliotekën e zakonshme Matplotlib dhe do të shohim vetëm diagramin e shpërndarjes.
Kodi i diagramës së shpërndarjes
print 'Grafiku nr. 1 "Varësia e të ardhurave nga muaji i vitit"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.show()
Grafiku nr. 1 «Varësia e të ardhurave nga muaji i vitit»
Zgjidhja analitike
Do të përdorim mjetet më të zakonshme në python dhe do të zgjidhim sistemin e ekuacioneve:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Sipër rregullit të Cramerit do të gjejmë përcaktuesin e përgjithshëm, si dhe përcaktuesit sipas  dhe sipas
 , pas së cilës, duke e ndarë përcaktuesin sipas
 me përcaktuesin e përgjithshëm — do të gjejmë koeficientin
 , analogjikisht do të gjejmë koeficientin
 .
Kodi i zgjidhjes analitike
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Ja, çfarë kemi arritur:
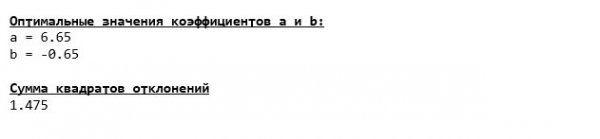
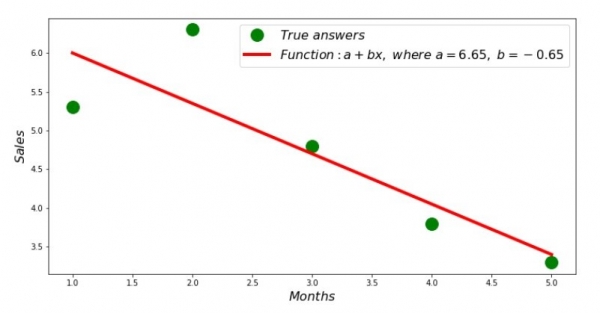
Pra, vlerat e koeficientëve janë gjetur, shumën e katrorëve të devijimeve e kemi vendosur. Do të vizatojmë në histogramin e shpërndarjes një linjë të drejtpërdrejtë në përputhje me koeficientët e gjetur.
Kodi i vijës së regresionit
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Grafiku nr. 2 «Përgjigjet e sakta dhe të llogaritura»
Mund të shohim grafikun e devijimeve për çdo muaj. Në rastin tonë, nuk do të nxjerrim ndonjë vlerë praktike të rëndësishme, por do të kënaqim kuriozitetin për sa mirë, ekuacioni i regresionit lineare të thjeshtë karakterizon varësinë e të ardhurave nga muaji i vitit.
Kodi i grafikës së devijimeve
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Grafiku nr. 3 «Devijimet, %»
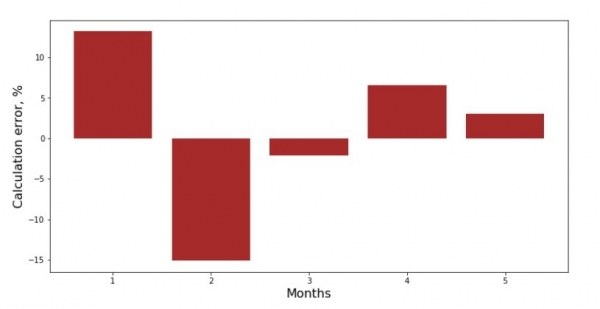
Nuk është perfekt, por ne e kemi realizuar detyrën tonë.
Do të shkruajmë një funksion që për të përcaktuar koeficientët  dhe
 përdor bibliotekën NumPy, saktësisht — do të shkruajmë dy funksione: një me përdorimin e matritës pseudo-inverse (nuk rekomandohet në praktikë, pasi procesi është i ndërlikuar dhe i pasigurt), tjetrën me përdorimin e ekuacionit matricor.
Kodi i zgjidhjes analitike (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Do të krahasojmë kohën që është shpenzuar për të përcaktuar koeficientët  dhe
 , në përputhje me 3 mënyrat e paraqitura.
Kodi për llogaritjen e kohës së llogarive
print ' 33[1m' + ' 33[4m' + "Koha e ekzekutimit për llogaritjen e koeficientëve pa përdorimin e bibliotekës NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Koha e ekzekutimit për llogaritjen e koeficientëve me përdorimin e matritës pseudo-inverse:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Koha e ekzekutimit për llogaritjen e koeficientëve me përdorimin e ekuacionit matricor:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)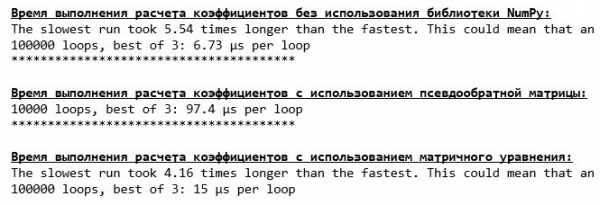
Në një sasi të vogël të dhënash, funksioni "i shkruar vetë" që gjen koeficientët përmes metodës së Cramerit del në krye.
Tani tani mund të kalojmë në mënyra të tjera për të gjetur koeficientët  dhe
 .
Zbritja gradiente
Së pari, le të përcaktojmë se çfarë është gradenti. Thjesht, gradenti është një hark që tregon drejtimin e rritjes maksimale të funksionit. Në mënyrë të ngjashme me ngjitjen në një mal, aty ku shikon gradenti, është edhe ngjitja më e pjerrët drejt majës së malit. Duke zhvilluar këtë shembull me malin, kujtojmë se në të vërtetë na nevojitet zbritja më e pjerrët, për të arritur sa më shpejt nivelin më të ulët, domethënë minimumin - vendi ku funksioni nuk rritet dhe nuk bie. Në këtë pikë, derivata do të jetë e barabartë me zero. Si rezultat, ne na nevojitet jo gradenti, por antifragjenti. Për të gjetur antifragjentin, duhet thjesht të shumojmë gradientin me -1 (minus një).
Vëmendje, funksioni mund të ketë disa minima, dhe duke zbritur në një prej tyre sipas algoritmit të propozuar më poshtë, ne nuk do të mund të gjejmë një tjetër minimum, që ndoshta ndodhet më poshtë se ai i gjeturi. Le të qëndrojmë të qetë, kjo nuk na rrezikon! Në rastin tonë, ne po e trajtojmë rastin e një minimumi të vetëm, pasi funksioni ynë  në grafikon është një parabolë e zakonshme. Dhe siç e dimë të gjithë nga kursi i matematikës në shkollë - parabola ka vetëm një minimum.
Pasi e përmendëm se për çfarë na duhej gradenti, si dhe se gradenti është një hark, dmth një vektor me koordinata të caktuara, që janë pikërisht ato koeficientët  dhe
 ne mund ta zbatojmë zbritjen gradient.
Para se të nisim, propozoj të lexojmë disa fjali rreth algoritmit të zbritjes:
- Përcaktojmë në mënyrë pseudo-rastësore koordinatat e koeficientëve
 dhe . Në shembullin tonë, ne do të përcaktojmë koeficientët afër zeros. Kjo është një praktikë e zakonshme, megjithatë për çdo rast mund të parashikohet një praktikë e ndryshme.
- Nga koordinata heqim vlerën e derivatës së rendit të parë në pikën . Pra, nëse derivata është pozitive, funksioni rritet. Si rezultat, duke hequr vlerën e derivatës, ne do të lëvizim në drejtimin e kundërt të rritjes, dmth në drejtim të zbritjes. Nëse derivata është negative, atëherë funksioni në këtë pikë po bie dhe duke hequr vlerën e derivatës ne lëvizam drejt zbritjes.
- Kryerim një operacion të ngjashëm me koordinatën : heqim vlerën e pjesshme të derivatës në pikë .
- Për të mos kaluar minimumin dhe mos u zhytur në hapësirën e largët, është e nevojshme të vendoset madhësia e hapit në drejtimin e zbritjes. Në përgjithësi, mund të shkruhet një artikull i tërë mbi se si të vendoset më mirë hapi dhe si ta ndryshojmë atë gjatë procesit të zbritjes për të ulur kostot e llogaritjeve. Por tani kemi një detyrë krejtësisht tjetër, dhe me metodën shkencore "të godasësh" ose siç thonë në gjuhën e zakonshme, me një mënyrë empirike, do të vendosim madhësinë e hapit.
- Pas përjashtimit të vlerave të derivatave nga koordinatat e dhëna dhe , marrim koordinatat e reja dhe . Ne bëjmë hapat e ardhshëm (përjashtimin) nga koordinatat e llogaritura. Dhe kështu cikli nis përsëri dhe përsëri, derisa të arrihet konvergjenca e kërkuar.
 dhe
 . Në shembullin tonë, ne do të përcaktojmë koeficientët afër zeros. Kjo është një praktikë e zakonshme, megjithatë për çdo rast mund të parashikohet një praktikë e ndryshme.
 heqim vlerën e derivatës së rendit të parë në pikën
 . Pra, nëse derivata është pozitive, funksioni rritet. Si rezultat, duke hequr vlerën e derivatës, ne do të lëvizim në drejtimin e kundërt të rritjes, dmth në drejtim të zbritjes. Nëse derivata është negative, atëherë funksioni në këtë pikë po bie dhe duke hequr vlerën e derivatës ne lëvizam drejt zbritjes.
 : heqim vlerën e pjesshme të derivatës në pikë
 .
 dhe
 , marrim koordinatat e reja
 dhe
 . Ne bëjmë hapat e ardhshëm (përjashtimin) nga koordinatat e llogaritura. Dhe kështu cikli nis përsëri dhe përsëri, derisa të arrihet konvergjenca e kërkuar.
E gjithë! Tani jemi gati për të shkuar në kërkim të kanionit më të thellë të Fosas Mariane. Le ta fillojmë.
Kodi për zbritjen gradient
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print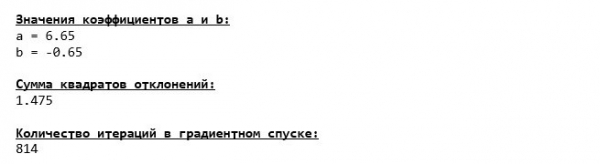
Ne u zhytëm në fundin e Fosas Mariane dhe aty e gjetëm të njëjtat vlera të koeficientëve  dhe
 , që natyrisht ishte e pritshme.
Do të bëjmë një zhytje tjetër, por këtë herë, përbërësit e aparatit tonë të thellë do të jenë teknologji të tjera, pikërisht biblioteka NumPy.
Kodi për zbritjen gradient (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print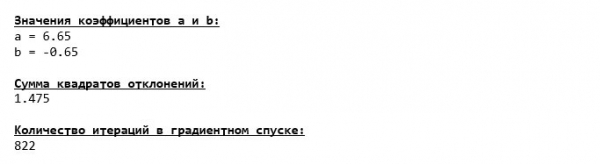
Vlerat e koeficientëve  dhe
 janë të pandryshueshme.
Le të shohim se si ndryshonte gabimi gjatë zbritjes gradient, dmth si ndryshonte shuma e katrorëve të devijimeve me çdo hap.
Kodi për grafik të shumës së katrorëve të devijimeve
print 'Grafiku№4 "Shuma e katrorëve të devijimeve hap pas hapi"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Hapat (Iteracion)', size=16)
plt.ylabel('Shuma e katrorëve të devijimeve', size=16)
plt.show()
Grafiku №4 «Shuma e katrorëve të devijimeve gjatë zbritjes gradient»
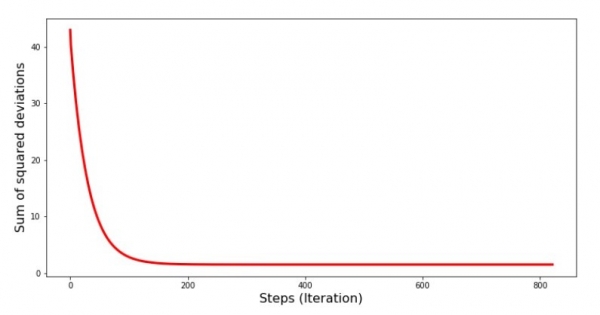
Në grafik shohim se me çdo hap gabimi zvogëlohet, dhe pas një numri të caktuar iteracionesh, shohim një vijë thuajse horizontale.
Në fund, le të vlerësojmë diferencën në kohën e ekzekutimit të kodit:
Kodi për përcaktimin e kohës së llogaritjes së zbritjes gradient
print ' 33[1m' + ' 33[4m' + "Koha e ekzekutimit të zbrazjes gradient me përdorimin e bibliotekës NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Koha e ekzekutimit të zbrazjes gradient pa përdorimin e bibliotekës NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)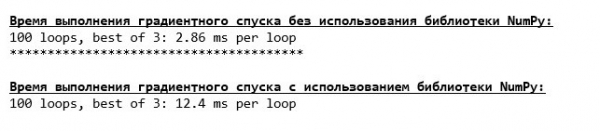
Ndoshta po bëjmë diçka të gabuar, por sërish funksioni i thjeshtë "i shkruar vetë", që nuk përdor bibliotekën NumPy parashikon në kohën e ekzekutimit funksionin që përdor bibliotekën NumPy.
Por ne nuk qëndrojmë, por lëvizim drejt studimit të një mënyre tjetër interesante për zgjidhjen e barazimeve të regresionit linear të thjeshtë. Mirë se erdhët!
Zbritja gradiente stokastike
Për të kuptuar më shpejt parimin e punës së zbrazjes gradient të stohastikës, është më mirë të përcaktojmë dallimet e saj nga zbrazja gradient normale. Ne, në rastin e zbrazjes gradient, në ekuacionet e deri nënvepruar  dhe
 përdorim shumën e vlerave të të gjitha karakteristikave dhe përgjigjeve reale që disponohen në mostër (domethënë shumën e të gjitha
 dhe
 ). Në zbrazjen gradient të stohastikës nuk do të përdorim të gjitha vlerat që disponohen në mostër, por në vend të kësaj do të zgjedhim në mënyrë pseudokasual një indeks mostre dhe do të përdorim vlerat e saj.
Për shembull, nëse indeksi përcaktohet me numrin 3 (tri), ne marrim vlerat  dhe
 , pastaj i zëvendësojmë vlerat në ekuacionet e derivatave dhe përcaktojmë koordinatat e reja. Më pas, pas përcaktimit të koordinatave, përsëri përcaktojmë në mënyrë pseudokasual indeksin e mostrës, zëvendësojmë vlerat që përkojnë me indekse në ekuacionet e pjesshme të derivatave, përsëri përcaktojmë koordinatat
 dhe
 etj. deri në përfundimin e konvergjencës. Në pamje të parë, mund të duket si mund të funksionojë kjo, megjithatë funksionon. Megjithatë, është e rëndësishme të theksohet se jo me çdo hap zvogëlohet gabimi, por tendenca sigurisht ekziston.
Cilat janë avantazhet e zbrazjes gradient të stohastikës në raport me atë normale? Në rastin kur madhësia e mostrës është shumë e madhe dhe matet në dhjetëra mijëra vlera, është shumë më e thjeshtë të trajtohet, për shembull një mijë të rastësishme prej tyre, sesa e gjithë mostra. Atëherë fillon zbrazja gradient e stohastikës. Në rastin tonë natyrisht nuk do të vërejmë ndonjë ndryshim të madh.
Shikojmë kodin.
Kodi për shkallëzimin stohastik të gradientit
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])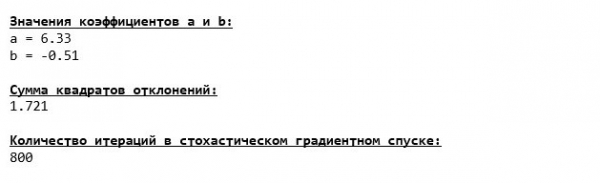
Të shohim me kujdes koeficientët dhe të kapim veten duke u pyetur 'Si është e mundur?'. Na rezultuan vlera të tjera për koeficientët  dhe
 . Ndoshta shkalla stohastike e gradientit ka gjetur parametra më optimalë për ekuacionin? Fatkeqësisht, jo. Mjafton të shohim shumën e katrorëve të devijimeve dhe të shohim se me vlerat e reja të koeficientëve, gabimi është më i madh. Mos u ngut të dëshpërohesh. Le të ndërtojmë një grafik të ndryshimit të gabimit.
Kodi për grafikun e shumës së katrorëve të devijimeve në shkallëzimin stohastik të gradientit
print 'Grafiku №5 "Shuma e katrorëve të devijimeve hap pas hapi"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Hapat (Iteracioni)', size=16)
plt.ylabel('Shuma e katrorëve të devijimeve', size=16)
plt.show()
Grafiku №5 «Shuma e katrorëve të devijimeve në shkallëzimin stohastik të gradientit»
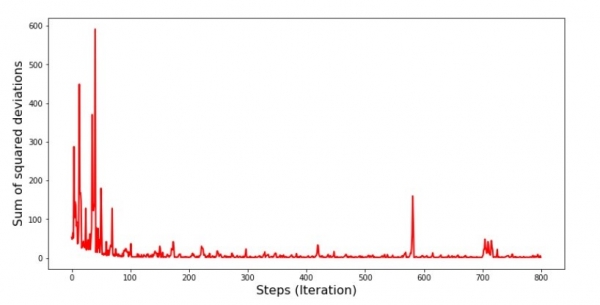
Pas shikimit të grafikut, gjithçka vendoset në vendin e vet dhe tani do të rregullojmë gjithçka.
Pra, çfarë ndodhi? Ndodhi e siguiente. Kur zgjedhim një muaj rastësisht, atëherë për muajin e zgjedhur algoritmi ynë synon të reduktojë gabimin në llogaritjen e të ardhurave. Më pas, zgjedhim një muaj tjetër dhe përsërisim llogaritjen, por tani i zvogëlojmë gabimin për muajin e dytë të zgjedhur. Dhe tani të kujtojmë se dy muajt tanë të parë devijojnë ndjeshëm nga linja e ekuacionit të regresionit të thjeshtë të linjës. Kjo do të thotë se kur zgjedhëm cilindo prej këtyre dy muajve, duke reduktuar gabimin e secilit prej tyre, algoritmi ynë rrit ndjeshëm gabimin për të gjithë mostrën. Çfarë duhet bërë? Përgjigja është e thjeshtë: duhet të zvogëlojmë hapin e shkallëzimit. Sepse duke e zvogëluar hapin e shkallëzimit, gabimi gjithashtu do të ndalojë të 'këndojë' lart e poshtë. Në të vërtetë, gabimi do të 'këndojë' por jo aq shpejt :) Le të kontrollojmë.
Kodi për të nisur SGD me hap më të vogël
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()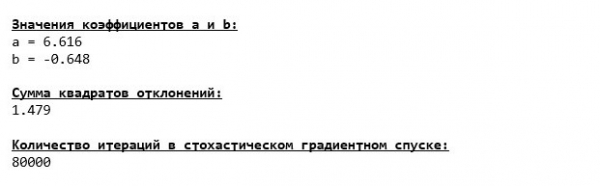
Grafiku №6 «Shuma e katrorëve të devijimeve në shkallëzimin stohastik të gradientit (80 mijë hapa)»
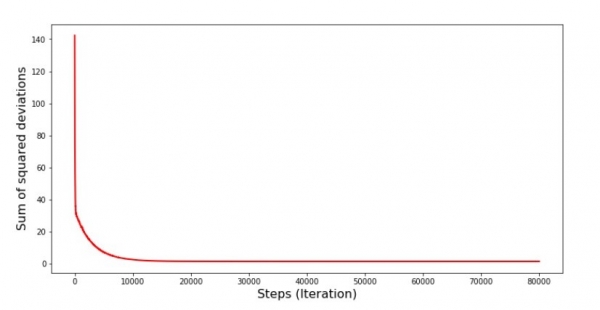
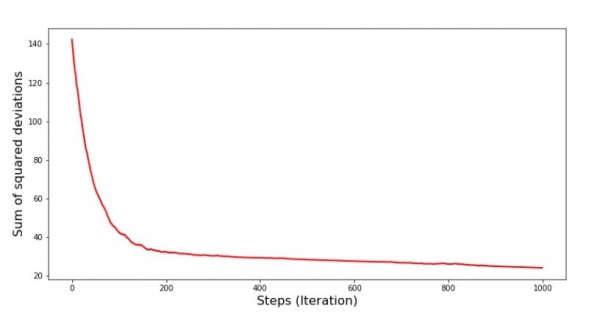
Vlerat e koeficientëve janë përmirësuar, por ende nuk janë ideale. Hipotetikisht, kjo mund të rregullohet kështu. Zgjedhim, për shembull, në 1000 iteracionet e fundit vlerat e koeficientëve me të cilat u bë një gabim minimal. Megjithatë, për këtë na duhet të regjistrojmë edhe vetë vlerat e koeficientëve. Nuk do ta bëjmë këtë, por do të përqendrohemi në grafik. Ai duket i lëmuar, dhe gabimi sikur po zvogëlohet njëtrajtshëm. Në të vërtetë, nuk është kështu. Le të shikojmë 1000 iteracionet e para dhe t’i krahasojmë ato me ato të fundit.
Kodi për graph-in e SGD (1000 hapet e para)
print 'Grafiku Nr. 7 "Shuma e katrorëve të devijimeve hap pas hapi. 1000 iteracionet e para"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Hapat (Iteracioni)', size=16)
plt.ylabel('Shuma e katrorëve të devijimeve', size=16)
plt.show()

print 'Grafiku Nr. 7 "Shuma e katrorëve të devijimeve hap pas hapi. 1000 iteracionet e fundit"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Hapat (Iteracioni)', size=16)
plt.ylabel('Shuma e katrorëve të devijimeve', size=16)
plt.show()
Grafiku Nr. 7 "Shuma e katrorëve të devijimeve SGD (1000 hapet e para)"
Grafiku Nr. 8 "Shuma e katrorëve të devijimeve SGD (1000 hapet e fundit)"
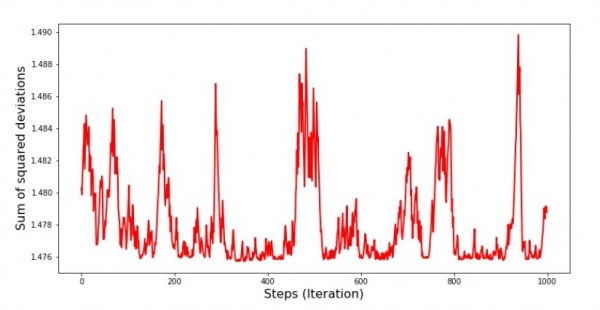
Në fillim të zbritjes ne vërejmë një zvogëlim mjaft të njëtrajtshëm dhe të pjerrët të gabimit. Në iteracionet e fundit ne shohim se gabimi lëvizin rreth vlerës 1,475 dhe në disa momente madje arrin këtë vlerë optimale, por më pas gjithsesi rritet... Të përsëris, mund të regjistrojmë vlerat e koeficientëve  dhe
 , dhe pastaj të zgjedhim ato, kur gabimi është minimal. Megjithatë, kemi një problem më serioz: na duhej të bënim 80,000 hapa (shihni kodin), për të marrë vlera që janë afër optimumit. Kjo, tashmë në kundërshtim me idenë e kursimit të kohës së llogaritjeve në zbritjen stohastike të gradientit krahasuar me gradientin. Çfarë mund të rregullojmë dhe përmirësojmë? Nuk është e vështirë të vëresh se në iteracionet e para po eci drejt poshtë dhe, prandaj, na duhen hapat e mëdhenj në iteracionet e para dhe ndërsa përparojmë ta zvogëlojmë hapin. Nuk do ta bëjmë këtë në këtë artikull — tashmë është zgjatur. Ata që dëshirojnë mund të mendojnë edhe vetë se si ta bëjnë këtë, nuk është e vështirë 🙂
Tani do të kryejmë zbritjen stohastike të gradientit, duke përdorur bibliotekën NumPy (dhe nuk do të biem mbi gurët që i kemi identifikuar më parë)
Kodi për shkallët stohastike të gradienteve (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print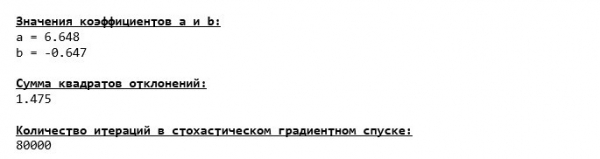
Vlerat dolën pothuajse të njëjta si në shkallët pa përdorim NumPy. Megjithatë, kjo është logjike.
Do të mësojmë se sa kohë kanë marrë shkallët stohastike të gradienteve.
Kodi për përcaktimin e kohës së llogaritjes së SGD (80,000 hapa)
print ' 33[1m' + ' 33[4m' +
"Kohëzgjatja e zbatimit të shkallës stohastike të gradienteve pa përdorim të bibliotekës NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Kohëzgjatja e zbatimit të shkallës stohastike të gradienteve me përdorim të bibliotekës NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)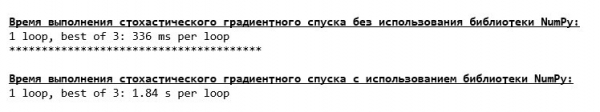
Sa më thellë në pyll, aq më të errëta janë re: sërish formula 'e shkruar vetë' tregon rezultat më të mirë. Të gjitha këto na japin mendime se duhet të ekzistojnë edhe mënyra më të rafinuara të përdorimit të bibliotekës NumPy, të cilat vërtet përshpejtojnë operacionet llogaritëse. Në këtë artikull nuk do të mësojmë për to. Do të ketë për çfarë të mendojmë gjatë kohës së lirë :)
Përmbledhje
Para se të përmbledhim, dëshiroj të përgjigjem në pyetjen që ndoshta ka lindur te lexuesi ynë të dashur. Për çfarë, në të vërtetë, janë këto 'mundime' me shkallët, pse duhet të ngjitemi lart e poshtë (pjesërisht poshtë), për të gjetur luginën e dëshiruar, kur në duar kemi një mjet aq të fuqishëm dhe të thjeshtë, siç është zgjidhja analitike, e cila na teleporton menjëherë në vendin e duhur?
Përgjigjja për këtë pyetje është evidente. Më parë diskutuam një shembull shumë të thjeshtë, në të cilin përgjigjja e vërtetë  varet nga një veçori
 . Në jetë të tilla ngjarje nuk ndodhin shpesh, prandaj le të supozojmë se kemi 2, 30, 50 ose më shumë veçori. Të shtojmë për këtë mijëra, madje edhe dhjetëra mijëra vlera për secilën veçori. Në këtë rast, zgjidhja analitike mund të mos përballojë testin dhe të dështojë. Nga ana tjetër, shkalla e gradienteve dhe variacionet e saj do të na afrojnë ngadalë, por me siguri drejt qëllimit — minimumit të funksionit. Dhe për sa i përket shpejtësisë, mos u shqetësoni — ne me siguri do të shqyrtojmë përsëri mënyrat që na lejojnë të caktuar dhe rregullojmë gjatësinë e hapit (dmth. shpejtësinë).
Dhe tani, përmbledhja e shkurtër.
Së pari, shpresoj që materiali në këtë artikull do të ndihmojë fillestarët e "data scientist" në kuptimin e mënyrës se si të zgjidhin ekuacionet e regresionit linear të thjeshtë (dhe jo vetëm).
Së dyti, ne shqyrtuam disa mënyra për të zgjidhur ekuacionin. Tani, në varësi të situatës, mund të zgjedhim atë që përshtatet më mirë për zgjidhjen e detyrës në fjalë.
Së treti, ne pamë fuqinë e parametrave të tjerë të konfigurimit, sidomos gjatë hapit të gradienteve. Ky parametr s'ka pse të neglizhohet. Siç u theksua më sipër, për të reduktuar kostot e llogaritjeve, duhet të ndryshohet gjatësia e hapit gjatë procesit.
Së katërti, në rastin tonë, funksionet 'të shkruara vetë' treguan rezultatet më të mira në kohë për llogaritje. Ka të ngjarë që kjo lidhet me përdorimin jo shumë profesional të mundësive që ofron biblioteka. NumPy. Por në çdo rast, përfundimi është i qartë. Nga njëra anë, ndonjëherë është e nevojshme të vënë në dyshim opinionet e njohura, dhe nga ana tjetër — nuk është gjithmonë e nevojshme të komplikohet gjithçka — përkundrazi, ndonjëherë një mënyrë më e thjeshtë rezulton të jetë më efektive për zgjidhjen e detyrës. Dhe pasi që qëllimi ynë ishte të shqyrtonim tre qasje në zgjidhjen e ekuacionit të regresionit linear të thjeshtë, përdorimi i funksioneve 'të shkruara vetë' ishte plotësisht i mjaftueshëm.
Literatura (ose diçka e tillë)
1. Regresioni linear
2. Metoda e katrorëve më të vegjël
3. Derivata
4. Gradienti
5. Nitja e gradientit
6. Biblioteka NumPy
Burimi: habr.com
