

Në këtë artikull do të flasim për varësitë funksionale në bazat e të dhënave — çfarë janë, ku përdoren dhe cilat algorithme ekzistojnë për t'i gjetur ato.
Do ta shqyrtojmë varësinë funksionale në kontekstin e bazave të të dhënave relacional. Nëse flasim shumë thjesht, në këto baza të dhënash, informacionet ruhen në formën e tabelave. Më pas, do të përdorim konceptet afër të cilat në teorinë strikte relacionale nuk janë të ndërrueshme: tabelën vetë do ta quajmë relacion, kolumnat — atributet (grupi i tyre — skema e relacionit), dhe grupin e vlerave të rreshtit në një nëngrup të Attributeve — tupiz.
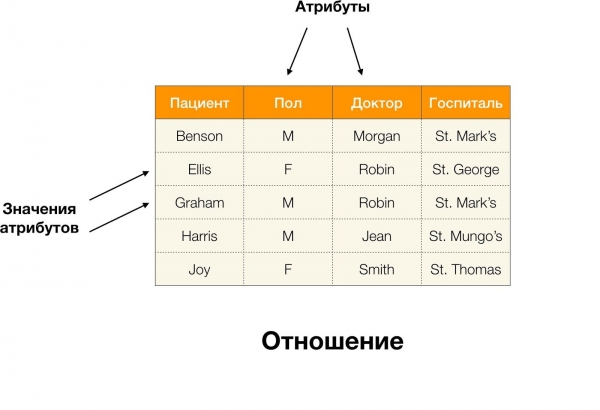
Për shembull, në tabelën e mësipërme, (Benson, M, M organ) është një tupiz mbi atributet (Pacienti, Gjinia, Mjeku).
Më formalisht, kjo shkruhet në mënyrën e mëposhtme:  [Pacienti, Gjinia, Mjeku] = (Benson, M, M organ).
Tani mund të futim konceptin e varësisë funksionale (VF):
Definicioni 1. Relacioni R plotëson VF X → Y (ku X, Y ⊆ R) atëherë dhe vetëm atëherë kur për çdo tupiz  ,
 ∈ R është e vërtetë: nëse
 [X] =
 [X], atëherë
 [Y] =
 [Y]. Në këtë rast, thuhet se X (determinant, ose grupi përcaktues i atributeve) përcakton funksionalisht Y (grupi i varur).
Me fjalë të tjera, pranimi i VF X → Y do të thotë se nëse kemi dy tupizë në R dhe ato përputhen mbi atributet X, atëherë ato do të përputhen edhe mbi atributet Y.
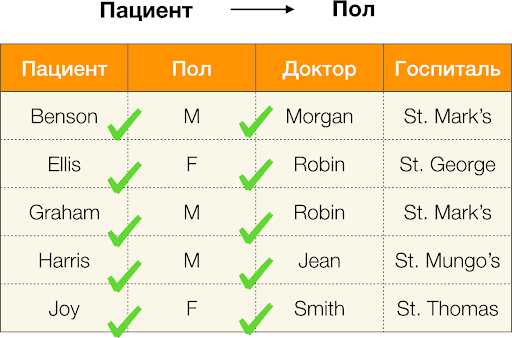
Tani, në rend. Le të shqyrtojmë atributet Pacienti dhe Gjinia për të cilat duam të dimë nëse ekzistojnë varësi midis tyre apo jo. Për këtë grup atributesh mund të ekzistojnë varësitë e mëposhtme:
- Pacienti → Gjinia
- Gjinia → Pacienti
Sipas definicionit të mësipërm, për të mbajtur varësinë e parë, çdo vlerë unike të kolumnës Pacienti duhet t'i korrespondonte vetëm një vlerë të kolumnës Gjinia. Dhe për tabelën-shembull, kjo është vërtet kështu. Megjithatë, në anën tjetër, kjo nuk funksionon, domethënë varësia e dytë nuk përmbushet, dhe atributi Gjinia nuk është një determinant për Pacientin. Po ashtu, nëse marrim varësinë Mjeku → Pacienti, mund të vërejmë se ajo shkelet, pasi vlera Robin në këtë atribut ka disa vlera të ndryshme — Ellis dhe Graham.
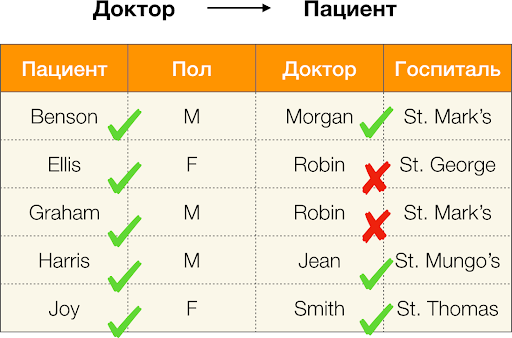
Kështu, varësitë funksionale lejojnë përcaktimin e lidhjeve ekzistuese mes grupeve të atributeve të tabelës. Prandaj, nga tani e tutje, ne do të shqyrtojmë lidhjet më interesante, konkretisht ato X → Y, të cilat janë:
- jo triviale, domethënë ana e djathtë e varësisë nuk është nëngrup i majtës (Y ̸⊆ X);
- minimale, domethënë nuk ka një varësi të tillë Z → Y, që Z ⊂ X.
Varësitë e shqyrtuara deri tani ishin të rrepta, domethënë nuk parashikonin asnjë shkelje në tabelë, por përveç tyre ka edhe të tilla që lejojnë disa mosmarrëveshje mes vlerave të turmave. Këto varësi nxirren në një klasë të veçantë, quhen afërsisht dhe u lejohet të shkelin në një numër të caktuar turmash. Ky numër rregullohet nga treguesi i gabimit maksimal emax. Për shembull, pesha e gabimit  = 0.01 mund të nënkuptojë se varësia mund të shkelet në 1% të turmave ekzistuese në grupin e atributeve të shqyrtuara. Domethënë për 1000 regjistrime, maksimumi 10 turma mund të shkelin FZ. Ne do të shqyrtojmë një metrikë pak më të ndryshme, të bazuar në vlerat në çift të turmave që po krahasohen. Për varësinë X → Y në raport r ajo llogaritet kështu:

Të llogarisim gabimin për Mjeku → Pacienti nga shembulli më sipër. Kemi dy turma, vlerat e të cilave ndryshojnë në atributin Pacienti, por bien dakord në Doktorin:  [Doktor, Pacienti] = (Robin, Ellis) dhe
 [Doktor, Pacienti] = (Robin, Graham). Duke ndjekur definicionin e gabimit, ne duhet të marrim parasysh të gjitha çiftet konfliktuese, dhe kështu do të kemi dy: (
 ,
 ) dhe invertimi i saj (
 ,
 ). Të futim në formulë dhe të marrim:

Tani le të përpiqemi të përgjigjemi në pyetjen: "Pse na duhen këto të gjitha?" Në të vërtetë, FZ-të janë të ndryshme. Lloji i parë është ai varësi që përcaktohet nga administratori në fazën e projektimit të bazës së të dhënave. Zakonisht janë pak, ato janë të rrepta, dhe përdorimi kryesor — normalizimi i të dhënave dhe dizajni i skemës së raportit.
Lloji i dytë është varësitë, të cilat paraqesin të dhëna "të fshehura" dhe lidhje të panjohura më parë midis atributeve. Kjo do të thotë se për këto varësi nuk mendohej në momentin e projektimit dhe ato gjenden tashmë për një grup të dhënash të caktuar, në mënyrë që më pas, mbi bazën e shumë varësive të zbuluara, të bëhen disa përfundime mbi informacionin e ruajtur. Pikërisht me këto varësi ne punojmë. Një fushë e tërë e datamining merret me to, me teknika të ndryshme kërkimi dhe algoritme të ndërtuara mbi to. Le të shqyrtojmë se si mund të jenë të dobishme varësitë funksionale të gjetura (të sakta ose të afërta) në disa të dhëna.
Sot, ndër fushat kryesore të aplikimit të varësive, spikasin pastrimi i të dhënave. Ky proces përfshin zhvillimin e proceseve për identifikimin e "të dhënave të ndotura" me pastrimin e tyre të mëvonshëm. Disa përfaqësues të shquar të "të dhënave të ndotura" janë dublikatet, gabimet në të dhëna apo shtypjet e gabuara, vlerat e humbura, të dhënat e vjetra, hapësirat e tepërta dhe kështu me radhë.
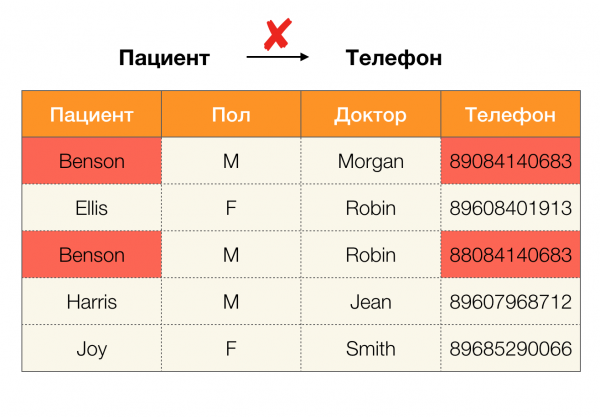
Shembulli i një gabimi në të dhëna:
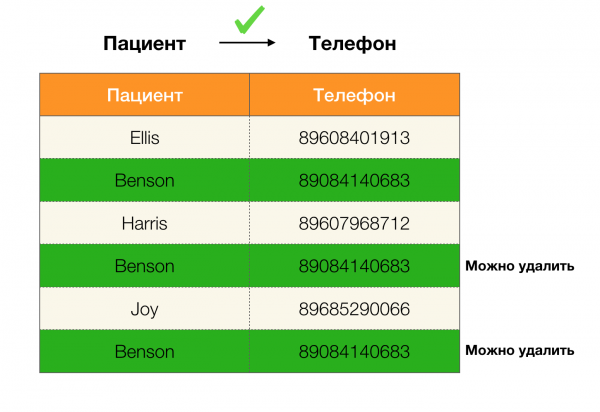
Shembulli i dublikateve në të dhëna:
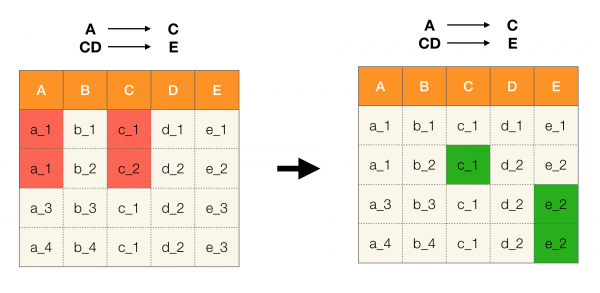
Për shembull, ne kemi një tabelë dhe një grup rregullash funksionale që duhet të realizohen. Pastrimi i të dhënave në këtë rast nënkupton të ndryshojmë të dhënat në mënyrë që rregullat funksionale të bëhen të sakta. Në këtë rast, numri i modifikimeve duhet të jetë minimal (për këtë procedurë ekzistojnë algoritme të caktuara, për të cilat nuk do të fokusohemi në këtë artikull). Më poshtë është një shembull i tillë i transformimit të të dhënave. Majtas është marrëdhënia fillestare, në të cilën, sigurisht, nuk përmbushen rregullat e nevojshme (me ngjyrë të kuqe është theksuar një shembull i shkeljes së një nga rregullave). Nga ana e djathtë është paraqitur marrëdhënia e përditësuar, në të cilën kutitë e gjelbërta tregojnë vlerat e modifikuara. Pas kryerjes së kësaj procedure, varësitë e nevojshme u mbajtën.
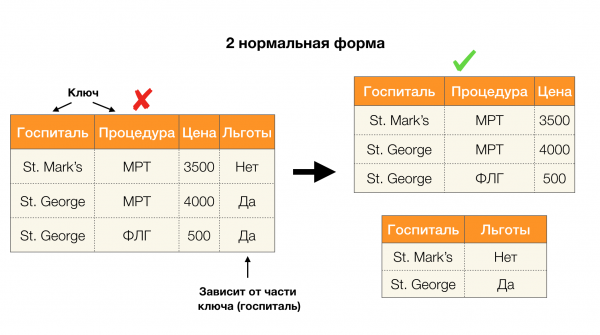
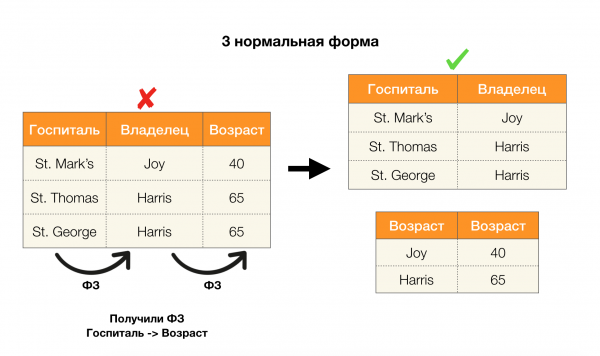
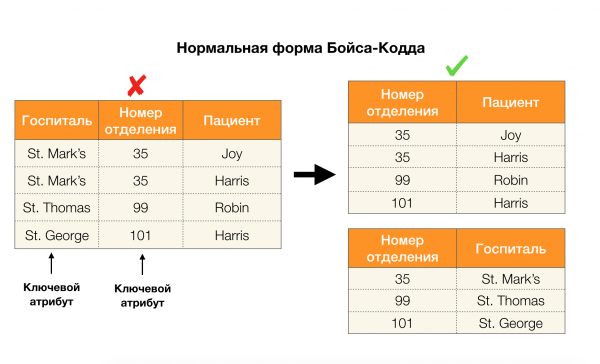
Një fushë tjetër e zakonshme përdorimi është dizajni i bazës së të dhënave. Këtu është e rëndësishme të përmendim format normale dhe normalizimin. Normalizimi është procesi i përshtatjes së një relacioni në përputhje me një set kërkesash, secila prej të cilave përcaktohet në mënyrë të veçantë nga një format normal. Nuk do të detajojmë kërkesat e formave të ndryshme normale (kjo bëhet në çdo libër për kursin e DB për fillestarët), por thjesht do të theksojmë se secila prej tyre përdor në mënyrë të veçantë konceptin e varësive funksionale. Në fund të fundit, varësitë funksionale (VF) janë në thelb kufizime të integritetit që merren parasysh gjatë projektimit të bazës së të dhënave (në kontekstin e kësaj detyre, VF ndonjëherë quhen superçelësa).
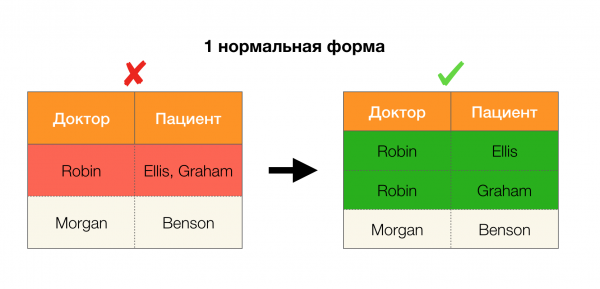
Le të shqyrtojmë aplikimin e tyre për katër forma normale në figurën më poshtë. Të kujtojmë se forma normale e Boyce-Codd është më e rreptë se forma e tretë, por më pak e rreptë se forma e katërt. Formën e fundit nuk po e shqyrtojmë ende, pasi për ta vënë në praktikë nevojitet kuptimi i varësive shumëshkallëshe, të cilat në këtë artikull nuk janë të interesit tonë.
Një tjetër fushë ku varësitë kanë gjetur përdorim është ulja e dimensionalitetit të hapësirës së veçorive në probleme të tilla si ndërtimi i klasifikuesit naive bayesian, identifikimi i veçorive të rëndësishme dhe riparametrizimi i modelit regresiv. Në artikujt origjinalë, kjo detyrë quhet përcaktimi i veçorive të tepërta (feature redundancy) dhe të përputhshme (feature relevancy) [5, 6], dhe zgjidhet me përdorimin aktiv të koncepteve të bazës së të dhënave. Me shfaqjen e këtyre veprave, mund të flasim për një kërkesë për zgjidhje që lejojnë bashkimin e bazës së të dhënave, analizës dhe realizimin e problemeve të mësipërme të optimizimit në një mjet të vetëm [7, 8, 9].
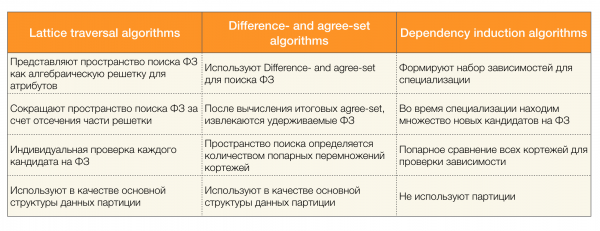
Për të kërkuar varësitë funksionale në një grup të dhënash ekzistojnë shumë algoritma (si të rinj, ashtu edhe të vjetër). Këta algoritma mund të ndahen në tre grupe:
- Algoritmat që përdorin kalimin përmes rrjeteve algebraike (Lattice traversal algorithms)
- Algoritmat që bazohen në kërkimin e vlerave të pajtueshme (Difference- and agree-set algorithms)
- Algoritmat që bazohen në krahasime çift pas çifti (Dependency induction algorithms)
Një përshkrim të shkurtër të çdo lloji algoritmi është paraqitur në tabelën më poshtë:
Më shumë për këtë klasifikim mund të lexoni [4]. Më poshtë janë paraqitur shembuj algoritmesh për çdo një nga llojet:
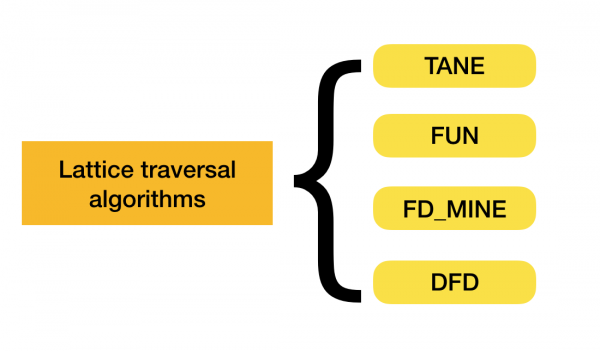
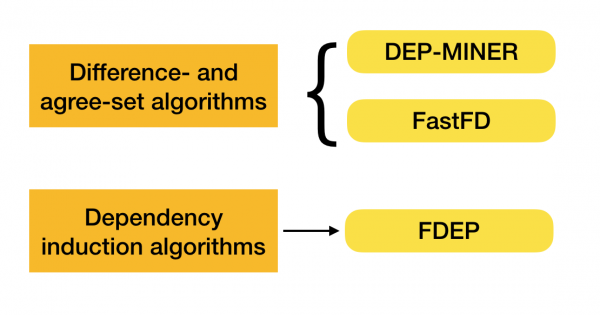
Aktualisht po shfaqen algoritma të rinj që kombinon disa qasje për të gjetur varësitë funksionale. Shembuj të tillë algoritmash janë Pyro [2] dhe HyFD [3]. Analiza e funksionimit të tyre parashikohet në artikujt e ardhshëm të këtij cikli. Në këtë artikull, do të shqyrtojmë vetëm konceptet kryesore dhe lemën që nevojiten për të kuptuar teknikat e identifikimit të varësive.
Të fillojmë me të thjeshtën — diferencë dhe set të ra, të përdorura në llojin e dytë të algoritmave. Seti i diferencës përfaqëson një grup të tupleve që nuk korrespondojnë me vlerat, ndërsa seti i ra është përkundrazi — tuple që korrespondojnë me vlerat. Duhet të theksohet se në këtë rast ne shqyrtojmë vetëm pjesën e majtë të varësisë.
Një koncept tjetër të rëndësishëm që u përmend më lart është rrjeti algebraik. Duke qenë se shumë algoritma moderne operojnë me këtë koncept, na nevojitet një ide se çfarë është ai.
Për të futur konceptin e rrjetit, nevojitet një përkufizim i grupit të pjesërisht renditur (ose grup i pjesërisht renditur, shkurtimisht — poset).
Përkufizimi 2. Një grup S quhet i pjesërisht renditur nga një marrëdhënie binare ⩽, nëse për çdo a, b, c ∈ S janë të vlefshme këto prona:
- Refleksiviteti, pra a ⩽ a
- Antisimetri, pra, nëse a ⩽ b dhe b ⩽ a, atëherë a = b
- Transitiviteti, pra për a ⩽ b dhe b ⩽ c, duhet që a ⩽ c
Kjo marrëdhënie quhet marrëdhënie (jo-strikt) e renditjes së pjesshme, dhe grupi vetë është një grup i renditur pjesërisht. Shenja formale: ⟨S, ⩽⟩.
Si një shembull të thjeshtë të një grupi të renditur pjesërisht, mund të marrim grupin e të gjithë numrave natyrorë N me marrëdhënien e zakonshme të rendit ⩽. Nuk është e vështirë të verifikohet se të gjitha aksiomat e nevojshme përmbushen.
Një shembull më informues. Le të shqyrtojmë grupin e të gjitha nëngrupeve {1, 2, 3}, të renditura nga marrëdhënia e përfshirjes ⊆. Vërtet, kjo marrëdhënie përmbush të gjitha kushtet e rendit të pjesshëm, prandaj ⟨P ({1, 2, 3}), ⊆⟩ — është një grup i renditur pjesërisht. Në figurën më poshtë është përshkruar struktura e këtij grupi: nëse nga një element mund të arrihet me arrow në një tjetër element, atëherë ata janë në marrëdhënie rendit.
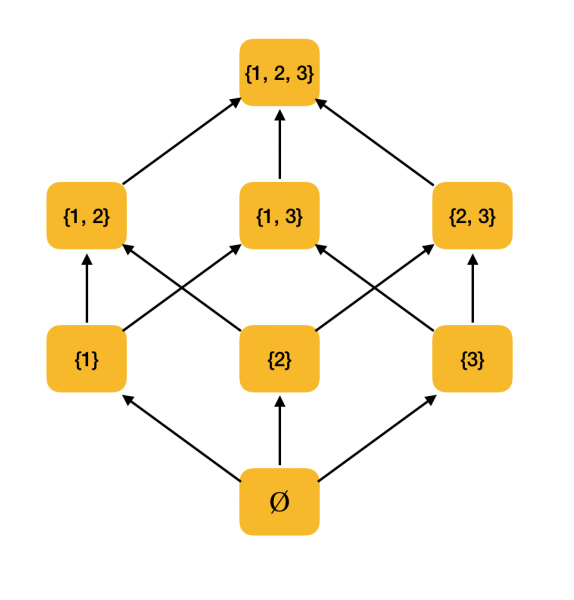
Na nevojiten edhe dy përkufizime të thjeshta nga fusha e matematikës — supremum (supremum) dhe infimum (infimum).
Përkufizimi 3. Le të supozojmë ⟨S, ⩽⟩ — një grup të pjesërisht renditur, A ⊆ S. Kufiri i sipërm i A është një element u ∈ S, e tillë që për çdo x ∈ S: x ⩽ u. Le të konsiderojmë U — grupin e të gjithë kufijve të sipërm të S. Nëse në U ekziston një element më i vogël, atëherë ai quhet supremum dhe shënohet si sup A.
Në mënyrë të ngjashme, prezantohet koncepti i kufirit të saktë të poshtëm.
Përkufizimi 4. Le të supozojmë ⟨S, ⩽⟩ — një grup të pjesërisht renditur, A ⊆ S. Kufiri i poshtëm i A është një element l ∈ S, e tillë që për çdo x ∈ S: l ⩽ x. Le të konsiderojmë L — grupin e të gjithë kufijve të poshtëm të S. Nëse në L ekziston një element të madh, atëherë ai quhet infimum dhe shënohet si inf A.
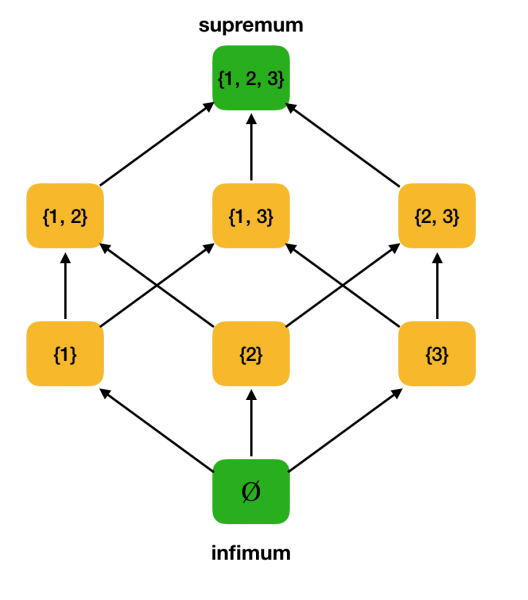
Të shqyrtojmë si shembull grupin e sipërm të renditur ⟨P ({1, 2, 3}), ⊆⟩ dhe të gjejmë në të supremum dhe infimum:
Tani mund të formulojmë përkufizimin e grupit algebraik.
Përkufizimi 5. Le të supozojmë ⟨P, ⩽⟩ — një grup të pjesërisht renditur, i tillë që çdo nëngrup dy-elementësh ka kufij të saktë të sipërm dhe të poshtëm. Atëherë P quhet grup algebraik. Në këtë rast, sup{x, y} shënohet si x ∨ y, dhe inf {x, y} — si x ∧ y.
Le të kontrollojmë se shembulli ynë pune ⟨P ({1, 2, 3}), ⊆⟩ është grup. Në të vërtetë, për çdo a, b ∈ P ({1, 2, 3}), a∨b = a∪b, dhe a∧b = a∩b. Për shembull, le të shqyrtojmë grupet {1, 2} dhe {1, 3} dhe të gjejmë infimum dhe supremum të tyre. Nëse i ndërpresim, do të marrim grupin {1}, i cili do të jetë infimumi. Supremumi do të marrim duke i bashkuar — {1, 2, 3}.
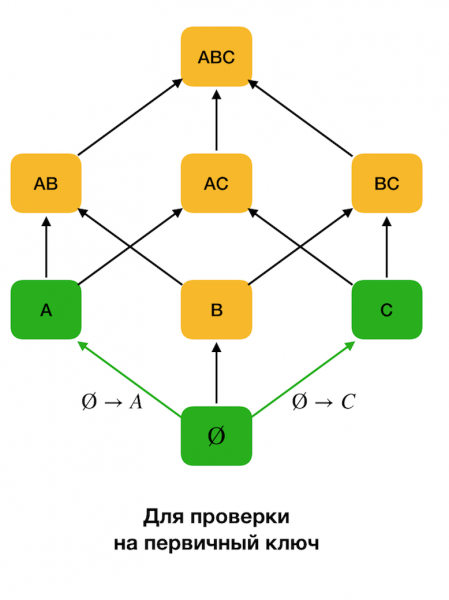
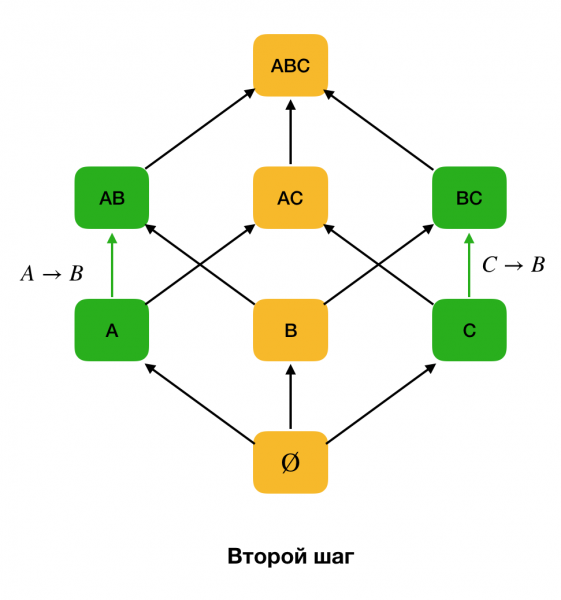
Në algoritmet e identifikimit të FZ, hapësira e kërkimit shpesh paraqitet në formën e një grupi, ku grupe prej një elementi (lexo niveli i parë i grupit të kërkimit, ku ana e majtë e varësive përbëhet nga një atribut) përfaqësojnë secilin atribut të marrëdhënies fillestare.
Fillimisht shqyrtohen varësitë e tilla si ∅ → Atribut i vetëm. Ky hap lejon të përcaktohet se cilët atribute janë çelësat primarë (për ata atribute nuk ka determinante, dhe për këtë arsye ana e majtë është e zbrazët). Më pas, algoritmet e tilla lëvizin lart përmes grupit. Duke pasur parasysh se grupi mund të anashkalohet, nëse i jepni një madhësi maksimale të dëshiruar të anës së majtë, algoritmi nuk do të vazhdojë më tej se niveli me atë madhësi.
Në figurën më poshtë tregohet si mund të përdoret grila algebrike në detyrën e kërkimit të FZ. Këtu çdo skaj (X, XY) përfaqëson një varshmëri X → Y. Për shembull, ne kaluam nivelin e parë dhe dimë se mbahet varshmëria A → B (të cilën e paraqesim me lidhje të gjelbra midis kulmave A dhe B). Kështu, kur do të përparojmë në grilë lart, ne mund të mos kontrollojmë varshmërinë A, C → B, sepse ajo do të jetë tashmë jo minimale. Po ashtu, ne nuk do ta kontrollonim, nëse do të mbahej varshmëria C → B.
Për më tepër, zakonisht, të gjithë algoritmët modernë për kërkimin e FZ përdorin një strukturë të dhënash si partitë (në burim — stripped partition [1]). Përkufizimi formal i një partie është si më poshtë:
Përkufizimi 6. Le të jetë X ⊆ R — një grup atributesh për marrëdhënien r. Klastri përfaqëson një grup indeksesh tuple nga r, të cilat kanë vlera të njëjta për X, dmth c(t) = {i|ti[X] = t[X]}. Partita përfaqëson një grup klasrish, duke përjashtuar klastrimet e gjatësi njësi:

Me fjalë të thjeshta, partida për atributin X përfaqëson një grup listash, ku çdo listë përmban numrat e rreshtave me vlera të njëjta për X. Në literaturën moderne, struktura që përfaqëson partitë quhet position list index (PLI). Klastrit e gjatësi njësi përjashtohen për qëllime kompresimi të PLI, sepse këto janë klastra që përmbajnë vetëm numrin e regjistrimit me vlerë unike, e cila gjithmonë do të jetë e lehtë për t'u përcaktuar.
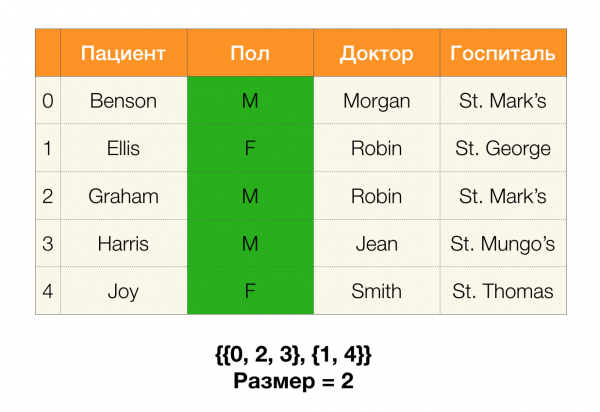
Le të shqyrtojmë një shembull. Të kthehemi te e njëjta tavolinë me pacientë dhe të ndërtomë partitë për kolona Pacienti dhe Gjinia (në të majtë është shfaqur një kolonë e re, ku janë shënuar numrat e rreshtave të tavolinës):
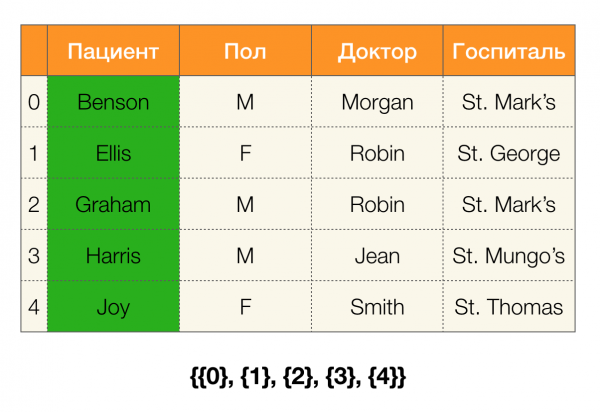
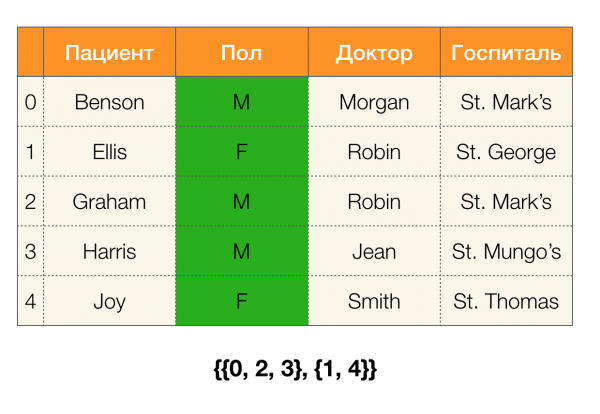
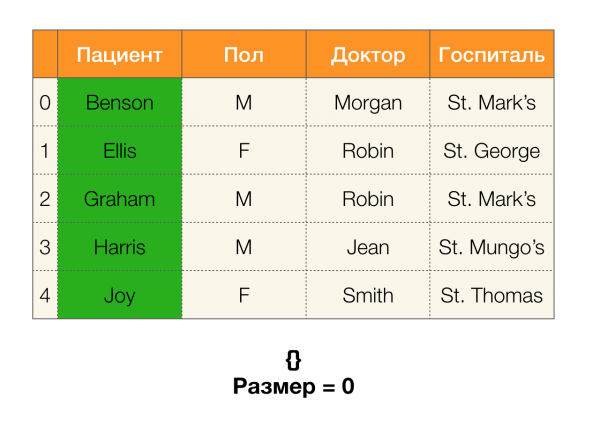
Sipas përkufizimit, partia për kolonën Pacienti në fakt do të jetë e zbrazët, pasi klasrat e vetme përjashtohen nga partia.
Partitë mund të fitohet mbi disa atribute. Dhe për këtë ekzistojnë dy rrugë: duke kaluar përmes tavolinës, ndërtimi i një partie menjëherë për të gjithë atributet e nevojshme, ose ndërtimi i saj me anë të operacionit të ndërsektimit të partive mbi një nëngrup atributesh. Algoritmët për kërkimin e FZ përdorin variantin e dytë.
Me fjalë të thjeshta, për të marrë një parti për kolona ABC, mund të merret partitë për AC dhe B (ose grupesh të tjera të papërshtatshme) dhe t'i ndërthurim ato. Operacioni i ndërthurjes së dy grupeve identifikon klastra me gjatësi maksimale të përbashkët për të dy grupet.
Le të shqyrtojmë një shembull:
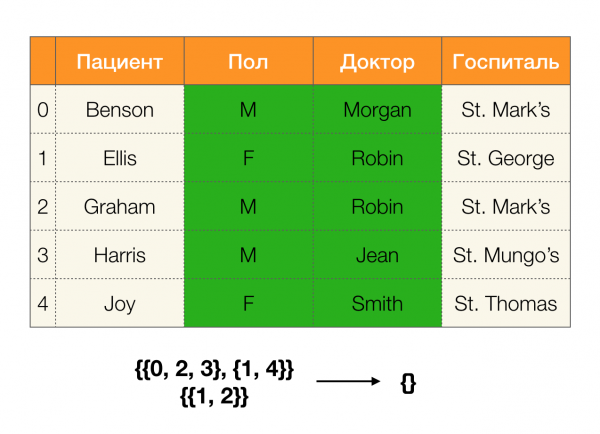
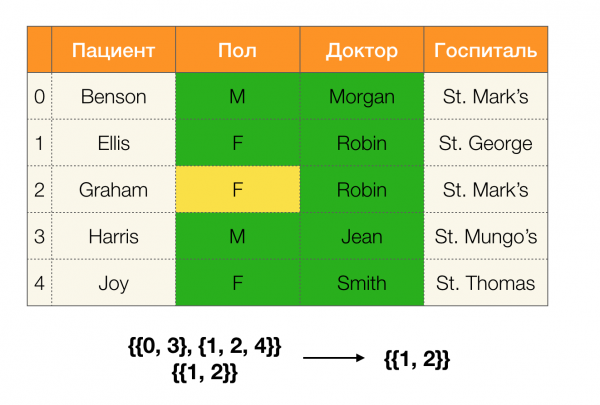
Në rastin e parë morëm një grup të zbrazët. Nëse e shohim tabelën, do të shohim që nuk ka vlera të njëjta për dy atribute. Nëse modifikojmë pak tabelën (rastin në të djathtë), do të marrim një ndërthurje jo të zbrazët. Në këtë rast, rreshtat 1 dhe 2 vërtet përmbajnë vlera të njëjta për atributet. Gjinia dhe Doktori.
Më pas do na nevojitet një koncept i tillë si madhësia e grupit. Formalisht:

Thjesht, madhësia e grupit përfaqëson numrin e klastrave që hynë në grup (kujtojmë se klastrat e vetme nuk hyjnë në grup!):
Tani mund të përcaktojmë një nga lemën kyçe, e cila për grupet e caktuara lejon të vendosim nëse mbahen varësitë apo jo:
Lema 1. Varësia A, B → C mbahet, nëse dhe vetëm nëse

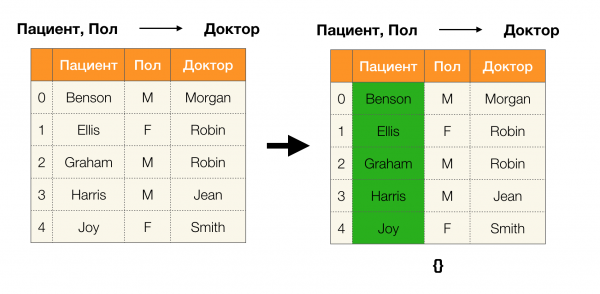
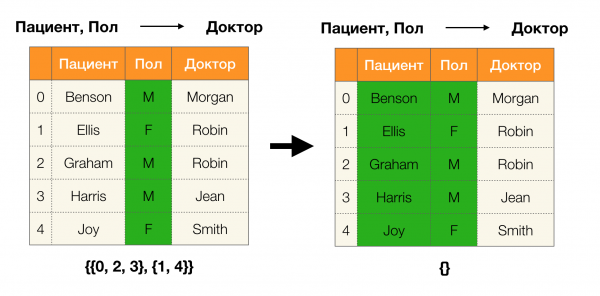
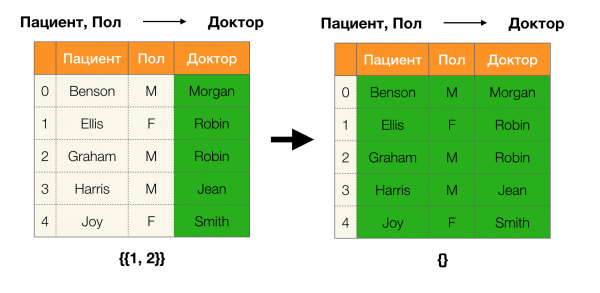
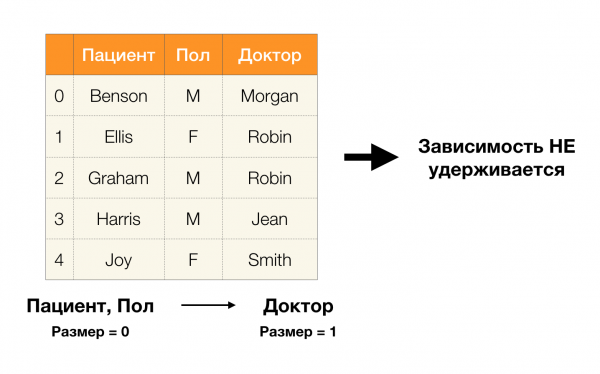
Sipas lemës, për të përcaktuar nëse mbahen varësitë, është e nevojshme të kryhen katër hapa:
- Të llogaritë grupin për anën e majtë të varësisë
- Të llogaritë grupin për anën e djathtë të varësisë
- Të llogaritë produktin e hapat e parë dhe të dytë
- Të krahasohet madhësia e grupeve që u morën në hapin e parë dhe të tretë
Më poshtë është një shembull i verifikimit nëse varësia mbahet sipas kësaj lemë:
Në këtë artikull shqyrtuam konceptet si varësia funksionale, varësia funksionale e afërt, shqyrtova se ku përdoren ato, si dhe cilat algoritmo për gjetjen e varësive funksionale ekzistojnë. Po ashtu, shqyrtuam në detaje konceptet bazë, por të rëndësishme, që përdoren në algoritmet moderne për gjetjen e varësive funksionale.
Lidhje me literaturën:
- Huhtala Y. et al. TANE: Një algoritëm efikas për zbulimin e varësive funksionale dhe të përafërta //Revista kompjuterike. – 1999. – T. 42. – Nr. 2. – fq. 100-111.
- Kruse S., Naumann F. Zbulimi efikas i varësive të përafërta //Proceedings of the VLDB Endowment. – 2018. – T. 11. – Nr. 7. – fq. 759-772.
- Papenbrock T., Naumann F. Një qasje hibrid për zbulimin e varësive funksionale //Proceedings of the 2016 Konferencës Ndërkombëtare mbi Menaxhimin e të Dhënave. – ACM, 2016. – fq. 821-833.
- Papenbrock T. et al. Zbulimi i varësive funksionale: Një vlerësim eksperimentues i shtatë algoritmove //Proceedings of the VLDB Endowment. – 2015. – T. 8. – Nr. 10. – fq. 1082-1093.
- Kumar A. et al. Të bashkëngjitemi apo jo?: Të mendojmë dy herë për bashkimet para përzgjedhjes së veçorave //Proceedings of the 2016 Konferencës Ndërkombëtare mbi Menaxhimin e të Dhënave. – ACM, 2016. – fq. 19-34.
- Abo Khamis M. et al. Mësimi në bazë të të dhënave me tensorë të hollë //Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – Fq. 325-340.
- Hellerstein J. M. et al. Biblioteka analitike MADlib: ose aftësitë MAD, SQL //Proceedings of the VLDB Endowment. – 2012. – V. 5. – Nr. 12. – Fq. 1700-1711.
- Qin C., Rusu F. Aproksimime spekulative për optimizimin e gradientit të shpërndarë teraskal //Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – Fq. 1.
- Meng X. et al. Mllib: Mësimi në apache spark //The Journal of Machine Learning Research. – 2016. – V. 17. – Nr. 1. – Fq. 1235-1241.
Autorët e artikullit: , kërkues në , dhe , kërkues në
Burimi: habr.com
