

30 nëntor — 1 dhjetor në Nizhny Novgorod u mbajt. Pjesëmarrësve iu propozua të krijojnë një prototip të zgjidhjes produktore duke përdorur Intel OpenVINO toolkit. Organizatorët ofruan një listë temash të sugjeruara, mbi të cilat mund të orientoheshin për të zgjedhur detyrën, por vendimi përfundimtar mbetej në duar të ekipeve. Për më tepër, inkurajohej përdorimi i modeleve që nuk përfshihen në produkt.
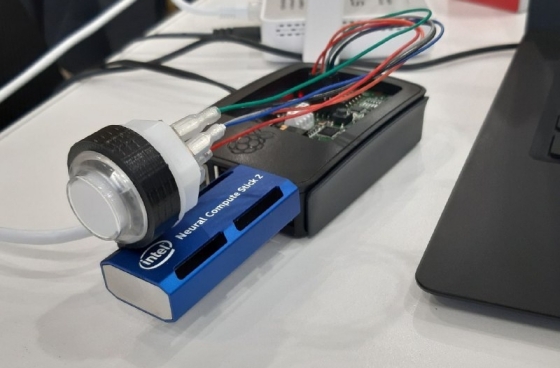
Në këtë artikull do të flasim për atë se si krijuam prototipin tonë të produktit, me të cilin në fund arritëm vendin e parë.
Në hackathon morën pjesë më shumë se 10 ekipe. E kënaqshme ishte që disa prej tyre erdhën nga rajone të tjera. Vendndodhja e hackathon-it ishte kompleksi “Kremlevskiy na Poçaine”, ku brenda ishin të ekspozuara fotografi të vjetra të Nizhny Novgorod, një atmosferë e bukur! (kujtoj se aktualisht zyra qendrore e kompanisë Intel ndodhet pikërisht në Nizhny Novgorod). Pjesëmarrësve u dha një afat prej 26 orësh për të shkruar kodin; në fund duhej të prezantonin zgjidhjen e tyre. Një përfitim i veçantë ishte prania e një sesi demosh, për t'u siguruar që gjithçka ishte realizuar në fakt dhe nuk kishte mbetur vetëm ide në prezantim. Merchandise, shërbime, ushqim, gjithçka ishte gjithashtu!
Për më tepër, kompania Intel ofronte në mënyrë të rastësishme kamera, Raspberry PI, Neural Compute Stick 2.
Zgjedhja e detyrës
Një nga pjesët më të vështira të përgatitjeve për hackathon-in me temë të lirë është zgjedhja e detyrës. Menjëherë vendosëm të mendoheshim për diçka që nuk është akoma në produkt, pasi në njoftim ishte thënë se kjo inkurajohej.
Pas analizimit , të cilat përfshihen në produktin në versionin aktual, arrijmë në përfundimin se shumica prej tyre zgjidhin detyra të ndryshme të perceptimit të kompjuterizuar. Në fakt, është shumë e vështirë të mendosh për një detyrë në fushën e perceptimit të kompjuterizuar, të cilën nuk mund ta zgjidhësh duke përdorur OpenVINO, dhe nëse një e tillë mund të mendosh, është e vështirë të gjesh modele të trajnimit të paracaktuar në mënyrë të hapur. Vendosim të hedhim një sy edhe në një drejtim tjetër — në përpunimin dhe analizën e zërit. Po shqyrtojmë një detyrë interesante për njohjen e emocioneve përmes zërit. Duhet thënë se në OpenVINO tashmë ekziston një model që percakton emocionet e njeriut përmes fytyrës, por:
- Në teori, mund të krijohet një algoritem i përbashkët, i cili do të funksionojë si me zërin ashtu edhe me imazhin, dhe kjo duhet të sigurojë një rritje të saktësisë.
- Kamerat zakonisht kanë një kënd të ngushtë shikimi, për të mbuluar një zonë të madhe, nevojitet më shumë se një kamerë, zëri nuk ka një limit të tillë.
Të zhvillojmë idenë: të marrim si bazë idenë për segmentin e shitjes me pakicë. Mund të përcaktojmë kënaqësinë e klientëve në arkadat e dyqaneve. Nëse ndonjë blerës është i pakënaqur me shërbimin dhe fillon të ngrisë tonin — mund të thërrasim menjëherë administratorin për ndihmë.
Në këtë rast, është e nevojshme të shtojmë njohjen e personit me zë, kjo do të na lejojë të diferencojmë punonjësit e dyqanit nga blerësit, të ofshtojmë analiza për çdo individ. Gjithashtu, do të mund të analizojmë sjelljen e punonjësve të dyqanit, të vlerësojmë atmosferën në grup, tingëllon mjaft mirë!
Formojmë kërkesat për zgjidhjen tonë:
- Madhësia e vogël e pajisjes qëllim
- Funksionimi në kohë reale
- Çmimi i ulët
- Shkallëzueshmëri e lehtë
Në fund, si pajisja qëllim përzgjedhim Raspberry Pi 3 me .
Është e rëndësishme të theksojmë një veçori të rëndësishme të NCS — ai funksionon më së miri me arkitekturën CNN standarde, nëse do të jetë e nevojshme të ekzekutojmë një model me shtresa të personalizuara, atëherë prisni një optimizim të nivelit të ulët.
Bashkëpunimi është i lehtë: duhet të gjejmë një mikrofon. Një mikrofon USB i zakonshëm do të punojë, megjithatë, ai nuk do të duket mirë me RPI. Por edhe këtu zgjidhja është pothuajse , në të cilin ka një mikrofon stereo të përshtatur.
Shkarkojmë Raspbian nga dhe e transferojmë në një flash drive, testojmë nëse mikrofonin funksionon me komandën e mëposhtme (ajo do të regjistrojë audio për 5 sekonda dhe do ta ruajë në një skedë):
arecord -d 5 -r 16000 test.wavMenjëherë shënoj se mikrofonin është shumë i ndjeshëm dhe kap zhurmat shumë mirë. Për ta rregulluar këtë, hyjmë në alsamixer, seçim pajisjet Capture dhe ulet niveli i sinjalit të hyrjes në 50-60%.
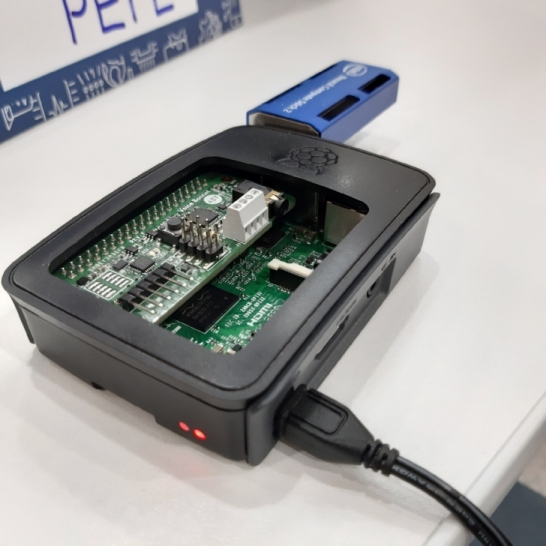
Përmirsojmë trupin me një file dhe gjithçka hyn brenda, madje mund ta mbulojmë me kapak.
Shtojmë butonin-indikator
Kur po shpërbëjmë AIY Voice Kit në pjesë, kujtojmë se aty ka një buton RGB, i cili mund të kontrollohet programatikisht. Kërkojmë 'Google AIY Led' dhe gjejmë dokumentacionin:
Pse të mos përdorim këtë buton për të shfaqur emocionin e njohur, kemi vetëm 7 klasa, ndërsa butoni ka 8 ngjyra, sa mjafton!
Lidhim butonin përmes GPIO me Voice Bonnet, ngarkojmë bibliotekat e nevojshme (ato janë tashmë të instaluara në distribucionin nga AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Do të krijojmë një dict, ku çdo emocion do të korrespondonte me një ngjyrë në formën e nje RGB Tuple dhe objektin e klasës aiy.leds.Leds, nëpërmjet të cilit do të përditësojmë ngjyrën:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
Dhe, në fund, pas çdo parashikimi të ri të emocionit do të përditësojmë ngjyrën e butonit në përputhje me të (sipër çelësit).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))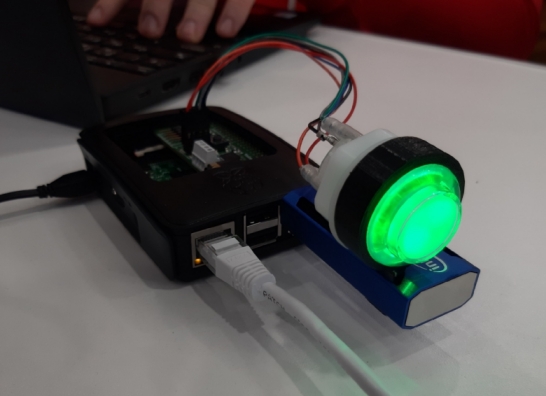
Butoni, ndiz!
Puna me zërin
Do të përdorim pyaudio për kapjen e rrjedhës nga mikrofonit dhe webrtcvad për filtrimin e zhurmës dhe detektimin e zërit. Përveç kësaj, do të krijojmë një radhë, në të cilën do të shtojmë dhe marrim asinkronisht fragmente me zë.
Duke qenë se webrtcvad ka një kufizim në madhësinë e fragmentit të dërguar — ai duhet të jetë 10/20/30ms, dhe trajnimi i modelit për njohjen e emocioneve (si do të mësojmë më vonë) është kryer në një dataset 48kHz, do të kapim çunke me madhësi 48000×20ms/1000×1 (mono)=960 byte. Webrtcvad do të kthejë True/False për secilën nga këto çunke, që korrespondon me praninë ose mungesën e zërit në chunk.
Do të realizojmë logjikën e mëposhtme:
- Do të shtojmë në list të gjitha çunket ku ka zë, nëse nuk ka zë, do të inkrementojmë numëruesin e çunkëve të zbrazët.
- Nëse numëruesi i çunkëve të zbrazët >=30 (600 ms), atëherë shikojmë madhësinë e listës së çunkëve të akumuluar, nëse ajo >250, atëherë e shtojmë në radhë, përndryshe, e vlerësojmë se gjatësia e regjistrimit nuk është e mjaftueshme për ta dërguar atë në model për identifikimin e folësit.
- Nëse numëruesi i çunkëve të zbrazët ende < 30, dhe madhësia e listës së çunkëve të akumuluar ka kaluar 300, atëherë do ta shtojmë fragmentin në radhë për një parashikim më të saktë. (sepse me kalimin e kohës emocionet kanë tendencë të ndryshojnë)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Ka ardhur koha për të kërkuar modele të paratësuar në dispozicion të hapur, shkojmë në github, kërkojmë në Google, por kujtojmë se kemi një kufizim në arkitekturën e përdorur. Kjo është një pjesë mjaft e vështirë, sepse duhet të testojmë modelet me të dhënat tona hyrëse, dhe për më tepër, të konvertojmë në formatin e brendshëm të OpenVINO — IR (Përfaqësimi Ndërmjetës). Ne kemi provuar rreth 5-7 zgjidhje të ndryshme në github, dhe nëse modeli për njohjen e emocioneve funksionoi menjëherë, për njohjen nga zëri duhej të punonim më gjatë — aty përdoren arkitekura më të ndërlikuara.
Ne ndalemi te këto:
- Emocionet nga zëri —
Funksionon sipas parimit të mëposhtëm: audio ndarë në copa me madhësi të caktuar, për secilën nga këto copa përzgjedhim dhe pastaj i dorëzojmë në CNN - Njohja nga zëri —
Këtu, në vend të MFCC, punojmë me spektrogramin, pas FFT e dorëzojmë sinjalin në CNN, ku në dalje marrim një përfaqësim vektorial të zërit.
Tani do të flasim për konvertimin e modeleve, le të fillojmë me teorinë. OpenVINO përfshin disa module:
- Open Model Zoo, modelet e të cilit mund të përdoren dhe përfshihen në produktin tuaj
- Model Optimizer, falë të cilit mund të konvertojmë modelin nga formate të ndryshme të framework-eve (Tensorflow, ONNX etj.) në formatin e Përfaqësimit Ndërmjetës, me të cilin do të punojmë më tej
- Inferencë Engine u jep mundësinë për të ekzekutuar modelet në formatin IR në procesorët Intel, çipat Myriad dhe akseleratorët Neural Compute Stick
- Versioni më efikas i OpenCV (me mbështetje për Inference Engine)
Çdo model në formatin IR përshkruhet me dy skedarë: .xml dhe .bin.
Modelet konvertohen në formatin IR përmes Model Optimizer në mënyrën e mëposhtme:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typepërcakton formatin e të dhënave me të cilin do të punojë modeli. MBështeten FP32, FP16, INT8. Zgjedhja e formatit optimal të të dhënave mund të sjellë një rritje të mirë të performancës.
--input_shapecaktome mbi dimensionet e të dhënave hyrëse. Mundësia për ta ndryshuar dinamikisht duket të jetë e pranishme në API-në C++, por ne nuk u thelluam aq dhe për një nga modelet thjesht e ngulitim.
Më pas do të përpiqemi të ngarkojmë modelin e konvertuar në formatin IR përmes modulit DNN në OpenCV dhe të kryejmë forward mbi të.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Vija e fundit në këtë rast lejon që llogaritjet të drejtohen në Neural Compute Stick, zakonisht llogaritjet kryhen në procesor, por në rastin e Raspberry Pi kjo nuk do të funksionojë, do të nevojitet një stick.
Më pas logjika është si vijon: do ta ndajmë audio-n në dritare të një madhësie të caktuar (në rastin tonë 0.4s), çdo njëra nga këto dritare do të përshtatet në MFCC, të cilat pastaj do t'i japim rrjetit:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Më pas do të marrim klasën më të shpeshtë për të gjitha dritaret. Një zgjidhje e thjeshtë, por për hackathon dhe nuk ka nevojë të shpikim diçka tepër të sofistikuar, vetëm nëse ka kohë. Ne kemi ende shumë punë, prandaj shkojmë përpara — merremi me njohjen përmes zërit. Nevojitet të krijojmë një bazë, në të cilën do të ruhen spektrat e zërit të regjistruar më parë. Duke qenë se mbetet pak kohë, e zgjidhim këtë çështje ashtu si mundemi.
Kështu, krijojmë një skript për regjistrimin e një fraze zëri (ai funksionon ashtu siç përshkruhet më sipër, përveç se gjatë ndërprerjes me tastierë, ai do ta ruajë zërin në një skedar).
Provo.
python3 voice_db/record_voice.py test.wavRegjistrojmë zërat e disa njerëzve (në rastin tonë trefish të anëtarëve të ekipit)
Më pas, për çdo zë të regjistruar do të kryejmë transformimin e shpejtë të Fourier-it, do të marrim spektrin dhe do ta ruajmë në formën e një numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Më shumë në skedarin
create_base.py
Në përfundim, gjatë ekzekutimit të skriptës kryesore ne në fillim do të marrim imbedding-et nga këto spektra:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Pas pasjesëm nga segmenti të marrim për të përcaktuar se kujt i takon ai, duke marrë distancën kosinore nga fragmenti deri te të gjitha zërat në databazë (sa më e vogël, aq më e mundshme) — për demo, ne e kemi vendosur pragun në 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Në përfundim, do të theksoj se shpejtësia e inferrencës ishte e shpejtë dhe lejonte shtimin edhe të 1-2 modeleve të tjera (për një mostër me gjatësi 7 sekonda, për inferrencë nevojiteshin 2.5). Të shtojmë modele të reja nuk arritëm ta përfundojmë dhe u përqendruam në shkruarjen e prototipit të aplikacionit web.
Aplikacioni web
Një pikë e rëndësishme: marrë me vete routerin nga shtëpia dhe konfigurimi i rrjetit tonë lokal, ndihmon për të lidhur pajisjet dhe laptopët në rrjet.
Backend-i përbën një kanal të vazhdueshëm mes frontit dhe Raspberry Pi, i bazuar në teknologjinë websocket (http mbi protokollin tcp).
Hapi i parë është marrja e informacionit të përpunuar nga Raspberry, dmth. parashikimet e paketuar në json, të cilat gjatë rrugës së tyre ruajnë në databazë, në mënyrë që të mund të formohet statistika mbi gjendjen emocionale të përdoruesit për një periudhë. Më pas, ky paketë dërgohet në front, i cili përdor abonimin dhe marrjen e paketave nga endpoint-i i websockets. E gjithë mekanizmi backend është ndërtuar në gjuhën golang, zgjedhja ra mbi të sepse ai përshtatet mirë për detyra asinkrone, me të cilat goroutines përballen mirë.
Kur përdoruesi qaset në endpoint, regjistrohet dhe futet në strukturë, pastaj ndodhet marrja e mesazhit të tij. Si përdoruesi ashtu edhe mesazhi regjistrohen në hub-in e përbashkët, nga i cili mesazhet dërgohen më tej (në frontin e abonuar), dhe nëse përdoruesi mbyll lidhjen (Raspberry ose frontend), atëherë abonimi i tij anullohet dhe ai hiqet nga hub-i.
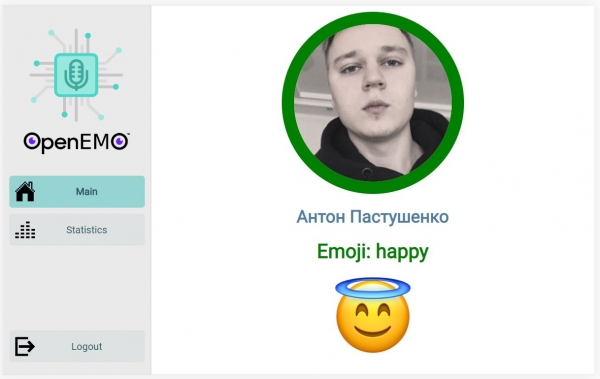
Po presim lidhjen me backend-inFront-end është një aplikacion web, i shkruar në JavaScript me përdorimin e bibliotekës React për të përshpejtuar dhe thjeshtuar procesin e zhvillimit. Qëllimi i këtij aplikacioni është vizualizimi i të dhënave, të marra përmes algoritmeve, të cilat janë ekzekutuar në anën back-end dhe përkatësisht në Raspberry Pi. Në faqen ka routing për seksione, të realizuar përmes react-router, por interesi kryesor paraqitet në faqen kryesore, ku në kohë reale ka një rrjedhë të vazhdueshme të të dhënave nga serveri përmes teknologjisë WebSocket. Raspberry Pi detekton zërin, përcakton përkatësinë e tij te një individ i caktuar nga baza e të dhënave të regjistruar dhe dërgon një listë probability te klienti. Klienti shfaq të dhënat më të fundit, tregon avatarin e personit që ka folur në mikrofon me probabilitetin më të madh, si dhe emocionin me të cilin ai/ajo po flet.

Faqja kryesore me parashikimet në përditësimPërfundim
Nuk arritëm të përfundonim gjithçka siç ishte planifikuar, thjesht nuk patëm kohë, prandaj shpresa jonë kryesore ishte te demo, që gjithçka do të funksiononte. Në prezantim folëm për mënyrën se si ishte organizuar gjithçka, cilat modele përdorëm, me cilat sfida u ballafaquam. Më pas kishte një pjesë demo — ekspertët lëviznin në sallë në një rend të rastësishëm dhe iu afroheshin çdo ekipi për të parë prototipin funksional. Bënin pyetje edhe për ne, çdo kush përgjigjej për pjesën e tij, në laptop kishim web-in, dhe gjithçka vërtet funksiononte siç pritej.
Dua të theksoj se kostoja totale e zgjidhjes sonë ishte 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (mund të përdorni bordin respetker) ~ 15$
- Intel NCS 2 ~ 100$
Si të përmirësojmë:
- Të përdorim regjistrimin nga klienti — të kërkojmë të lexojë një tekst që e gjenerojmë rastësisht
- Të shtojmë disa modele të tjera: me zërin mund të përcaktojmë gjininë dhe moshën
- Të ndajmë zëra që dëgjohen në të njëjtën kohë (diarizimi)
Repozitori:

Të lodhur, por të lumtur neNë përfundim, dua të falënderoj organizatorët dhe pjesëmarrësit. Nga projektet e ekipeve të tjera, na pëlqeu veçanërisht zgjidhja për monitorimin e vendeve të parkimit të lirë. Për ne ishte një përvojë e jashtëzakonshme e zhytjes në produkt dhe zhvillim. Shpresoj se në rajone do të organizohen gjithnjë e më shumë ngjarje interesante, përfshirë edhe në temën e AI.
Burimi: habr.com
