

Kodi i produkteve software për mësim të makinerive shpesh është kompleks dhe mjaft i ngatërruar. Zbulimi dhe eliminimi i defekteve në të është një detyrë e shtrenjë për burime. Edhe më e thjeshta kërkojnë një qasje serioze ndaj arkitekturës rrjetore, inicializimit të peshave dhe optimizimit të rrjetit. Një gabim i vogël mund të sjellë probleme të pakëndshme.
Ky artikull i kushtohet algoritmit për debugging të rrjetave tuaja neuronale.
Skillbox rekomandon: Kurs praktik .
Kujtojmë: për të gjithë lexuesit e «Habra» — zbritje prej 10,000 rublesh për regjistrimin në çdo kurs Skillbox me kodin promovues «Habr».
Algoritmi përbëhet nga pesë faza:
- fillimi i thjeshtë;
- konfirmimi i humbjeve;
- kontrollimi i rezultateve ndërmjetëse dhe lidhjeve;
- diagnoza e parametrave;
- kontrollimi i funksionimit.
Nëse diçka ju duket më interesante se sa e tjerash, mund të kaloni menjëherë në këto seksione.
Fillimi i thjeshtë
Debugger një rrjet nervor me arkitekturë të ndërlikuar, regularizim dhe planifikues të shpejtësisë së mësimit është më e vështirë se sa një e zakonshme. Këtu po manipulojmë, pasi pika vetë për debugging ka një lidhje indirekte, por kjo është një rekomandim i rëndësishëm.
Fillimi i thjeshtë përfshin krijimin e një modeli të thjeshtuar dhe mësimin e tij mbi një grup (pikë) të dhënash.
Së pari krijojmë një model të thjeshtuar
Për fillim të shpejtë krijojmë një rrjet të vogël me një shtresë të fshehtë dhe e kontrollojmë që gjithçka të funksionojë në mënyrë korrekte. Pastaj gradualisht e komplikohemi modelin, duke kontrolluar çdo aspekt të ri të strukturës së tij (shtresës shtesë, parametrave etj.), dhe vazhdojmë më tutje.
Mësojmë modelin mbi një grup të vetëm (pikë) të dhënash
Si një kontroll të shpejtë të funksionalitetit të projektit tuaj, mund të përdorni një ose dy pika të dhënash për të mësuar, për të konfirmuar nëse sistemi funksionon siç duhet. Rrjeti nervor duhet të tregojë 100% saktësi në mësim dhe verifikim. Nëse kjo nuk ndodh, atëherë ose modeli është shumë i vogël, ose keni një defekt.
Edhe nëse gjithçka është mirë, përgatitni modelin për të kaluar një ose disa epokë para se të shkoni më tej.
Vlerësimi i humbjeve
Vlerësimi i humbjeve është mënyra kryesore për të saktësuar performancën e modelit. Ju duhet të siguroheni se humbja i përmbahet detyrës, dhe funksionet e humbjes vlerësohen sipas një shkalle korrekt. Nëse përdorni më shumë se një lloj humbjeje, atëherë sigurohuni që të gjitha ato të jenë të një rendi dhe të skaluara siç duhet.
Është e rëndësishme të jeni të kujdesshëm për humbjet fillestare. Kontrolloni sa afër është rezultati real me atë të pritur, nëse modeli ka filluar nga një supozim të rastësishëm. Në : «Sigurohuni që po merrni rezultatin që pritet kur filloni të punoni me një numër të vogël parametrash. Është më mirë të kontrolloni menjëherë humbjen e të dhënave (me vendosjen e gradës së rregullimit në zero). Për shembull, për CIFAR-10 me klasifikuesin Softmax ne presim që humbjet fillestare të jenë 2.302, sepse probabiliteti i përhapur i pritur është 0,1 për çdo klasë (duke pasur parasysh se ekzistojnë 10 klasa), dhe humbja Softmax është probabiliteti negativ logaritmik i klasës së saktë si –ln (0.1) = 2.302».
Për një shembull binar, thjesht bëhet llogaritja e ngjashme për secilën nga klasat. Ja, për shembull, të dhënat: 20% 0’s dhe 80% 1’s. Humba e pritur fillestare do të jetë deri në –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Nëse rezultati është më i madh se 1, kjo mund të tregojë se pesha e rrjetit nervor nuk është balancuar siç duhet ose të dhënat nuk janë normalizuar.
Kontrolloni rezultatet ndërmjetëse dhe lidhjet
Për të debuguar rrjetin nervor është e nevojshme të kuptohet dinamika e proceseve brenda rrjetit dhe roli i shtresave të intermediara, pasi ato janë të lidhura. Ja disa gabime tipike me të cilat mund të përballeni:
- shprehje të gabuara për përditësimet e gradienteve;
- përditësimet e peshave nuk aplikohen;
- gradiente që shuhen ose shpërthejnë (exploding gradients).
Nëse vlerat e gradientit janë zero, kjo do të thotë se shpejtësia e të mësuarit në optimizues është shumë e ulët, ose keni hasur në një shprehje të gabuar për përditësimin e gradientit.
Për më tepër, është e nevojshme të monitoroni vlerat e funksioneve të aktivizimit, peshave dhe përditësimeve të çdo shtrese. Për shembull, madhësia e përditësimeve të parametrave (peshave dhe zhvendosjeve) .
Ekziston një fenomen që quhet “Dying ReLU” ose , kur neuronet ReLU do të japin zero pas studimit të një vlerë të madhe negative (bias) për peshat e tij. Këto neurone nuk aktivizohen më kurrë në asnjë vend të të dhënave.
Mund të përdorni kontrollin e gradientit për të zbuluar këto gabime duke aproksimuar gradientin me një qasje numerike. Nëse është afër gradientëve të llogaritur, atëherë përhapja e prapme është realizuar siç duhet. Për të krijuar një kontroll të gradientit, shikoni këto burime të shkëlqyera nga CS231 dhe , si dhe nga Andrew Ng për këtë temë.
shpjegon tre metoda kryesore të vizualizimit të rrjetit nervor:
- Paraprirësit — metoda të thjeshta që na tregojnë strukturën e përgjithshme të modelit të mësuar. Këto përfshijnë daljet e formave apo filtrave të shtresave individuale të rrjetit nervor dhe parametrat në çdo shtresë.
- Të bazuara në aktivizim. Ato dekriptojnë aktivizimet e neuronëve individualë ose grupeve të neuronëve për të kuptuar funksionet e tyre.
- Të bazuara në gradientë. Këto metoda kanë tendencë të manipulojnë gradientët që formohen nga kalimi përpara dhe mbrapa gjatë trajnimit të modelit (duke përfshirë hartat e rëndësisë dhe hartat e aktivizimit të klasës).
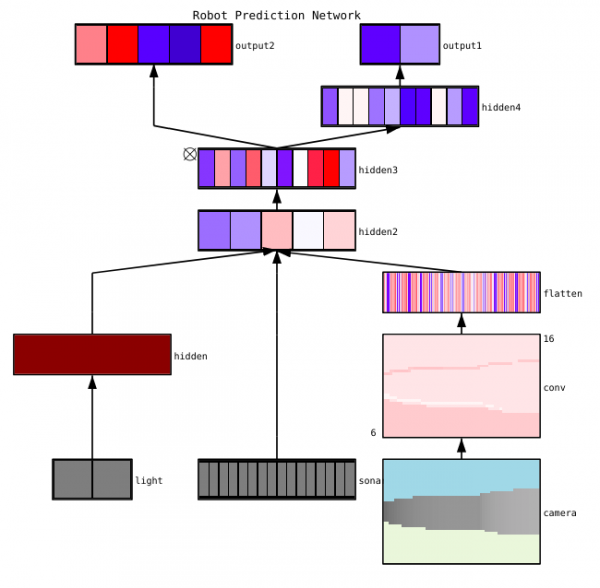
Ekzistojnë disa mjete të dobishme për vizualizimin e aktivizimeve dhe lidhjeve të shtresave të veçanta, siç janë dhe .
Diagnostika e parametrave
Rrjetet nervore kanë një shumëllojshmëri parametrash që ndërveprojnë me njëra-tjetrën, duke e komplikuar optimizimin. Në thelb, ky seksion është objekt i kërkimeve aktive të specialistëve, prandaj propozimet më poshtë duhet të merren vetëm si këshilla, pika fillestare për t'u nisur.
Madhësia e grupit (batch size) — nëse është e nevojshme, që madhësia e grupit të jetë e mjaftueshme për të marrë vlerësime të sakta të gradientit të gabimit, por e vogël mjaftueshëm që rënia stohastike e gradientit (SGD) të mund të rendisë rrjetin tuaj. Madhësitë e vogla të grupeve do të çojnë në një konvergjencë më të shpejtë për shkak të zhurmës gjatë procesit të mësimit dhe më pas — në vështirësi në optimizim. Më shumë për këtë është përshkruar .
Shpejtësia e mësimit — shumë e ulët do të çojë në konvergjencë të ngadalshme ose rrezikun për të ngecur në minimumet lokale. Në të njëjtën kohë, një shpejtësi e lartë mësimi do të shkaktojë divergjencë të optimizimit, pasi rrezikoni të "kalloni" përmes një pjese të thellë, por të ngushtë të funksionit të humbjes. Provoni të përdorni planifikimin e shpejtësisë për ta ulur atë gjatë procesit të mësimit të rrjetit nervor. .
Klipimi i gradienteve — është prerja e gradienteve të parametrave gjatë përhapjes prapa sipas vlerës maksimale ose normës kufitare. Është e dobishme për të zgjidhur problemet me çdo gradiant që mund të shpërthejë, me të cilin mund të përballeni në pikën tre.
Normalizimi në grup — përdoret për të normalizuar të dhënat hyrëse të çdo shtrese, duke ndihmuar në zgjidhjen e problemeve me zhvendosjen e brendshme të kovariateve. Nëse përdorni Dropout dhe Batch Normalization së bashku, .
Në shkallën stohastike të gradienteve (SGD) — ekzistojnë disa variante të SGD që përdorin impuls, shpejtësi adaptuese të mësimit dhe metodën Nesterov. Megjithatë, asnjëra prej tyre nuk ka një avantazh të qartë as për sa i përket efikasitetit të mësimit, as për sa i përket përgjithësimit ().
Rregullimi — është thelbësore për ndërtimin e një modeli të përgjithshëm, pasi shton një ndëshkim për kompleksitetin e modelit ose për vlerat ekstreme të parametrave. Ky është një mënyrë për të ulur variancën e modelit pa rritur ndjeshëm ndarjen e tij. Më shumë .
Për të vlerësuar gjithçka vetë, duhen çaktivizuar rregullimi dhe duhet të kontrollohet gradienti i humbjes së të dhënave vetë.
Rënia — është një tjetër metodë për të rregulluar rrjetin tuaj për të parandaluar mbingarkesën. Gjatë mësimit, rënia realizohet vetëm duke mbajtur aktivitetin e neuronit me një probabilitet të caktuar p (hiper-parametri) ose duke e vendosur atë në zero në rastin e kundërt. Si rezultat, rrjeti duhet të përdorë një nëngrup tjetër parametrash për çdo grup mësimor, duke reduktuar ndryshimet e parametrave të caktuar që bëhen dominuese.
Është e rëndësishme: nëse përdorni si rënien, ashtu edhe normalizimin në grup, jini të kujdesshëm me rendin e këtyre operacioneve ose madje edhe me përdorimin e tyre të përbashkët. Të gjitha këto janë ende duke u diskutuar dhe përmirësuar. Ja dy diskutime të rëndësishme mbi këtë temë dhe .
Kontrolli i funksionit
Bëhet fjalë për dokumentimin e proceseve punuese dhe eksperimenteve. Nëse nuk dokumentoni asgjë, mund të harroni, për shembull, cilat janë shpejtësia e nxënies ose pesha e klasave që përdoren. Falë kontrollit, mund të shqyrtoni dhe riprodhoni në mënyrë të lehtë eksperimentet e mëparshme. Kjo ndihmon në reduktimin e numrit të eksperimenteve të dyfishta.
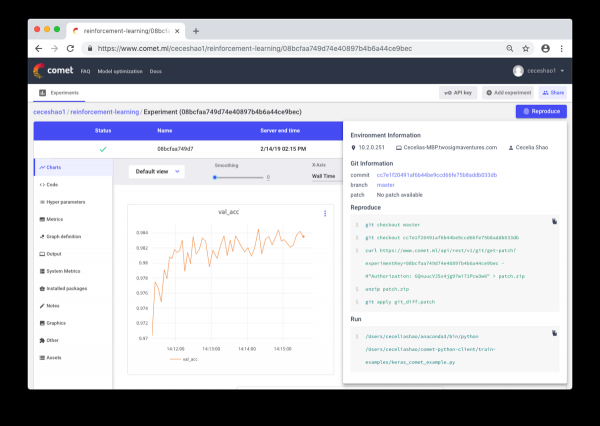
Megjithatë, dokumentimi manual mund të bëhet një detyrë e vështirë në rast të një volumi të madh punësh. Këtu ndihmojnë të tillë si Comet.ml, që ndihmojnë për të loguar automatikisht grumbujt e të dhënave, ndryshimet në kod, historinë e eksperimenteve dhe modelet prodhuese, përfshirë informacionin kyç mbi modelin tuaj (hiperparametrat, treguesit e performancës së modelit dhe informacionin mbi mjedisin).
Një rrjet nervor mund të jetë mjaft i ndjeshëm ndaj ndryshimeve të vogla, dhe kjo do të çojë në rënien e performancës së modelit. Ndjekja dhe dokumentimi i punës është hapi i parë që duhet të ndërmerrni për të standardizuar mjedisin dhe modelimin.
Shpresoj se ky post mund të jetë pika e nisjes nga e cila do të filloni rregullimin e rrjetit tuaj nervor.
Skillbox rekomandon:
- Kursi praktik dyvjeçar .
- Kurs online .
- Kurs praktik njëvjeçar .
Burimi: habr.com
