

OpenAI-projektet, som arbetar med utvecklingen av offentliga projekt inom artificiell intelligens, publicerade resultat relaterade till talsigenkänningssystemet Whisper. Det påstås att systemet för engelskt tal erbjuder nivåer av tillförlitlighet och noggrannhet i automatisk taligenkänning som är nära den mänskliga nivån. Koden för referensimplementeringen, baserad på PyTorch-ramverket, samt ett antal redan tränade modeller som är klara för användning, är nu öppna. Koden publiceras under MIT-licensen.
Modellen har tränats med 680 000 timmar talsdata som samlats in från flera samlingar som täcker olika språk och ämnesområden. Omkring 1/3 av de användna talsdata vid träningen kommer från språk som skiljer sig från engelska. Det föreslagna systemet hanterar korrekt situationer som accentuerad uttal, bakgrundsbrus och teknisk jargong. Förutom att transkribera tal till text kan systemet även översätta tal från valfritt språk till engelska och identifiera när tal förekommer i ljudströmmen.
Modellerna är formulerade i två versioner: en för engelska och en flerspråkig modell som stödjer, bland annat, ryska, ukrainska och vitryska. Varje version delas i sin tur upp i 5 varianter som skiljer sig åt i storlek och antal parametrar i modellen. Ju större storlek, desto högre noggrannhet och kvalitet på igenkänningen, men det ställer även högre krav på GPU-minnets storlek och sänker prestandan. Till exempel innehåller den minimi varianten 39 miljoner parametrar och kräver 1 GB GPU-minne, medan den maximala varianten innehåller 1550 miljoner parametrar och kräver 10 GB GPU-minne. Den minimala varianten är 32 gånger snabbare än den maximala.
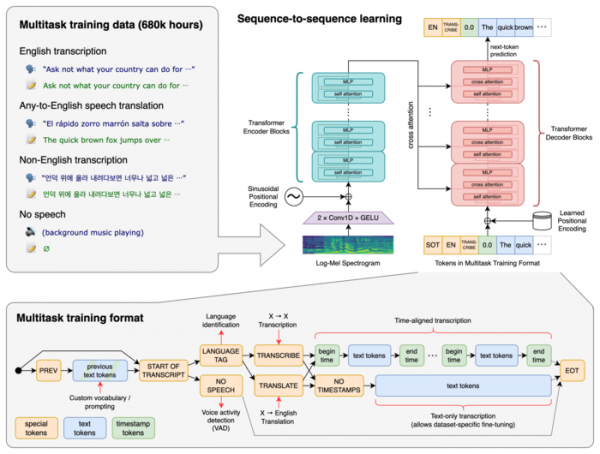
Systemet använder en "Transformer"-neuralnätverksarkitektur som inkluderar en kodare och en avkodare som interagerar med varandra. Ljudet delas upp i 30-sekundersklipp som omvandlas till en log-Mel-spektrogram och skickas till kodaren. Resultatet av kodarens arbete skickas till avkodaren, som förutspår den textuella representationen, blandad med speciella tokens som möjliggör att hantera uppgifter som språkidentifiering, beaktande av tidssekvenser i frasernas uttal, transkribering av tal på olika språk och översättning till engelska.
Källa: opennet.ru
