

De största företagen inom maskininlärning har presenterat projektet OpenXLA, som syftar till att gemensamt utveckla verktyg för kompilering och optimering av modeller för maskininlärningssystem. Under projektets tak har utvecklingen av verktyg skett för att standardisera kompileringen av modeller som skapats i ramverken TensorFlow, PyTorch och JAX, för effektiv utbildning och utförande på olika GPU:er och specialiserade acceleratorer. Företag som Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba och Amazon har anslutit sig till projektet.
Det förväntas att genom samarbete mellan ledande forskarteam och företrädare för gemenskapen kommer man att kunna stimulera utvecklingen av maskininlärningssystem och lösa problemet med fragmenteringen av infrastrukturen för olika ramverk och hårdvara. OpenXLA möjliggör effektiv stöd för olika hårdvaror, oavsett vilket ramverk som modellen för maskininlärning har skapats med. Det förväntas att OpenXLA kommer att minska träningstiden för modeller, öka kapaciteten, minska latensen, sänka kostnaderna för beräkningsresurser och förkorta tiden för att lansera produkter på marknaden.
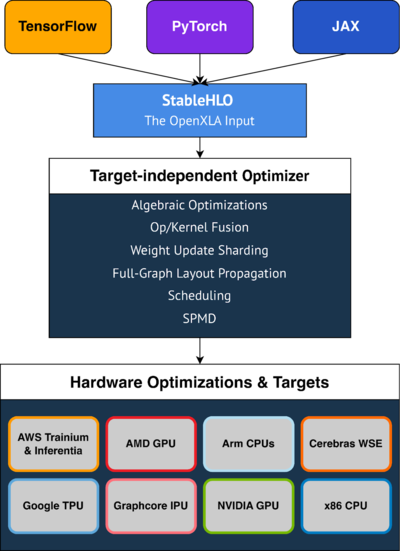
OpenXLA består av tre grundläggande komponenter, vars kod distribueras under Apache 2.0-licensen:
- XLA (Accelerated Linear Algebra) — en kompilator som möjliggör optimering av maskininlärningsmodeller för högpresterande körning på olika hårdvaruplattformar, inklusive GPU:er, CPU:er och specialiserade acceleratorer från olika tillverkare.
- StableHLO — en specifikation och grundläggande implementation av en uppsättning hög nivå operationer (HLO, High-Level Operations) för användning i modeller av maskininlärningssystem. Det fungerar som ett lager mellan ramverken för maskininlärning och kompilatorerna, som omvandlar modellen för att köras på specifik hårdvara. Lager för modellgenerering i StableHLO-format har tagits fram för ramverken PyTorch, TensorFlow och JAX. Som grund för StableHLO har uppsättningen MHLO använts, som har utökats med stöd för serialisering och versionshantering.
- IREE (Intermediate Representation Execution Environment) är en kompilator och runtime som konverterar maskininlärningsmodeller till ett universellt mellanliggande format baserat på MLIR (Multi-Level Intermediate Representation) från LLVM-projektet. Bland funktionerna märks möjligheten till förkompilering (ahead-of-time), stöd för flödeshantering, användning av dynamiska element i modeller, optimering för olika CPU:er och GPU:er samt låga overheadkostnader.
Huvudfördelar med OpenXLA-verktyget:
- Uppnå optimal prestanda utan att behöva fördjupa sig i att skriva enhetspecifik kod. Erbjuder färdiga optimeringar, inklusive förenkling av algebraiska uttryck, effektiv minnesplacering, och utförandeplanering med fokus på att minska toppminnesanvändning och överbelastningar.
- Förenkling av skalning och parallellisering av beräkningar. Utvecklaren behöver endast lägga till annoteringar för en delmängd av kritiska tensorer, på grundval av vilka kompilatorn automatiskt kan generera kod för parallella beräkningar.
- Säkerställande av portabilitet genom stöd för olika hårdvaruplattformar, som GPU:er från AMD och NVIDIA, CPU:er baserade på x86- och ARM-arkitekturer, ML-acceleratorer som Google TPU, AWS Trainium och Inferentia, Graphcore och Cerebras Wafer-Scale Engine.
- Stöd för att ansluta tillägg med implementering av ytterligare funktioner, såsom stöd för att skriva primitiva djupa maskininlärningsfunktioner med CUDA, HIP, SYCL, Triton och andra språk för parallella beräkningar. Möjlighet till manuell finjustering av flaskhalsar i modeller.
Källa: opennet.ru
