

En ingenjör från Clyso sammanfattade erfarenheterna av att skapa ett lagringskluster baserat på det fel toleranta distribuerade systemet Ceph med en bandbredd som överstiger tebibyte per sekund. Det noteras att detta är det första Ceph-klustret som har uppnått en sådan siffra, men innan ingenjörerna kunde uppnå det presenterade resultatet behövde de övervinna en rad icke uppenbara fallgropar.
Till exempel var det tillräckligt att aktivera maximala prestandainställningar och stänga av C-states (C-states ändrar energibesparingsinställningarna beroende på belastningen, vilket påverkar Ceph) på servrarna för att öka prestandan med 10-20%. Det visade sig också att när man använde NVMe-enheter spenderade Linux-kärnan en betydande tid på att bearbeta spinlåses under uppdateringen av IOMMU-mapping. Avstängning av IOMMU i kärnan ledde till en märkbar ökning av prestandan i testerna för skriv- och läsblock på 4 MB.
Samtidigt löste avstängning av IOMMU inte problemet med nedgång i prestandan vid slumpmässig skrivning av block på 4 KB. När ingenjörerna granskade situationen, stötte de på patchar i byggscenarierna för Ceph från Gentoo- och Ubuntu-projekten, som inkluderade byggande med alternativet RelWithDebInfo, eftersom detta i GCC tillämpade optimeringsläget "-O2", vilket avsevärt ökade prestandan för Ceph. Prestandan minskade också vid kompilering med biblioteket TCMalloc. Ändring av kompilatorflaggor och avstängning av TCMalloc ledde till en tredubbling av tiden för paketering (compaction) och en fördubbling av prestandan för slumpmässiga skrivoperationer med block på 4K. Slutligen genomfördes dessutom en optimering av inställningarna för Reef RocksDB och placeringarna (PG).
Kluster är bildat av 68 noder baserat på servrar Dell PowerEdge R6615 med CPU AMD EPYC 9454P 48C/96T. Varje nod innehåller 10 NVMe-enheter Dell 15.36TB, två Ethernet-adaptrar 100GbE Mellanox ConnectX-6 och 192 GB RAM. Mjukvaran baseras på Ubuntu 20.04.6 och Ceph 17.2.7. I klustret med 63 noder har 630 OSD (Object Storage Daemon, en bakgrundsprocess som hanterar datalagring i lokalt lager, en OSD per NVMe-enhet) startats, tre MON-processer (monitor, övervakar klustrets tillstånd) och en MGR-process (Manager, hanterar tjänsten). Lagringsstorleken är 8.2 PB.
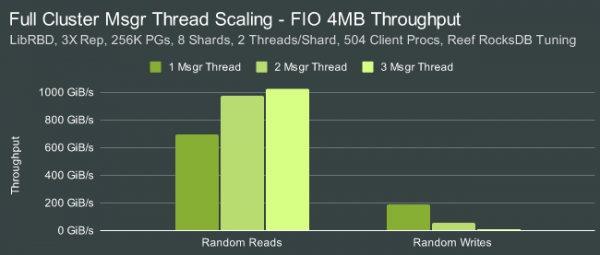
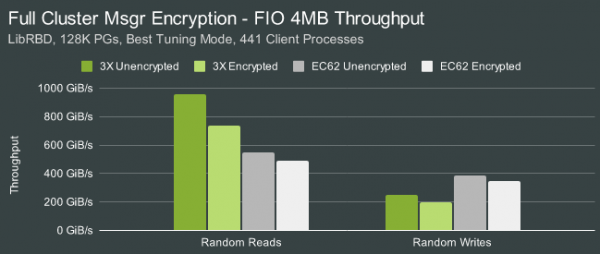
Genomströmningen vid sekventiella läsoperationer av 4M block var 1025 GiB/s för läsning och 270 GiB/s för skrivning. Vid slumpmässig läsning av 4KB block uppnåddes en prestanda på 25,5 miljoner läsoperationer per sekund och 4,9 miljoner vid skrivning. Aktivering av kryptering minskade genomsnittsflödet vid läsning till ungefär 750 GiB/s. Med felkorrigeringskoder (EC62) var genomsnittsflödet 547 GiB/s vid läsning och 387 GiB/s vid skrivning (skrivhastigheten var högre än utan felkorrigering), och vid slumpmässig åtkomst uppnåddes 3,4M IOPS vid läsning och 936K IOPS vid skrivning.
Det kan också noteras att en liknande genomsnittsflödesgräns i tebibyte per sekund nåddes i det exabyteskala lagringsklustret vid CERN i september, som byggdes med det öppna distribuerade lagringssystemet EOS, baserat på protokollet XRootD.
Källa: opennet.ru
