

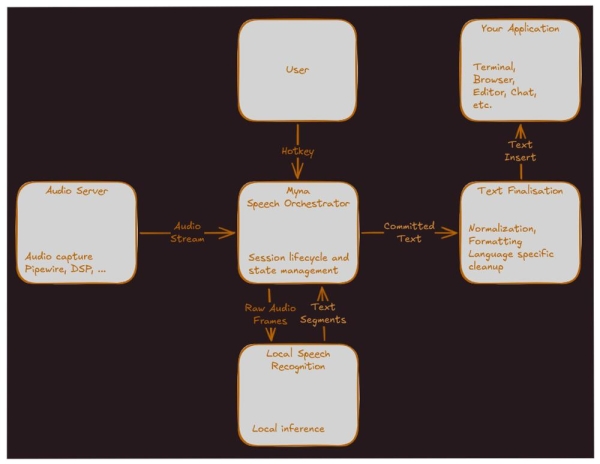
Canonical har presenterat ett projekt Myna — ett nytt system för taligenkänning för att omvandla tal till text för Ubuntu Desktop. Projektet syftar till inbyggd diktering: användaren trycker på en genvägstangent, talar, och den igenkända texten dyker upp i den aktiva applikationen. I tillkännagivandet betonas att Myna bör kännas som en naturlig del av Ubuntu skrivbordet och samtidigt arbeta med hänsyn till användarens integritet. Listan över stödda inmatningsspråk vid publiceringstillfället har inte offentliggjorts.
Det första målet för projektet är Ubuntu 26.10. Vid detta steg försöker Canonical inte att skapa en fullständig röstassistent eller ett system för att styra skrivbordet med rösten. Utvecklarna har medvetet begränsat området för den första versionen till grundläggande, pålitlig diktering: tryck på tangentkombinationen, yttra texten och få resultatet i det aktuella inmatningsfältet. Den primära testmiljön är Ubuntu Desktop på Wayland med GNOME, men arkitekturen planeras att hållas tillräckligt öppen för framtida stöd för andra skrivbordsmiljöer.
Myna är avsedd för lokal taligenkänning. Efter installation av nödvändiga modeller behövs ingen internetanslutning för att dikteringen ska fungera; mikrofonen får endast användas efter att användaren aktivt har aktiverat den, ljudbehandling sker i minnet och slängs sedan, och inspelningar skickas inte till externa tjänster. I projektspecifikationen anges också att lösningen ska undvika att spara ljud som standard och inte fångas upp på ett subtilt sätt till en molntjänst.
Koden och dokumentationen för Myna publiceras i Canonicals repository på GitHub. Projektet beskrivs som en lätt tal-till-text-applikation för Ubuntu Desktop och distribueras under licensen GPL-3.0. Samtidigt är projektet fortfarande i ett tidigt skede: det finns ännu inga publicerade versioner i repositoryt, och den arkitektoniska specifikationen har status som föreslagen.
Huvudfunktioner och egenskaper i Myna
Push-to-talk diktering. Användaren håller ned en anpassningsbar genvägstangent, talar, och systemet infogar den igenkända texten i det valda inmatningsfältet. Dikteringen avslutas när tangenten släpps.
Lokal taligenkänning. IGENKÄNNING genomförs på användarens maskin via en lokal inference-stack. Detta minskar beroendet av molnet och möjliggör drift utan nätverk efter installation av modeller.
Privat ljudbehandling. Mikrofonen aktiveras endast under användarsessionen för diktering. Ljudet ska inte spelas in på disk som standard, utan använder en begränsad minnesbuffert som rensas efter sessionens slut.
Visuell aktivitetsindikator. Under inspelning och transkribering bör användaren se en tydlig statusindikator. Specifikationen nämner tillstånd som Inspelning, Transkribering, Avslutning och Fel.
Infogning av endast stabil text. I den första implementationen får inte mellanliggande hypoteser för erkännande direkt infogas i applikationen. Endast bekräftad sluttext skickas till målfältet.
Efterbearbetning av text. Rå transkription kan genomgå normalisering, punktuering, kapitalisering, formatering och omvandling av talade former till skrivna, till exempel "twenty two" → "22".
Val av dikteringsspråk. Systemet bör stödja anpassningsbart dikteringsspråk, med standardinställning baserat på användargränssnittets språk, om en lämplig modell finns tillgänglig.
Modellernas kvalitetsprofiler. Specifikationen tillhandahåller olika profiler för modeller: en lätt version med lägre resursförbrukning, en balanserad standardprofil och en mer kvalitativ, men tyngre version.
Säker hantering av inmatningsfokus. Målet för textinfogning väljs i början av sessionen. Om fokus på fönstret ändras under dikteringen ska systemet inte tyst skicka texten till en annan applikation.
Blockering i skyddade fält. Diktering ska blockeras i lösenordsfält, autentiseringsfönster och andra skyddade platser, om applikationen eller verktyget tillåter detta att identifieras.
Integration med Wayland/GNOME. Den första versionen är inriktad på Wayland och GNOME. För initial textinfogning övervägs IBus, och i framtiden planeras en mer inhemsk Wayland-väg genom input-method/text-input-protokoll.
Användarinställningar. I det planerade gränssnittet för inställningar bör det finnas alternativ för att aktivera/deaktivera STT, välja genvägstangent, dikteringsspråk, mikrofon, modellprofil, efterbearbetningsalternativ och aktivitetsindikator.
I den första iterationen ligger områdena som inte ingår i projektet kvar: väckning med nyckelfras, kontinuerlig bakgrundslyssning, molnbaserad igenkänning, röstassistent, röstkommandon, skrivbordsstyrning, talöversättning, talareigenkänning, automatisk språkidentifiering och dikteringshistorik. Med andra ord, Canonical börjar inte med "AI-assistent", utan med en mer jordnära funktion: lokal röstinmatning av text i vanliga Ubuntu-appar.
Källa: linux.org.ru
