

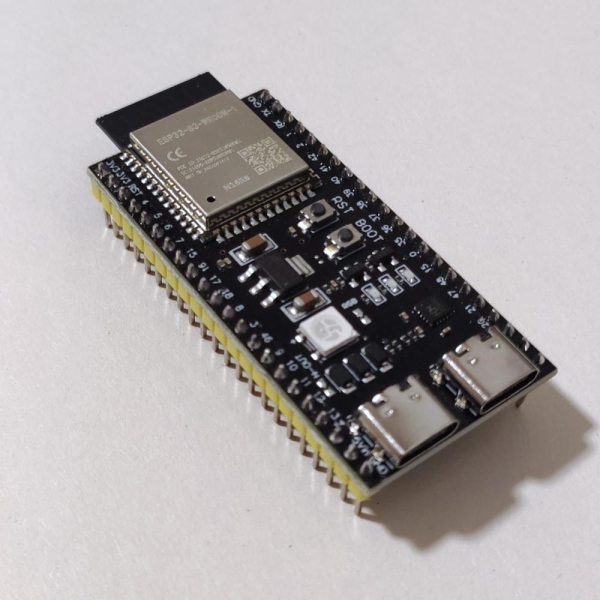
Utvecklaren Vyacheslav Serbov, som går under pseudonymen slvDev, visade en helt lokal textgenerering på mikrokontrollern ESP32-S3. Den språkmodell han skapade innehåller 28,9 miljoner parametrar och producerar cirka 9,9 token per sekund, utan att behöva kontakta en server eller andra externa beräkningsresurser. De genererade korta berättelserna visas på den anslutna OLED-skärmen.
Projektet esp32-ai testades på modulen ESP32-S3 N16R8, som har 512 KB inbyggd SRAM, 8 MB PSRAM och 16 MB flash-minne. Den kvantifierade modellen på fyra bitar tar upp 14,9 MB. I arkivet har källkoden för körmiljön i C, verktyg för träning och kvantisering av modellen, firmware, tester och skript för dess uppladdning till kortet publicerats.
De angivna 28,9 miljonerna parametrar bör inte jämföras direkt med antalet parametrar i vanliga stationära LLM. Enligt den detaljerade rapporten från utvecklaren, består modellen av en tät beräkningskärna med cirka 559 tusen parametrar, ett utmatningsskikt med 3,1 miljoner parametrar och en tabell med lagrade vektorrepräsentationer på cirka 25 miljoner parametrar. Just den sista ansvarar för den största delen av modellens formella storlek, men behandlas inte helt vid generering av varje token.
För att rymma modellen används tre nivåer av minne. De mest ofta använda uppgifterna finns i den interna SRAM, utmatningsskiktet, KV-cache och temporära buffrar finns i PSRAM, medan den 25-miljoners tabellen finns i flash-minnet och är tillgänglig genom avbildning i adressutrymmet. För varje token läses endast cirka sex rader, med en total volym på cirka 450 byte.
Denna enhet är baserad på teknologin Per-Layer Embeddings, som Google har tillämpat i Gemma 3n. Enligt Google-dokumentationen, kan PLE-parametrarna lagras utanför modellens arbetsminne och läggas till i utdata processen allteftersom individuella lager bearbetas. I esp32-ai har denna metod överförts till mikrokontrollerns minneshierarki, där snabb SRAM är särskilt begränsad.
Den första korrekta versionen av den C-baserade körmiljön producerade endast 0,57 token per sekund. Efter att ha placerat utgångslagret i PSRAM, övergått till åttabitiga aktiveringar, distribuerat beräkningar mellan två Xtensa LX7-kärnor och genomfört andra optimeringar reducerades fördröjningen till 94,9 ms per modellsteg. Den slutgiltiga uppmätta hastigheten nådde 9,88 token per sekund med hänsyn till hela genereringsprocessen. Den huvudsakliga begränsningen är nu PSRAM:s bandbredd vid läsning av utgångslagret.
Modellen är tränad på ett syntetiskt dataset TinyStories, bestående av enkla engelskspråkiga berättelser med ett begränsat ordförråd. Därför kan den fortsätta meningar och skapa korta sammanhängande historier, men den är inte avsedd för att svara på frågor, utföra instruktioner, programmera eller återge faktiska kunskaper. Utvecklaren ser arbetet främst som en demonstration av effektiv modellplacering i mikrokontrollerens minne, snarare än som en färdig autonom chattbot.
I den aktuella dokumentationen påpekar författaren särskilt att esp32-ai är en självständig utveckling. Projekten llama2.c Andrej Karpatys och en tidigare version av en 260 000-parametrars modell på ESP32-S3 nämns endast som referenser och exempel på tidigare arbeten: kod, punktkontroller och metodik har inte direkt lånats från dem. Källkoden för esp32-ai sprids under MIT-licensen.
Källa: linux.org.ru
