

Patchar för implementeringen av filsystemet BeamFS har publicerats för diskussion på mailinglistan för utvecklare av Linux-kärnan. BeamFS använder Reed-Solomon-kodning för att identifiera och återställa korrupta data på plats i konfigurationer med en enhet. De huvudsakliga användningsområdena för BeamFS inkluderar satellitens on-board-datorer, utrustning i strålningsbehandlingsrum och andra system som arbetar i högdoserade strålningsmiljöer där återställningen av förvrängda data är viktigare än möjligheten att läsa information.
Som standard kan BeamFS återställa upp till 8 förlorade byte i varje 255-byte block med en overhead på 7 % (288 byte återställningskod per 4096 byte lagrad data). Felsökningskoder används inte bara för data utan också för kontrollinformation i superblock, inode, katalogindex och bitmappar. Integritetskontroll och försök att återställa saknade data utförs vid varje läsoperation. Om det inte går att garantera dataintegriteten avbryts operationen med ett fel "-EIO", vilket förhindrar tyst återlämnande av korrupta data.
Experiment har visat att vid bestrålning av i.MX 8M Plus-kort med Linux och ext4-filsystemet med protoner med energier från 20 till 58 MeV, inträffade 90% av alla fel på filsystem- och lagringsenhetsdrivrutinsnivå. En simulering av enstaka bitfel vid läsning från lagringsmedia genomfördes: både BeamFS och Btrfs identifierade alltid dataskador och returnerade alltid ett fel, medan ext4 och ext3 tyst återlämnade förvrängda data.
BeamFS säkerställer integritet och återställning endast från läsningen av den fysiska enheten till överföringen till sidcacheminnet. Integriteten för lagring i RAM kan upprätthållas med hjälp av minneschip med felkorrigering.
En begränsning för BeamFS är bristen på stöd för journaling och Copy-on-Write (CoW)-läge — metadata skrivs osystematiskt till lagringsenheten, varför en fullständig kontroll med fsck är nödvändig vid felaktig avstängning.
Förutom BeamFS har ytterligare två filsystem nyligen föreslagits för Linux-kärnan:
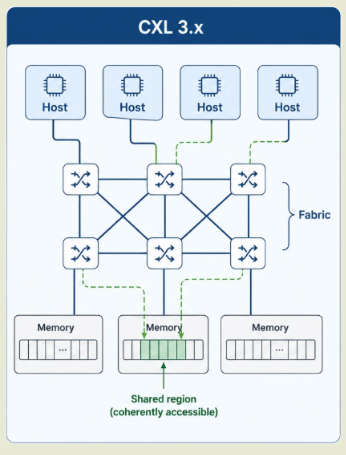
- Vid den nyligen hållna Linux Plumbers Conference 2026 presenterade en ingenjör från Huawei (video, bilder) filsystemet XMFS (cross-node eXpress Memory File System) för Linux-kärnan, avsett för användning i kluster med delat RAM-minne för alla noder (som tmpfs, men för minne för alla noder). XMFS möjliggör användning av det standardiserade POSIX-gränssnittet för filsystem för att arbeta med extern minne, adresserat direkt med hjälp av teknologier som CXL 3.0 (Compute Express Link) och Huawei United Bus. Projektet är för närvarande i experimentell prototypfas och genomgår intern testing, och är ännu inte redo att integreras i kärnan.

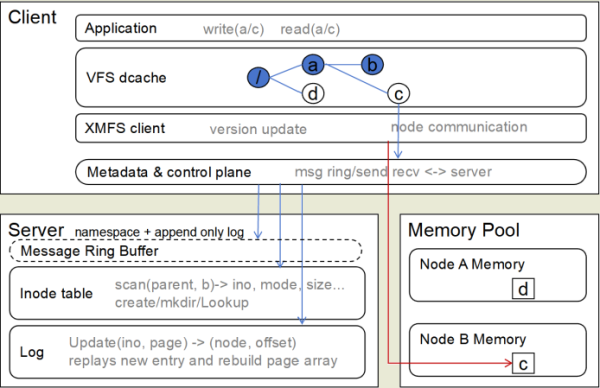
Filsystemet har en klassisk arkitektur för distribuerade filsystem med ett avsnitt som ansvarar för servern, vilket ansvarar för loggning, underhåll av inode-tabeller och matchning av innehåll och metadata med minnet för de enskilda noderna.

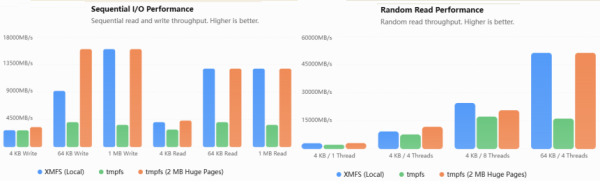
Vid testningen av XMFS för uppgifter som delad åtkomst till containeravbilder från olika noder visade implementeringen prestanda nära tmpfs med aktivering av stora minnessidor (2 MB huge pages).


- Med hjälp av AI har ett filsystem vid namn MeshXFS utvecklats, vilket är en fork av XFS, anpassad för samtidig användning över flera noder i ett kluster. MeshXFS möjliggör att montera en gemensam blockenhet i läs- och skrivläge på olika noder, upprätthålla integritet och hantera lås vid samtidig åtkomst till data. Projektet inleddes som ett experiment för att testa möjligheten att skapa en Linux-drivrutin med ett filsystem som stödjer distribuerade lås, parallell åtkomst och återställning efter fel med hjälp av AI-modeller. Huvuddelen av arbetet utfördes med Claude Opus, men för att lösa särskilt komplicerade problem engagerades även modellerna Claude Fable, GPT, Gemini och Astra. Experimentet har bedömts som framgångsrikt och flera fungerande versioner av MeshXFS har redan publicerats.
Bland de ytterligare möjligheterna som implementerats ovanpå XFS finns två lägen för hantering av distribuerade lås (nätverks-synkronisering och lagring av tillstånd på en separat gemensam disk), säkerställande av cache-konsistens på olika noder, loggning för återställning samt anpassning av diskformat och verktyg för specifikationen av klusterfilsystem. Stöd för arbete med delad lagring som är ansluten via iSCSI (testat på 16 noder), eller vid replikering av blockenhet med hjälp av DRBD. Låssynkronisering, nodupptäcktsfunktioner, tillgänglighetskontroll och identifiering av felande noder implementeras i ett gemensamt modulför kärnan. Arbete har kontrollerats i Proxmox VE 9, RHEL 9, Ubuntu 24.04/26.04 och Debian 12/13.
Källa: opennet.ru

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish