

Inom ramen för Qwenputer-projektet har forskarna förberett en utökad version av AI-modellen Qwen3.5-4B, där en inbyggd simulator för en fullständig 32-bitars CPU baserad på RISC-V-arkitektur (RV32IM) har implementerats, vilket stöder Zba-tillägget och är utrustad med en bignum-kopressessor för aritmetiska operationer med stora tal. Implementeringen av CPU-kärnan har kompilerats i ett viktuppsättning och integrerats i en större språkmodell i form av 11 ytterligare transformationslager, som har lagts till före de huvudsakliga Qwen-lagren. Beräkningarna utförs direkt under den framåtgående genomgången (forward pass) av neuronnätverket, utan att använda externa verktyg eller plugins.
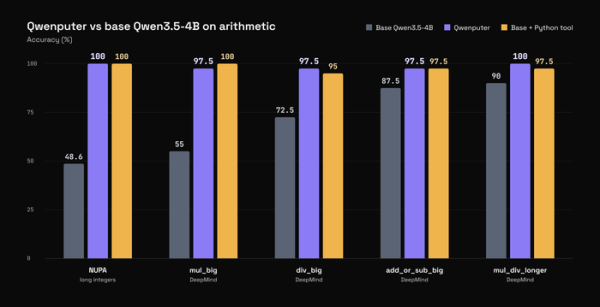
Implementeringen klarar alla tester från den officiella testuppsättningen riscv-tests och kan köra kompilerad kod på C och MicroPython. Vid aritmetiska beräkningar med stora tal säkerställer Qwenputer en noggrannhet på 97,5-100%, vilket är jämförbart med eller överträffar resultaten av den grundläggande modellen Qwen3.5 med en ansluten extern Python-tolk.
För att simulera det temporära minnet i modellen används separata lager av Gated DeltaNet (linjära RNN), som används i den vanliga AI-modellen Qwen för att bevara det ändrade tillståndet vid arbete med stora kontextfönster. Genom att fixera tillståndet för gaten och tillämpa enhetskodsning (one-hot) skrivs varje skrivförfrågan över exakt en rad i tillståndsmatrisen, vilket gör att DeltaNet-tillståndet kan användas som adresserbart minne med fast storlek, vilket undviker linjär tillväxt av KV-cache (Key-Value) när längden på kontexten ökar. I detta minne placeras CPU-registren, data och den körda maskinkoden.
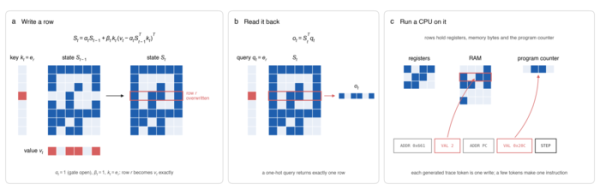
Processorinstruktioner, såsom läsning av registren, aritmetiska operationer och villkorsövergångar, kompileras direkt till vikterna i transformationslagren. Speciella token (ADDR, VAL, STEP) kopplas till varje instruktion, vilka AI-modellen tolkar som logik för CPU:n. För att initiera CPU:n och ladda fastvaran används en liten extern RvChat-drivrutin, men själva maskinkoden bearbetas helt inom modellens vikter.
Bland projektets begränsningar nämns en ungefär dubblering i storlek jämfört med den ursprungliga Qwen-modellen (18,8 GB) vid bevarande av tillståndsverk (checkpoint), vilket främst beror på tillägg av extra lager. Det noteras också att beräkningshastigheten är relativt låg (ungefär 3200 token per sekund på GPU L4), vilket gör att komplexa beräkningar kan ta sekunder istället för millisekunder.
Dessutom har en variant av AI-modellen implementerats med ett experimentellt filsystem som möjliggör lagring av upp till 512 filer med 53 000 tokens text inuti AI-modellens vikter. Liksom i implementeringen av RAM organizeras lagringen i koppling till DeltaNet-tillstånd, men skiljer sig genom att filsystemet erbjuder permanent lagring, som inte förlorar sitt tillstånd mellan sessioner.
Qwenputers framsteg har också legat till grund för forskning kring nya potentiella säkerhetsproblem i AI. Exemplet Qwenputer visar hur en särskilt modifierad AI-modell kan dölja sina resonemang i RNN-tillståndet och kringgå övervakningsmekanismer för modellens resonemang (CoT, Chain-of-Thought). Dessutom demonstrerades
möjligheten att skapa kontroll- och övervakningsmekanismer för säkerhet, inbäddade i AI-modellens vikter, som modellen själv inte kan stänga av eller ändra.
Källa: opennet.ru
