

TL;DR: För fyra år sedan lämnade jag Google med en idé om ett nytt verktyg för serverövervakning. Idén var att kombinera vanligt isolerade funktioner i en enda tjänst och analys av loggar, insamling av metrik, och en övervakningspanel. En av principerna är att tjänsten verkligen ska vara snabb, vilket ger DevOps ett lätt, interaktivt, trevligt arbete. Detta kräver bearbetning av dataset på flera gigabyte på bråkdelar av en sekund, utan att överskrida budgeten. Nuvarande verktyg för loggar är ofta långsamma och klumpiga, så vi ställdes inför en utmaning: att designa ett verktyg på ett smart sätt för att ge användarna en ny upplevelse.
I den här artikeln beskriver vi hur vi på Scalyr löste detta problem genom att tillämpa gamla metoder, en brute-force-närmande, avlägsna överflödiga lager och undvika komplexa datastrukturer. Dessa lärdomar kan du tillämpa på dina egna ingenjörsuppgifter.
Kraften av gammaldags
Logganalys börjar vanligtvis med sökning: att hitta alla meddelanden som matchar ett visst mönster. I Scalyr handlar det om tiotals eller hundratals gigabyte loggar från många servrar. Moderna metoder innebär vanligtvis att man konstruerar en komplicerad databasstruktur, optimerad för sökning. Jag har själv sett sådana i Google, där de är ganska duktiga på sådana saker. Men vi fastnade för en mycket mer grov metod: linjär skanning av loggar. Och det fungerade — vi erbjuder ett gränssnitt med sökning som är flera gånger snabbare än konkurrenternas (se animationen i slutet).
Den avgörande insikten var att moderna processorer är mycket snabba i enkla, raka operationer. Det är lätt att missa i komplexa, flerlagerssystem, som är beroende av I/O- och nätverksoperationer, och sådana system är idag mycket vanliga. Således utvecklade vi en design som minimerar antalet lager och onödig skräpa. Med flera processorer och servrar parallellt når sökhastigheten 1 TB per sekund.
Viktiga slutsatser från denna artikel:
- Grov sökning är en fullt livskraftig metod för att lösa verkliga, stora problem.
- Brute force är en designmetod, inte en lösning som frigör oss från arbetet. Liksom alla tekniker passar den bättre för vissa problem än andra och kan genomföras bra eller dåligt.
- Brute force är särskilt bra för att uppnå lösningen prestanda.
- Effektiv användning av brute force kräver kodoptimering och riktad tilldelning av tillräckligt med resurser i rätt tid. Den passar bra om dina servrar är under tung belastning som inte är användarrelaterad, medan användaroperationer prioriteras.
- Prestanda beror på hela systemdesignen, inte bara på algoritmen i den interna loopen.
(Den här artikeln handlar om datorspridning i minnet. I de flesta fall har Scalyr-servrarna redan cachat loggarna när en användare gör en sökning. I nästa artikel kommer vi att diskutera sökning genom icke-cachade loggar. Samma principer tillämpas: effektiv kod och brute force-metoden med stora beräkningsresurser).
Brute force-metoden
Traditionellt utförs sökning i stora datamängder via nyckelordsindex. När det gäller serverloggar betyder detta att man söker efter varje unikt ord i loggen. För varje ord måste en lista över alla förekomster skapas. Detta gör det enkelt att hitta alla meddelanden med detta ord, som 'error', 'firefox' eller 'transaction_16851951' — vi kollar bara i indexet.
Jag använde en sådan metod på Google och den fungerade bra. Men på Scalyr söker vi i loggarna byte för byte.
Varför? Utifrån en abstrakt algoritmisk synpunkt är nyckelordsindex mycket mer effektiva än brute force-sökning. Men vi säljer inte algoritmer, vi säljer prestanda. Och prestanda handlar inte bara om algoritmer, utan även om systemteknik. Vi måste ta hänsyn till allt: datavolym, typ av sökning, tillgänglig hårdvara och programkontext. Vi kom fram till att en variant som 'grep' passar bättre för vårt specifika problem än indexering.
Index är bra, men de har sina begränsningar. Att hitta ett ord är enkelt. Men att söka efter meddelanden med flera ord, som 'googlebot' och '404', är betydligt svårare. Att söka efter fraser som 'uncaught exception' kräver ett mer omfattande index som registrerar inte bara alla meddelanden med detta ord, utan också specifika platsen för ordet.
Verklig svårighet uppstår när du letar efter delar av ord. Låt oss säga att du vill kontrollera hur mycket trafik som kommer från botar. Den första tanken är att söka i loggarna efter ordet 'bot'. På så vis hittar du vissa botar: Googlebot, Bingbot och många andra. Men här är 'bot' inte ett ord, utan en del av ett ord. Om du söker efter 'bot' i indexet kommer vi inte att hitta meddelanden med ordet 'Googlebot'. Om vi går igenom varje ord i indexet och sedan skannar indexet efter de funna nyckelorden, kommer sökningen att ta längre tid. Som ett resultat tillåter vissa logghanteringsprogram inte sökning på delar av ord eller (i bästa fall) tillåter en speciell syntax med lägre prestanda. Vi vill undvika detta.
Ett ytterligare problem är interpunktion. Vill du hitta alla förfrågningar från 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Slutligen älskar ingenjörer kraftfulla verktyg, och ibland kan ett problem endast lösas med reguljära uttryck. Nyckelordsindexet är inte särskilt lämpligt för detta.
Dessutom är index komplexa. Varje meddelande måste läggas till i flera nyckelordlistor. Dessa listor måste ständigt hållas i ett sökvänligt format. Förfrågningar med fraser, delar av ord eller reguljära uttryck måste översättas till operationer med flera listor, och resultaten måste skannas och sammanfogas för att få en resulterande uppsättning. I kontexten av en storskalig fleranvändartjänst skapar denna komplexitet prestandaproblem som inte syns vid algoritmanalys.
Nyckelordsindex tar också upp mycket utrymme, och lagring är en stor kostnadspost i logghanteringssystem.
Å andra sidan kan varje sökning kräva mycket beräkningskraft. Våra användare uppskattar supersnabb sökning på unika förfrågningar, men sådana förfrågningar görs relativt sällan. För typiska sökförfrågningar, som till exempel för instrumentpanelen, använder vi speciella tekniker (som vi kommer att beskriva i nästa artikel). Andra förfrågningar är tillräckligt sällsynta, så att vi sällan behöver hantera mer än en i taget. Men det betyder inte att våra servrar är underutnyttjade: de är belastade med att ta emot, analysera och komprimera nya meddelanden, utvärdera aviseringar, komprimera gammal data och så vidare. På så sätt har vi en ganska stor reserv av processorer som kan användas för att utföra förfrågningar.
Brute force fungerar om du har ett brutet problem (och mycket kraft)
Brute force fungerar bäst på enkla uppgifter med små interna cykler. Ofta kan du optimera den interna cykeln för att fungera i mycket höga hastigheter. Om koden är komplex är det mycket svårare att optimera den.
I vårt ursprungliga sökkod fanns det en ganska stor intern cykel. Vi lagrar meddelanden på sidor av 4K; varje sida innehåller vissa meddelanden (i UTF-8) och metadata för varje meddelande. Metadata är en struktur där längden på värdet, interna ID:t för meddelandet och andra fält kodas. Sökningscykeln såg ut så här:
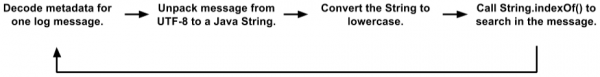
Detta är en förenklad version jämfört med den faktiska koden. Men även här syns flera placeringar av objekt, kopior av data och funktionsanrop. JVM optimerar funktionsanrop ganska bra och allokerar kortvariga objekt, så den här koden fungerade bättre än vad vi förtjänade. Under tester använde kunderna den ganska framgångsrikt. Men i slutändan tog vi steget till en ny nivå.
(Du kanske undrar varför vi lagrar meddelanden i det här formatet med sidor på 4K, text och metadata, istället för att direkt arbeta med loggar. Det finns många skäl som alla handlar om att Scalyrs interna motor liknar en distribuerad databas mer än ett filsystem. Textsökningar kombineras ofta med filter i stil med databashantering som tillämpas på fälten efter att loggarna har parsats. Vi kan samtidigt söka i många tusentals loggar, och enkla textfiler är inte lämpliga för vår transaktionella, replikerade, distribuerade datastyrning.)
Till en början verkade det som att sådan kod inte var särskilt lämplig för att optimera för metoden med brute force. "Det verkliga arbetet" i String.indexOf() dominerade inte ens CPU-profilen. Det vill säga att optimering av endast den här metoden inte skulle ge någon betydande effekt.
Det råkade bli så att vi lagrar metadata i början av varje sida, och texten av alla meddelanden är förpackad i UTF-8 i slutet. Genom att utnyttja detta skrev vi om loopen för att söka direkt över hela sidan:
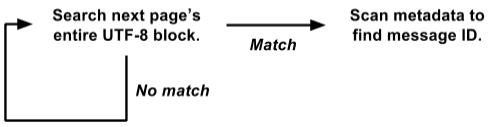
Denna version fungerar direkt på representationen av raw byte[] och utför sökningen av alla meddelanden på hela 4K-sidan samtidigt.
Det är mycket lättare att optimera för metoden med brute force. Den interna sökloopen anropas samtidigt för hela 4K-sidan, inte separat för varje meddelande. Det finns varken data-kopiering eller objektallokering. Mer komplexa operationer med metadata anropas endast vid ett positivt resultat, inte för varje meddelande. På så sätt uteslöt vi en mängd overhead, och den återstående belastningen koncentreras i en liten intern sökloop som är väl lämpad för ytterligare optimering.
Vår faktiska sökalgoritm bygger på . Den liknar Boyer-Moore-algoritmen med ett hopp ungefär lika långt som söksträngen vid varje steg. Huvudskillnaden är att den kontrollerar två byte åt gången för att minimera falska träffar.
Vår implementation kräver att vi skapar en söktabell på 64K för varje sökning, men det är ingenting jämfört med de gigabyte data vi söker igenom. Den inre loopen bearbetar flera gigabyte per sekund på ett kärna. I praktiken är den stabila prestandan omkring 1,25 GB per sekund på varje kärna, och det finns potential för förbättring. Vi kan eliminera vissa overhead-kostnader utanför den inre loopen, och vi planerar att experimentera med den inre loopen i C istället för Java.
Vi tillämpar kraft
Vi diskuterade att loggsökning kan implementeras "grovt", men hur mycket "kraft" har vi egentligen? Inte lite.
1 kärna: när det används rätt är en modern processors kärna ganska kraftfull i sig själv.
8 kärnor: för närvarande arbetar vi på Amazon-servrarna hi1.4xlarge och i2.4xlarge SSD, där var och en har 8 kärnor (16 trådar). Som nämnts ovan är dessa kärnor vanligtvis upptagna med bakgrundsoperationer. När en användare gör en sökning pausas bakgrundsoperationerna, vilket frigör alla 8 kärnor för sökning. Sökningen avslutas vanligtvis på en bråkdel av en sekund, varefter bakgrundsarbetet återupptas (regleringsprogrammet säkerställer att en ström av sökfrågor inte stör det viktiga bakgrundsarbetet).
16 kärnor: för pålitlighet organiserar vi servrar i master/slave-grupper. Varje master har underordnat en SSD-server och en EBS. Om huvudservern går ner tar SSD-servern omedelbart dess plats. Nästan hela tiden fungerar master och slave normalt, så att varje datablok är tillgänglig för sökning på två olika servrar (underordnad EBS-server har en svag processor, så vi överväger den inte). Vi delar upp uppgiften mellan dem så att vi totalt har 16 kärnor tillgängliga.
Många kärnor: i den närmaste framtiden kommer vi att distribuera data över servrar så att alla deltar i bearbetningen av varje icke-trivial förfrågan. Varje kärna kommer att vara aktiv. [Anmärkning: vi har genomfört planen och ökat sökhastigheten till 1 TB/s, se anmärkningen i slutet av artikeln].
Enkelhet ger tillförlitlighet
En annan fördel med brute force-metoden är den ganska stabila prestandan. Generellt är sökningar inte särskilt känsliga för detaljer i uppgiften och datasetet (tror jag det är därför den kallas "brute").
Nyckelordsindexet ger ibland otroligt snabba resultat, medan det i andra fall inte gör det. Anta att du har 50 GB loggar där termen ‘customer_5987235982’ förekommer exakt tre gånger. Att söka på denna term räknar direkt från indexet tre platser och avslutas omedelbart. Men en komplex sökning med wildcard kan skanna tusentals nyckelord och ta mycket tid.
Å andra sidan utförs bruteforce-sökning för alla förfrågningar med mer eller mindre samma hastighet. Sökning efter långa ord är bättre, men även sökningen av en enda bokstav går tillräckligt snabbt.
Enkelheten hos bruteforce-metoden innebär att dess prestanda ligger nära det teoretiska maximumet. Här finns det färre alternativ för oförutsedd överbelastning av diskar, blockkonflikter, pekarkollisioner och tusentals andra orsaker till misslyckanden. Jag tittade just på de förfrågningar som gjordes av Scalyr-användare förra veckan på vår mest belastade server. Det fanns 14 000 förfrågningar. Exakt åtta av dem tog mer än en sekund; 99% utfördes inom 111 millisekunder (om du inte har använt logganalysverktyg, tro mig: det är snabbt).
Stabil och pålitlig prestanda är viktig för användarens komfort. Om tjänsten periodiskt laggar kommer användarna att uppfatta den som opålitlig och kommer att vara ovilliga att använda den.
Loggsökning i aktion
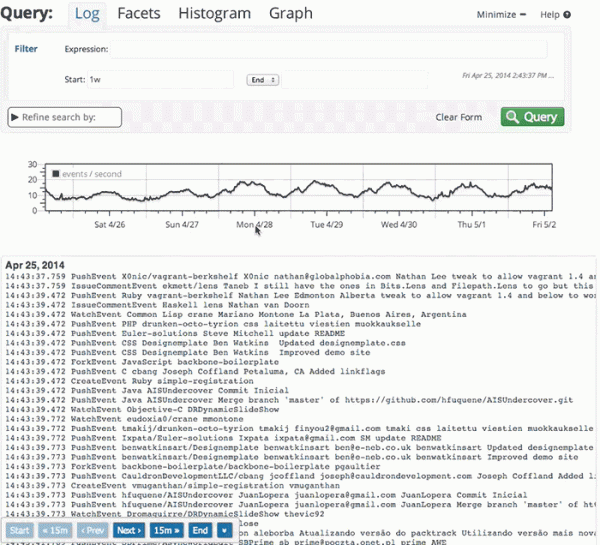
Här är en liten animation som visar Scalyrs sökning i aktion. Vi har ett demokonto där vi importerar varje händelse från varje offentligt repository på Github. I denna demonstration granskar jag data från en vecka: cirka 600 MB råloggar.
Videon spelades in live, utan särskild förberedelse, på min desktop (ungefär 5000 kilometer från servern). Prestandan som du kommer att se beror till stor del på , samt en snabb och pålitlig backend. Varje gång det uppstår en paus utan indikatorn ‘loading’ stannar jag för att du ska hinna läsa vad jag planerar att klicka på.
Avslutningsvis
När man hanterar stora datamängder är det viktigt att välja en bra algoritm, men "bra" betyder inte "komplicerad". Tänk på hur din kod kommer att fungera i praktiken. Vissa faktorer som kan ha stor betydelse i den verkliga världen faller bort i den teoretiska analysen av algoritmer. Enklare algoritmer är lättare att optimera och mer stabila i gränssituationer.
Tänk också på den kontext där koden kommer att köras. I vårt fall behövs tillräckligt kraftfulla servrar för att hantera bakgrundsuppgifter. Användare initierar relativt sällan sökningar, så vi kan låna en hel grupp servrar under den korta period som krävs för att genomföra varje sökning.
Med hjälp av brute force-metoden har vi implementerat en snabb, pålitlig och flexibel sökning över en loggsamling. Vi hoppas att dessa idéer blir användbara för dina projekt.
Ändring: Rubriken och texten har ändrats från "Sök med hastighet på 20 GB per sekund" till "Sök med hastighet på 1 TB per sekund" för att återspegla prestandaförbättringar under de senaste åren. Denna hastighetsökning beror främst på förändringar i typ och antal EC2-servrar som vi idag ställer upp för att stödja en växande kundbas. Snart förväntas förändringar som ger ytterligare en kraftig ökning av effektiviteten, och vi ser fram emot att få möjlighet att berätta om det.
Källa: habr.com
