

Den 26 februari höll vi meeten Apache Ignite GreenSource, där bidragsgivare från open source-projektet deltog. . En viktig händelse i detta samhälles liv var omstruktureringen av komponenten , som gör det möjligt att distribuera användarspecifika mikrotjänster direkt i Ignite-klustret. Om denna komplexa process berättade , mjukvaruingenjör och bidragsgivare till Apache Ignite i mer än två år.
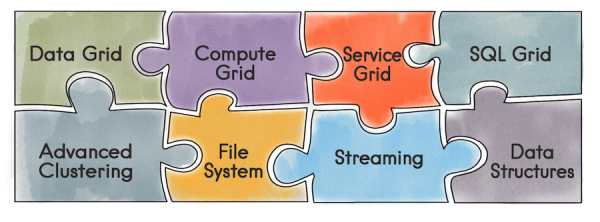
Låt oss börja med vad Apache Ignite egentligen är. Det är en databas som utgör ett distribuerat Key/Value-lager med stöd för SQL, transaktioner och caching. Dessutom gör Ignite det möjligt att distribuera användarspecifika tjänster direkt i Ignite-klustret. Utvecklare får tillgång till alla verktyg som Ignite erbjuder — distribuerade datatyper, Messaging, Streaming, Compute och Data Grid. Till exempel, vid användning av Data Grid försvinner problemet med att administrera en separat infrastruktur för datalagring och följaktligen de kostnader som följer med detta.
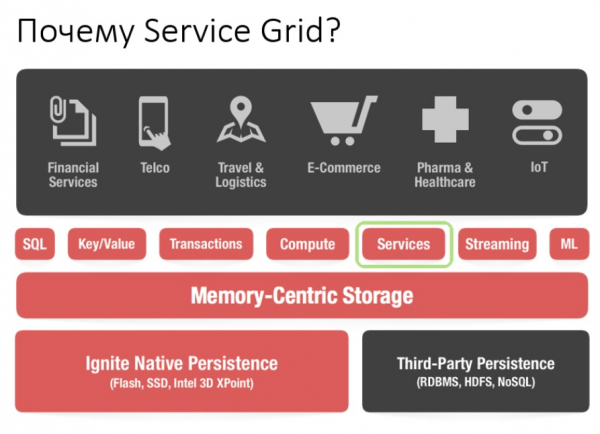
Genom att använda API:et för Service Grid kan du distribuera en tjänst genom att enkelt ange distributionsschemat i konfigurationen och därmed själva tjänsten.
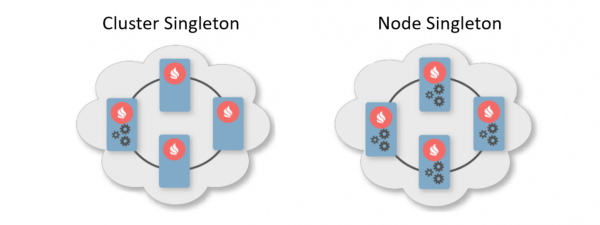
Vanligtvis är distributionsschemat en angivelse av antalet instanser som ska distribueras på klustrets noder. Det finns två typiska distributionsscheman. Det första är Cluster Singleton: vid varje given tidpunkt kommer en instans av den användarspecifika tjänsten garanteras vara tillgänglig i klustret. Det andra är Node Singleton: varje nod i klustret har en instans av tjänsten distribuerad.
Användaren kan också ange antalet instanser av tjänsten i hela klustret och definiera ett predikat för att filtrera lämpliga noder. I ett sådant scenario beräknar Service Grid själv den optimala distributionen för distribuerade tjänster.
Dessutom finns det en funktion som kallas Affinity Service. Affinity är en funktion som definierar kopplingen mellan nycklar och partitioner samt kopplingen mellan partitioner och noder i topologin. Genom nyckeln kan den primära noden fastställas där data lagras. På så sätt kan din egen tjänst kopplas till nyckeln och cachen för affinity-funktionen. Vid en förändring av affinity-funktionen kommer en automatisk omdeployeringsprocess att ske. Således kommer tjänsten alltid att placeras nära den data den ska manipulera, och därmed minska overheadkostnaderna för att få tillgång till information. Denna typ av schema kan kallas en form av kolokaliserade beräkningar.
Nu när vi har diskuterat vad som är fördelarna med Service Grid, låt oss prata om dess utvecklingshistoria.
Vad som var tidigare
Den tidigare implementeringen av Service Grid baserades på en transaktionell replikerad systemcache Ignite. Med "cache" avses i Ignite ett datalager. Det är alltså inte något temporärt, som man kanske skulle kunna tro. Även om cachen är replikerad och varje nod innehåller hela datamängden, har cachen en partitionerad representation. Detta är kopplat till optimering av lagringslösningar.
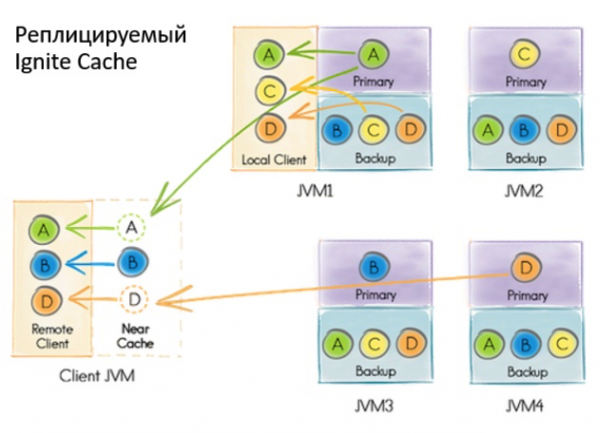
Vad hände när en användare ville distribuera en tjänst?
- Alla noder i klustret prenumererade på uppdateringar av data i lagret med hjälp av den inbyggda mekanismen för Continuous Query.
- Initiatornoden gjorde en databaspost under en read-committed transaktion, som innehöll tjänstens konfiguration, inklusive en serialiserad instans.
- Vid mottagandet av en ny postberäkning från koordinatören beräknades distributionen utifrån konfigurationen. Den erhållna objektet skrivs tillbaka till databasen.
- Om noden ingick i distributionen, hade koordinatören ansvar för att distribuera den.
Vad som inte tillfredsställde oss
Vid en viss tidpunkt kom vi fram till att det inte gick att arbeta med tjänster på det här sättet. Det fanns flera anledningar.
Om det uppstod något fel under distributionen kunde man endast få information om det från loggarna på den nod där händelsen inträffade. Det fanns bara asynkron distribution, så efter att kontrollen återställts till användaren från distributionsmetoden behövdes viss extra tid för att starta tjänsten — under denna tid kunde användaren inte hantera något. För att vidareutveckla Service Grid, skapa nya funktioner, locka nya användare och göra livet enklare för alla var förändring nödvändig.
Vid utformning av det nya Service Grid ville vi först och främst erbjuda en garanti för synkron distribution: så snart användaren får kontrollen tillbaka från API:et, kan hen omedelbart använda tjänsterna. Vi ville också ge initiativtagaren möjlighet att hantera distributionsfel.
Dessutom ville vi underlätta implementeringen, nämligen avveckla transaktioner och ombalansering. Trots att cachen är replikerad och det inte finns någon balans, uppstod problem under stora distributioner med många noder. Vid förändringar i topologin måste noderna utbyta information, och vid stora distributioner kan dessa uppgifter väga mycket.
När topologin var instabil behövde koordinatoren omberäkna fördelningen av tjänsterna. Och generellt sett, när man måste arbeta med transaktioner på en instabil topologi, kan det leda till svårförutsägbara fel.
Problem
Vilka globala förändringar skulle det vara utan medföljande problem? Den första av dessa var förändringen av topologin. Man måste förstå att i varje ögonblick, även under distributionen av en tjänst, kan en nod gå med i klustret eller lämna det. Dessutom, om en nod går med i klustret under distributionen, måste all information om tjänsterna överföras konsekvent till den nya noden. Detta handlar inte bara om det som redan har distribuerats, utan också om aktuella och framtida distributioner.
Detta är bara ett av problemen som kan samlas i en separat lista:
- Hur distribuerar man statiskt konfigurerade tjänster när en nod startar?
- Vad ska man göra om en nod lämnar klustret och den hade hostat tjänster?
- Vad ska man göra om koordinatoren har bytts?
- Vad ska man göra om klienten kopplar om till klustret?
- Måste aktiverings-/deaktiveringsförfrågningar bearbetas och hur?
- Och vad händer om destruktorn för cachen anropades, men vi har affinitets-tjänster kopplade till den?
Och detta är långt ifrån allt.
Lösning
Som mål valde vi en Event Driven-ansats med implementering av kommunikation mellan processer via meddelanden. I Ignite finns redan två komponenter som möjliggör att noder skickar meddelanden mellan varandra - communication-spi och discovery-spi.
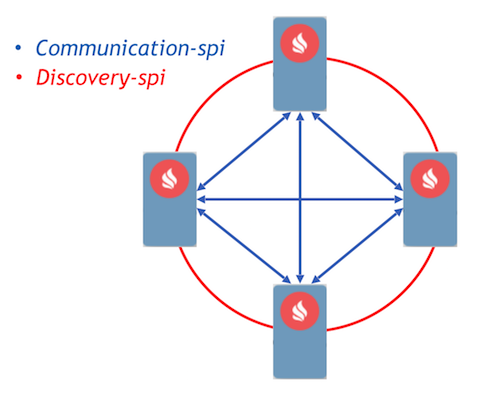
Communication-spi möjliggör direkt kommunikation och meddelandeöverföring mellan noder. Det är väl lämpat för överföring av stora datamängder. Discovery-spi tillåter att skicka ett meddelande till alla noder i klustret. I den standardimplementeringen görs detta enligt "ringtopologi". Det finns också en integration med Zookeeper, där "stjärntopologi" används. En viktig punkt att nämna är att discovery-spi garanterar att meddelandet kommer att levereras i rätt ordning till alla noder.
Låt oss överväga distributionsprotokollet. Alla användarförfrågningar om distribution och borttagning skickas via discovery-spi. Detta ger följande garantier:
- Förfrågan kommer att mottas av alla noder i klustret. Detta möjliggör fortsatt behandling av förfrågan vid byte av koordinator. Det betyder också att varje nod, vid ett meddelande, får all nödvändig metadata, som tjänsteconfig och dess serialiserade instans.
- Strikt ordning för meddelandeleverans möjliggör lösning av konfigurationskonflikter och konkurrerande förfrågningar.
- Eftersom noder som går in i topologin också hanteras via discovery-spi, får den nya noden all nödvändig information för att arbeta med tjänster.
Vid mottagning av en förfrågan validerar noderna i klustret den och skapar uppgifter för bearbetning. Dessa uppgifter placeras i en kö och bearbetas sedan i en annan tråd av en separat arbetare. Detta är implementerat på detta sätt eftersom distribution kan ta betydande tid och försena den dyra discovery-flödet är oacceptabelt.
Alla förfrågningar från kön bearbetas av distributionshanteraren. Den har en specialiserad arbetare som hämtar uppgiften från denna kö och initierar den för att påbörja distributionen. Efter detta sker följande åtgärder:
- Varje nod beräknar självständigt fördelningen baserat på den nya deterministiska tilldelningsfunktionen.
- Noderna formar ett meddelande med resultaten av distributionen och skickar det till koordinatorn.
- Koordinatorn aggregerar alla meddelanden och formar resultatet av hela distributionsprocessen, vilket skickas via discovery-spi till alla noder i klustret.
- Vid mottagning av resultatet avslutas distributionsprocessen, varefter uppgiften tas bort från kön.
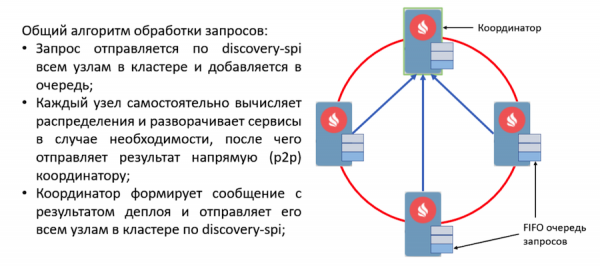
Ny event-driven design: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Om ett fel inträffar vid distributionen, inkluderar noden omedelbart detta fel i meddelandet som skickas till koordinatorn. Efter aggregationen av meddelanden kommer koordinatorn att ha information om alla fel under distributionen och skicka detta meddelande via discovery-spi. Information om felen kommer att vara tillgänglig på vilken nod som helst i klustret.
Alla viktiga händelser i Service Grid bearbetas enligt denna algoritm. Till exempel, en toppologiförändring är också ett meddelande via discovery-spi. Generellt sett, jämfört med vad som fanns tidigare, har protokollet blivit tillräckligt lättviktigt och pålitligt. Tillräckligt för att hantera alla situationer under distributionen.
Vad som kommer härnäst
Nu om planerna. Varje större förbättring i projektet Ignite genomförs som en insats för att förbättra Ignite, så kallad IEP. Redesignen av Service Grid har också en IEP - med ett skämtsamt namn "Byte av olja i Service Grid". Men i själva verket har vi inte bara bytt olja i motorn, utan hela motorn.
Vi har delat upp uppgifterna i IEP i två faser. Första fasen är en stor fas som går ut på att omarbeta distributionsprotokollet. Den har redan slagits samman med huvudgrenen, så man kan prova den nya Service Grid som kommer i version 2.8. Den andra fasen inkluderar många andra uppgifter:
- Hot-swap-distribution
- Versionshantering av tjänster
- Ökad felresiliens
- Tunn klient
- Övervakningsverktyg och mätning av olika metrikser
Avslutningsvis kan vi rekommendera Service Grid för att bygga felresistenta system med hög tillgänglighet. Vi bjuder också in er till och för att dela med er av er erfarenhet. Er erfarenhet är verkligen viktig för gemenskapen, den hjälper till att förstå i vilken riktning vi ska gå vidare och hur vi kan utveckla komponenten framöver.
Källa: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish