

Introduktion till operativsystem
Hej, Habr! Jag vill presentera för er en serie översättningsartiklar av en intressant litteratur — OSTEP. I detta material behandlas djupgående hur unix-liknande operativsystem fungerar, nämligen arbetet med processer, olika schemaläggare, minne och andra liknande komponenter som utgör ett modernt OS. Originalet av allt material kan du se här . Observera att översättningen är utförd oprofessionellt (relativt fritt), men jag hoppas att jag har bevarat den övergripande meningen.
Laborationsarbeten för detta ämne kan hittas här:
Andra delar:
Och du kan också kolla in min kanal på =)
Introduktion till schemaläggaren
Kärnan i problemet: Hur man utvecklar en schemaläggarpolicy
Hur bör de grundläggande ramverken för schemaläggarpolicyer utvecklas? Vilka bör vara nyckelförutsättningarna? Vilka mätvärden är viktiga? Vilka grundläggande tekniker användes i tidiga datorsystem?
Arbetslastantaganden
Innan vi diskuterar möjliga policyer, låt oss först göra några förenklade avstickare om de processer som körs i systemet, tillsammans kallade arbetslast. Att definiera arbetslasten är en kritisk del av att bygga policyer, och ju mer du vet om lasterna, desto bättre policy kan du skriva.
Låt oss göra följande antaganden om processerna som körs i systemet, ibland även kallade jobs (uppgifter). Praktiskt taget alla dessa antaganden är orealistiska, men de behövs för att främja tankegången.
- Varje uppgift körs under samma tid,
- Alla uppgifter sätts samtidigt,
- En inlagt uppgift körs till den är färdig,
- Alla uppgifter använder endast CPU,
- Körtiden för varje uppgift är känd.
Schemaläggarens mätvärden
Förutom vissa antaganden om belastningen behövs också ett verktyg för att jämföra olika schemaläggarpolicyer: schemaläggarens mätvärden. En mätvärde är helt enkelt ett mått på något. Det finns ett antal mätvärden som kan användas för att jämföra schemaläggare.
Som exempel ska vi använda en mätning som kallas vändtid (turnaround time). Vändtiden för en uppgift definieras som skillnaden mellan tiden då uppgiften avslutas och tiden då uppgiften anlände till systemet.
Tturnaround=Tcompletion−Tarrival
Eftersom vi antog att alla uppgifter anlände samtidigt, så är Ta=0 och därmed Tt=Tc. Detta värde kommer naturligtvis att ändras när vi ändrar de ovanstående antagandena.
En annan mätvärde är rättvisa (fairness). Prestanda och rättvisa är ofta motstridiga egenskaper inom schemaläggning. Till exempel kan en schemaläggare optimera prestanda, men på bekostnad av att andra uppgifter får vänta, vilket därmed minskar rättvisan.
FÖRST IN FÖRST UT (FIFO)
Den mest grundläggande algoritmen som vi kan implementera kallas FIFO eller first come (in), first served (out). Denna algoritm har flera fördelar: den är mycket enkel att implementera och den passar alla våra antaganden, vilket gör att den fungerar ganska bra.
Låt oss titta på ett enkelt exempel. Anta att 3 uppgifter ställts samtidigt. Men anta att uppgift A kom lite tidigare än de andra, så den kommer att stå först i kö, precis som B i förhållande till C. Låt oss anta att var och en av dem kommer att utföras på 10 sekunder. Vad blir då den genomsnittliga tiden för att slutföra dessa uppgifter?
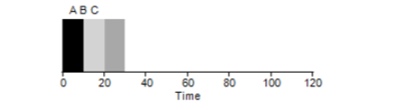
Genom att räkna värdena — 10+20+30 och dela med 3 får vi den genomsnittliga tiden för programmet som är 20 sekunder.
Nu ska vi försöka ändra våra antaganden. Speciellt antagande 1 och så vi inte längre antar att varje uppgift tar lika lång tid. Hur kommer FIFO att fungera denna gång?
Det visar sig att olika exekveringstider för uppgifter har en extremt negativ påverkan på FIFO-algoritmens produktivitet. Anta att uppgift A kommer att exekveras i 100 sekunder, medan både B och C fortfarande kommer att vara 10 sekunder var.
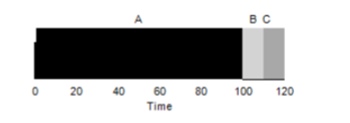
Som man kan se från bilden, kommer den genomsnittliga tiden för systemet att bli (100+110+120)/3=110. Denna effekt kallas karavaneffekten, där vissa kortvariga resurskonsumenter står i kö efter en tung konsument. Det liknar en kö i en livsmedelsbutik, där du står bakom en kund med en full kundvagn. Den bästa lösningen på problemet är att försöka byta kassa eller att slappna av och andas djupt.
Kortaste jobb först
Finns det något sätt att lösa en sådan situation med tunga processer? Självklart. En annan typ av schemaläggning kallasKortaste jobb först (SJF). Dess algoritm är också ganska primitiv — som namnet antyder, kommer de kortaste uppgifterna att startas först en efter en.
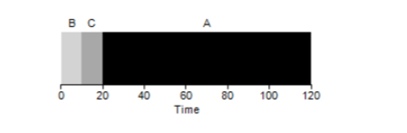
I det här exemplet kommer resultatet av att köra samma processer att förbättra den genomsnittliga genomströmningstiden för programmen och den kommer att vara 50 istället för 110, vilket är nästan 2 gånger bättre.
Således, baserat på antagandet att alla uppgifter anländer samtidigt, verkar SJF-algoritmen vara den mest optimala. Men våra antaganden verkar fortfarande inte realistiska. Denna gång ändrar vi antagande 2 och föreställer oss att uppgifter kan anlända när som helst, snarare än alla samtidigt. Vilka problem kan detta leda till?
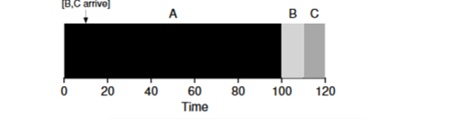
Låt oss föreställa oss att uppgift A (100s) anländer först och påbörjar körningen. Vid tidpunkten t=10 anländer uppgifter B, C, som var och en tar 10 sekunder. Därmed beräknas genomsnittlig exekveringstid till (100+(110-10)+(120-10))/3 = 103. Vad skulle schemaläggaren kunna göra för att förbättra situationen?
Shortest Time-to-Completion First (STCF)
För att förbättra situationen släpper vi antagande 3 om att programmet körs och arbetar till dess avslut. Dessutom behöver vi hårdvarustöd och som ni kan gissa, kommer vi att använda en timer för att avbryta en körande uppgift och växla kontexter. Således kan schemaläggaren vid ankomsten av uppgifter B, C — avbryta uppgift A och börja bearbeta uppgifter B och C, och efter deras slutförande fortsätta köra process A. En sådan schemaläggare kallas STCFeller Preemptive Job First.
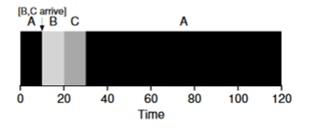
Resultatet av detta schemaläggarens arbete blir: ((120-0)+(20-10)+(30-10))/3=50. Därmed blir denna schemaläggare ännu mer optimal för våra uppgifter.
Metrik Svarstid (Response Time)
Så, om vi känner till bearbetningstiden för uppgifterna och att dessa uppgifter bara använder CPU, skulle STCF vara det bästa beslutet. I de tidiga dagarna fungerade dessa algoritmer ganska bra. Men nu tillbringar användaren större delen av sin tid vid terminalen och förväntar ett produktivt interaktivt samspel. Så föddes den nya metrik — svarstid (response time).
Svarstid beräknas enligt följande:
Tresponse=Tfirstrun−Tarrival
Således, i det tidigare exemplet, blir svarstiden: A=0, B=0, C=10 (abg=3,33).
Och algoritmen STCF är faktiskt inte så bra i situationer där tre uppgifter anländer samtidigt - den måste vänta tills de små uppgifterna är helt avslutade. Således är algoritmen bra för turnaround-timing, men dålig för interaktivitet. Tänk dig att du sitter vid en terminal och försöker skriva tecken i en redigerare, men du måste vänta mer än 10 sekunder eftersom en annan uppgift ockuperar processorn. Det är inte särskilt trevligt.
Så vi stöter på ett annat problem - hur kan vi bygga en schemaläggare som är känslig för respons-tid?
Round Robin
För att lösa detta problem har en algoritm utvecklats Round Robin (RR). Grundidén är ganska enkel: istället för att köra uppgifter tills de är helt avslutade, ska vi köra en uppgift under en viss tidsperiod (kallad tidskvant) och sedan växla till en annan uppgift i kön. Algoritmen upprepar sitt arbete tills alla uppgifter är avslutade. Under tiden måste programmets körtid vara ett multipel av tiden då timern avbryter processen. Till exempel, om timern avbryter processen var tionde millisekund, då bör fönsterstorleken för processens exekvering vara ett multipel av 10 och vara 10, 20 eller x*10.
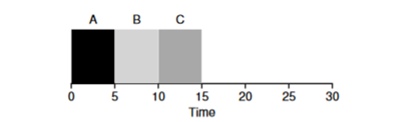
Låt oss ta ett exempel: Uppgifterna A, B och C anländer samtidigt till systemet och var och en vill köra i 5 sekunder. SJF-algoritmen kommer att utföra varje uppgift till slutet innan den startar en annan. Till skillnad från detta kommer RR-algoritmen med en körfönster på 1 sekund att gå igenom uppgifterna på följande sätt (se bild 4.3):
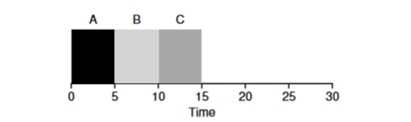
(SJF Again (Dålig för Respons-Tid)
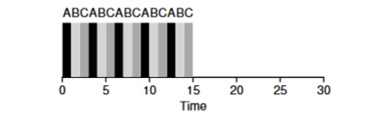
(Round Robin (Bra För Respons-Tid)
Det genomsnittliga svarstiden för RR-algoritmen (0+1+2)/3=1, medan för SJF (0+5+10)/3=5.
Det är rimligt att anta att tidsfönstret är en mycket viktig parameter för RR; ju mindre det är, desto högre är responstiden. Dock får man inte göra det för litet, eftersom tiden för kontextbyte också kommer att spela sin roll i den övergripande prestandan. Därför ställs tidsfönstret in av operativsystemets arkitekt och beror på de uppgifter som planeras att köras. Kontextbyte är inte den enda systemoperation som tar tid – det körda programmet interagerar med många andra saker, till exempel olika cacher, och vid varje byte måste denna miljö sparas och återställas, vilket också kan ta mycket tid.
RR är en utmärkt schemaläggare om det endast handlar om responstidsmetrik. Men hur beter sig metrik för uppgiftens omsättningshastighet med denna algoritm? Låt oss titta på exemplet ovan, där A, B, C = 5s och de kommer in samtidigt. Uppgift A avslutas vid 13, B vid 14, C vid 15s, och den genomsnittliga omsättningstiden blir 14s. Därför är RR den sämsta algoritmen för omsättningsmetrik.
Mer generellt kan man säga att varje algoritm av RR-typ är rättvis; den delar CPU-arbetstiden jämnt mellan alla processer. Och på så sätt står dessa metrikar konstant i konflikt med varandra.
Således har vi flera motsatta algoritmer och det kvarstår också flera antaganden – att uppgiftens tid är känd och att uppgiften endast använder CPU.
Blandning med I/O
Först och främst ska vi ta bort antagandet 4, att processen bara använder CPU; det är naturligtvis inte så, och processerna kan också begära annan hårdvara.
Vid den tidpunkt då en process begär en in- och utmatningsoperation går processen in i ett blockerat tillstånd och väntar på att I/O ska slutföras. Om I/O skickas till hårddisken kan en sådan operation ta flera millisekunder eller längre, och CPU:n kommer vara idle under denna tid. Under denna tid kan schemaläggaren använda CPU:n för en annan process. Den nästa beslutsfattning som schemaläggaren måste göra är när processen kommer att slutföra sin I/O. När det händer kommer ett avbrott att inträffa, och operativsystemet kommer att överföra den process som begärde I/O till ett redo-tillstånd.
Låt oss betrakta ett exempel med flera uppgifter. Varje uppgift behöver 50 ms processor tid. Men den första kommer att göra ett I/O-anrop var tionde millisekund (som också kommer att köras under 10 ms). Och process B använder helt enkelt 50 ms processor utan I/O.
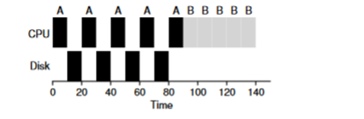
I detta exempel kommer vi att använda STCF-schemaläggaren. Hur kommer schemaläggaren att bete sig om vi kör process A? Den kommer att agera på följande sätt — först fullföljer den helt process A, och sedan process B.
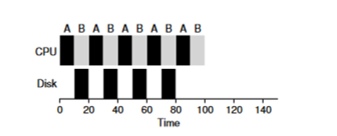
Den traditionella metoden för att lösa detta problem är att tolka varje 10 ms deluppgift av process A som en separat uppgift. Därför, när man startar med algoritmen STJF, är valet mellan en 50 ms uppgift och en 10 ms uppgift uppenbart. När deluppgiften A är slutförd kommer process B och I/O att köras. Efter att I/O är slutfört kommer vi återigen att starta process A på 10 ms istället för process B. På så sätt är det möjligt att realisera överlappning, där CPU används av en annan process medan den första väntar på I/O. Resultatet är att systemet utnyttjas bättre — när interaktiva processer väntar på I/O kan andra processer köras på processorn.
Oraklet finns inte längre
Låt oss nu försöka göra oss av med antagandet att uppgiftens körtid är känd. Detta är i stort sett det sämsta och mest orealistiska antagandet på hela listan. Faktiskt vet den genomsnittliga vanliga operativsystemet vanligtvis mycket lite om körtiden för uppgifter, hur skulle vi då bygga en schemaläggare utan att veta hur länge en uppgift kommer att köras? Kanske skulle vi kunna använda vissa principer från RR för att lösa detta problem?
Resultat
Vi har tittat på grundläggande idéer om uppgiftsschemaläggning och granskat två familjer av schemaläggare. Den första kör den kortaste uppgiften först och ökar därmed genomloppstiden, medan den andra fördelar tiden jämnt mellan alla uppgifter, vilket ökar svarstiden. Båda algoritmerna är dåliga där de andra familjens algoritmer är bra. Vi har också sett hur parallell användning av CPU och I/O kan förbättra prestandan, men vi har inte löst problemet med operativsystemets clairvoyance. På nästa lektion kommer vi att titta på en schemaläggare som ser till det närmaste förflutet och försöker förutsäga framtiden. Den kallas multi-level feedback queue.
Källa: habr.com
