

Att skriva den här artikeln inspirerades av den stora mängden material om statisk analys som allt oftare dyker upp. För det första är det , som aktivt marknadsför sig på Habr med hjälp av recensioner av fel som hittats av deras verktyg i projekt med öppen källkod. Nyligen implementerade PVS-studio , och självklart kunde utvecklarna av IntelliJ IDEA, vars inbyggda analysator idag är den mest avancerade för Java, .
Vid läsningen av sådana recensioner får man känslan av att det handlar om ett magiskt elixir: tryck på en knapp, och här är listan över defekter framför ögonen. Det verkar som att ju mer avancerade analysatorerna blir, desto fler buggar kommer automatiskt att upptäckas, och produkter som skannats av dessa robotar kommer att bli allt bättre utan några ansträngningar från vår sida.
Men det finns inga magiska elixir. Jag skulle vilja prata om vad som vanligtvis inte nämns i inlägg som "det här är vad vår robot kan hitta": vad analysatorer aldrig kan göra, vilken deras verkliga roll och plats är i mjukvaruleveransprocessen, och hur man implementerar dem på rätt sätt.
Hraavoqik (källa: ).
Vad statiska analysatorer aldrig kommer att kunna
Vad innebär det, ur ett praktiskt perspektiv, att analysera källkoden? Vi matar in vissa källfiler, och på kort tid (mycket kortare än att köra tester) får vi viss information om vårt system. En grundläggande och matematiskt oöverkomlig begränsning är att vi på detta sätt endast kan få en ganska snäv klass av information.
Det mest kända exemplet på ett problem som inte kan lösas med statisk analys är : detta är en teorem som bevisar att det är omöjligt att utveckla en allmän algoritm som utifrån källkoden till ett program kan avgöra om det kommer att gå i en oändlig loop eller avslutas inom en ändlig tid. En utvidgning av denna teorem är , som hävdar att för varje icke-trivial egenskap av beräkningsbara funktioner är definitionen av huruvida ett godtyckligt program beräknar en funktion med en sådan egenskap en algoritmiskt olöslig uppgift. Till exempel, det är omöjligt att skriva en analysator som, för vilken källkod som helst, avgör om det analyserade programmet är en implementering av en algoritm som beräknar, låt oss säga, kvadraten av ett heltal.
Därför har funktionaliteten hos statiska analysatorer oöverkomliga begränsningar. En statisk analysator kommer aldrig att kunna i alla fall identifiera sådana saker som till exempel uppkomsten av "null pointer exception" i språk som tillåter null-värden, eller i alla fall identifiera förekomsten av "attribute not found" i språk med dynamisk typning. Allt som den mest avancerade statiska analysatorn kan göra är att lyfta fram exceptionella fall, vars antal bland alla möjliga problem med din källkod utan överdrift är en droppe i havet.
Statisk analys är inte buggsökning
Av det ovanstående framgår slutsatsen: statisk analys är inte ett verktyg för att minska antalet defekter i programmet. Jag vågar påstå att vid första tillämpningen på ditt projekt kommer den att hitta "intressanta" ställen i koden, men mycket troligt kommer den inte att hitta några defekter som påverkar din programs prestanda.
Exempel på defekter som automatiskt upptäckts av analysatorer är imponerande, men man bör inte glömma att dessa exempel hittades genom att skanna ett stort antal omfattande kodbaser. På samma sätt som hackare, som har möjlighet att försöka några enkla lösenord på många konton, så småningom hittar de konton som har ett enkelt lösenord.
Betyder detta att statisk analys inte ska tillämpas? Självklart inte! Och av exakt samma anledning som man bör kontrollera varje nytt lösenord mot en lista över "enkla" lösenord.
Statiska analyser är mer än buggsökning
I själva verket är de praktiskt lösbara uppgifterna som analyseras mycket bredare. Eftersom statisk analys överlag är vilken kontroll av koden som helst som utförs före dess körning. Här är några saker man kan göra:
- Kodgranskning i vid bemärkelse av ordet. Detta inkluderar både formateringskontroll och sökning efter användning av överflödiga/överblivna parenteser, inställning av tröskelvärden för metrik som antal rader/cykelmatisk komplexitet för metoder etc. — allt som potentiellt försvårar läsbarheten och underhållbarheten av koden. I Java är ett sådant verktyg Checkstyle, i Python — flake8. Program av denna typ kallas vanligtvis "linters".
- Analys kan göras inte bara på körbar kod. Resursfiler såsom JSON, YAML, XML, .properties kan (och bör!) automatiskt verifieras för giltighet. Det är bättre att upptäcka att strukturen för JSON har brutits på grund av ojämna citationstecken i ett tidigt skede av automatisk kontroll av Pull Request, än vid körning av tester eller under körtid? Relevanta verktyg finns: exempelvis, , .
- Kompilering (eller parsing för dynamiska programmeringsspråk) är också en form av statisk analys. Generellt kan kompilatorer ge varningar som signalerar problem med kvaliteten på källkoden, och dessa bör inte ignoreras.
- Ibland är kompilering inte bara kompilering av körbar kod. Om du till exempel har dokumentation i formatet , så kan i samband med att den omvandlas till HTML/PDF, AsciiDoctor () ge varningar, exempelvis om brutna interna länkar. Och detta är en stark anledning att inte godkänna en Pull Request med ändringar i dokumentationen.
- Stavningskontroll är också en form av statisk analys. Verktyget kan kontrollera stavning inte bara i dokumentation utan också i källkoder (kommentarer och litteraler) på olika programmeringsspråk, inklusive C/C++, Java och Python. Stavfel i användargränssnittet eller dokumentationen är också en defekt!
- Konfigurationstester (om vad det är — se och föredrag), även om de körs i miljön för modulära testtyper som pytest, är faktiskt också en typ av statisk analys, eftersom de inte kör källkoden under sin körning.
Som vi ser spelar felletande i denna lista den minst viktiga rollen, och allt annat är tillgängligt genom att använda gratis open source-verktyg.
Vilka av dessa typer av statisk analys bör användas i ditt projekt? Självklart, ju fler desto bättre! Det viktigaste är att implementera det korrekt, vilket vi kommer att diskutera nästa.
Leveranspipeline som en flertrinsfilter och statisk analys som dess första steg
Den klassiska metaforen för kontinuerlig integration är en pipeline där ändringar flödar — från ändring av källkoden till leverans i produktion. Den standardiserade sekvensen av steg i denna pipeline ser ut så här:
- statisk analys
- kompilering
- modultester
- integreringstester
- UI-tester
- manuell kontroll
Ändringar som avvisas vid steg N i pipelinen går inte vidare till steg N+1.
Varför just så, och inte på något annat sätt? I den del av pipelinen som rör tester får testare lära sig om den välkända testpyramiden.
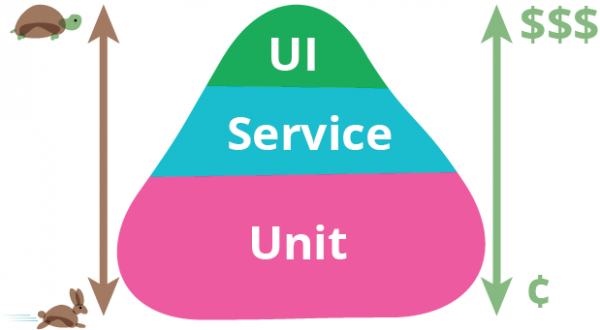
Testpyramiden. Källa: Martin Fowler.
I den nedre delen av denna pyramid finns tester som är lättare att skriva, som körs snabbare och som inte tenderar att ge falska positiva resultat. Därför bör det finnas fler av dem, de bör täcka mer kod och köras först. I den övre delen av pyramiden är det tvärtom, varför antalet integreringstester och UI-tester bör minskas till ett absolut minimum. Människan i denna kedja är den dyraste, långsammaste och mest opålitliga resursen, därför befinner den sig i slutet och utför arbete endast om de föregående stegen inte har upptäckt några defekter. Men samma principer gäller även för pipeline i delar som inte direkt rör testning!
Jag skulle vilja föreslå en analogi med ett flertrins vattenfilter. På ingången matas smutsigt vatten (ändringar med defekter) och på utgången bör vi få rent vatten, där alla oönskade föroreningar är borttagna.
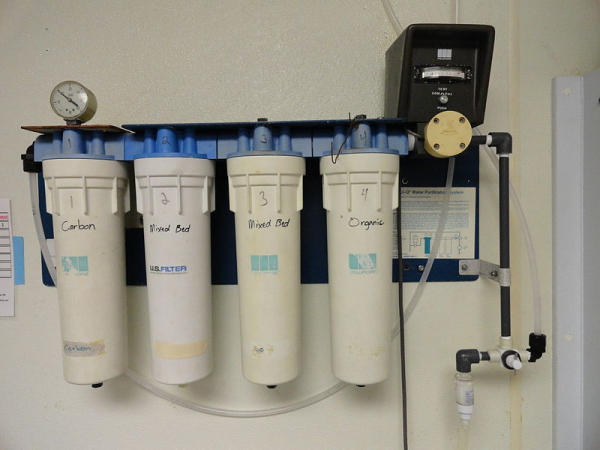
Flertrinsfilter. Källa:
Som bekant är rengörande filter utformade så att varje följande steg kan filtrera bort allt finare fraktioner av föroreningar. I detta sammanhang innebär det att de grova reningsstegen har högre kapacitet och lägre kostnad. I vår analogi betyder detta att de ingående kvalitetsportarna har bättre prestanda, kräver mindre ansträngning för att starta och är mindre krävande i användningen — och just i den sekvensen är de organiserade. Rollen av statisk analys, som vi nu förstår kan fånga upp endast de mest grova felen — är som ett
Statisk analys förbättrar i sig självt inte kvaliteten på den slutliga produkten, precis som en grov filtrering inte gör vattnet drickbart. Ändå är dess betydelse uppenbar i den övergripande kedjan av andra element i processen. Även om utgångsstegen i ett flerstegsf filter potentiellt kan fånga upp samma saker som ingångsstegen — är det tydligt vilka konsekvenser det får att utesluta ingångssteget och bara förlita sig på fina reningssteg.
Målet med den grova filtreringen är att avlasta efterföljande steg från att fånga grova defekter. Till exempel, i varje fall, bör personen som gör kodgranskning inte behöva distraheras av felaktigt formaterad kod och brott mot fastställda kodningsnormer (som överflödiga parenteser eller för djupt nästlade strukturer). Buggar som NPE bör fångas av enhetstester, men om analysverktyget redan före testen påpekar att en bugg oundvikligen kommer att inträffa — kommer detta att påskynda dess rättelse betydligt.
Jag antar att det nu är klart varför statisk analys inte förbättrar produktens kvalitet om den tillämpas sporadiskt, och att den bör tillämpas kontinuerligt för att avvisa förändringar med grova defekter. Frågan om huruvida användningen av statisk analysator förbättrar kvaliteten på din produkt är ungefär densamma som att fråga "kommer dricksvattnet, taget från en smutsig vattenkälla, förbättras om det passerar genom en sikt?"
Implementering i ett legacy-projekt
Ett viktigt praktiskt spörsmål: hur implementerar man statisk analys i processen för kontinuerlig integration som en "quality gate"? När det gäller automatiska tester är allt uppenbart: det finns en uppsättning tester, misslyckande av vilket som helst av dem är en tillräcklig grund för att anse att bygget inte har passerat quality gate. Att försöka på samma sätt sätta en gate baserat på resultaten av statisk analys misslyckas: på legacy-kod finns det alldeles för många varningar från analysen, man vill inte helt ignorera dem, men det går inte heller att stoppa produkten bara för att det finns varningar från analysverktyget.
När det appliceras för första gången på vilket projekt som helst ger analysverktyget en enorm mängd varningar, där den absoluta majoriteten inte har något att göra med produktens korrekta funktion. Att omedelbart åtgärda alla dessa anmärkningar är inte möjligt, och många av dem behöver inte åtgärdas. Vi vet ju att vår produkt fungerar i stort, även innan införandet av statisk analys!
Som ett resultat begränsar många sig till sporadisk användning av statisk analys, eller använder den bara i informationsläge, där det bara ges en rapport från analysverktyget vid bygget. Detta är likvärdigt med avsaknaden av någon analys, eftersom om vi redan har ett antal varningar så förblir det ett förbisett problem om det dyker upp ytterligare en (oavsett hur allvarlig) vid kodändring.
Följande metoder för att införa quality gates är kända:
- Att sätta en gräns för det totala antalet varningar eller antalet varningar delat med antalet kodrader. Detta fungerar dåligt, eftersom en sådan gate lätt släpper igenom ändringar med nya defekter så länge deras gräns inte överskrids.
- Vid en viss tidpunkt kan alla gamla varningar i koden hanteras som ignorerade, vilket gör att byggprocessen misslyckas vid nya varningar. Denna funktionalitet erbjuds av PVS-studio och vissa onlinetjänster, som Codacy. Jag har inte arbetat med PVS-studio, men när det gäller min erfarenhet av Codacy ligger deras största problem i att avgöra vad som är ett "gammalt" respektive "nytt" fel – en ganska svår och inte alltid korrekt fungerande algoritm, speciellt om filer har förändrats kraftigt eller fått nya namn. Från min erfarenhet har Codacy kunnat hoppa över nya varningar i en pull-request samtidigt som den kan avvisa en pull request på grund av varningar som inte relaterar till ändringarna i koden för denna PR.
- Enligt min mening är den mest effektiva lösningen den som beskrivs i boken »ratcheting»-metoden. Huvudidén är att varje version har ett antal varningar från statisk analys, och endast sådana ändringar tillåts som inte ökar det totala antalet varningar.
Ratcheting
Det fungerar så här:
- I det första steget registreras antalet varningar i koden som hittas av analysatorerna i metadata om versionen. Därmed registreras vid bygget av huvudgrenen i din repository manager inte bara "version 7.0.2", utan "version 7.0.2 med 100500 Checkstyle-varningar". Om du använder en avancerad repository manager (som Artifactory) är det enkelt att spara sådan metadata om din version.
- Nu jämför varje pull request under bygget det antal varningar som skapas med det antal som finns i den aktuella versionen. Om PR:n ökar detta antal passerar koden inte kvalitetstestet för statisk analys. Om antalet varningar minskar eller förblir oförändrat – då passerar det.
- Vid nästa version kommer det omräknade antalet varningar att skrivas in i metadata för versionen igen.
Så småningom, men stadigt (som när man arbetar med en spärr), kommer antalet varningar att sträva mot noll. Naturligtvis kan systemet manipuleras genom att införa en ny varning, men genom att åtgärda någon annans. Detta är okej, eftersom det ger resultat på lång sikt: varningar åtgärdas oftast inte en i taget, utan i en grupp av ett visst slag, och alla lättåtgärdade varningar åtgärdas ganska snabbt.
I denna graf visas det totala antalet Checkstyle-varningar under ett halvår av arbete med en sådan "spärr" på . Antalet varningar har minskat med en ordning, och detta har skett på ett naturligt sätt, parallellt med produktutvecklingen!
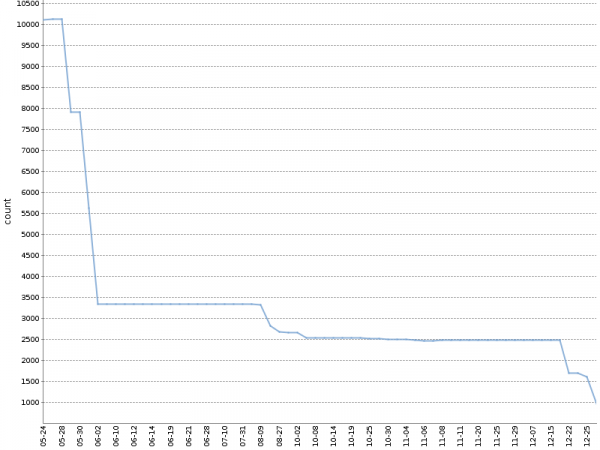
Jag använder en modifierad version av denna metod, där jag separat räknar varningar uppdelat efter projektmoduler och analysverktyg, den genererade YAML-filen med metadata om bygget ser ungefär ut så här:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
I varje avancerad CI-system kan en "spärr" implementeras för alla statiska analysverktyg, utan att förlita sig på plugins och tredjepartsverktyg. Varje analysverktyg ger sin rapport i ett enkelt text- eller XML-format, som enkelt kan analyseras. Det återstår bara att ange den nödvändiga logiken i CI-skriptet. Du kan se hur detta har implementerats i våra open source-projekt baserat på Jenkins och Artifactory eller . Båda exemplen beror på biblioteket : metoden countWarnings() räknar normalt xml-taggar i filer som genereras av Checkstyle och Spotbugs, och compareWarningMaps() implementerar just den spärren, och kastar ett fel om antalet varningar i någon av kategorierna ökar.
En intressant implementering av "ratchet" är möjlig för att analysera stavningen av kommentarer, textsträngar och dokumentation med hjälp av aspell. Som bekant är inte alla ord som är okända för den standardordbok som används felaktiga när man kontrollerar stavningen; de kan läggas till i en användardictionary. Om man gör användardictionaryn till en del av projektets källkod kan kvalitetsgränsen för stavning formuleras på följande sätt: att köra aspell med standard- och användardictionary. hitta några stavfel.
Om betydelsen av att fastställa versionen av analyzern
Avslutningsvis är det viktigt att notera följande: oavsett hur ni implementerar analysen i er leveranspipeline, bör versionen av analyzern alltid fastställas. Om analyzern tillåts uppgraderas av sig själv kan nya defekter "dyka upp" vid byggandet av nästa pull request, vilket inte är relaterat till förändringar i koden, utan beror på att den nya analyzern helt enkelt kan hitta fler defekter — vilket kan förstöra er process för godkännande av pull requests. Uppgradering av analyzern ska vara en medveten åtgärd. I allmänhet är strikt fastställande av version för varje komponent i bygget ett nödvändigt krav och ett ämne för en separat diskussion.
Slutsatser
- Statisk analys kommer inte att hitta några buggar eller förbättra kvaliteten på er produkt som resultat av en engångsapplikation. Den positiva effekten på kvaliteten ges endast genom kontinuerlig användning av den i leveransprocessen.
- Att hitta buggar är överhuvudtaget inte huvudsyftet med analysen; den överväldigande majoriteten av de användbara funktionerna är tillgängliga i opensource-verktyg.
- Implementera kvalitetsgränser baserat på resultaten av statisk analys redan i det första steget av leveranspipen, användande "ratchet" för legacy-kod.
Länkar
- en presentation om olika kodanalysmetoder (inte bara statisk!)
Källa: habr.com
