

RabbitMQ – en med Erlang skrivna meddelandebroker som möjliggör att skapa en fel-tolerant kluster med full datareplication över flera noder, där varje nod kan hantera läs- och skrivförfrågningar. Med många kluster Kubernetes i produktion stöder vi ett stort antal RabbitMQ-installationer och har stött på behovet av att migrera data från ett kluster till ett annat utan driftstopp.
Denna operation var nödvändig för oss i minst två fall:
- Överföring av data från ett RabbitMQ-kluster som inte är i Kubernetes till ett nytt – redan "kuberneteserat" (d.v.s. som fungerar i K8s-poddar) – kluster.
- Migrering av RabbitMQ inom Kubernetes från ett namespace till ett annat (t.ex. om konturerna är avgränsade av namnrymder, för att överföra infrastrukturen från ett kontur till ett annat).
Receptet som föreslås i artikeln är inriktat på situationer (men begränsas inte till dem) där det finns ett gammalt RabbitMQ-kluster (t.ex. med 3 noder) som antingen redan är i K8s eller på några gamla servrar. Ett applikation arbetar med detta, som är placerad i Kubernetes (redan där eller i framtiden):
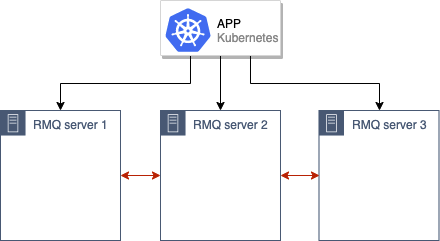
… och vi står inför uppgiften att migrera den till en ny produktion i Kubernetes.
Först kommer den allmänna metoden för själva migreringen att beskrivas, och först därefter tekniska detaljer för dess genomförande.
Migreringsalgoritm
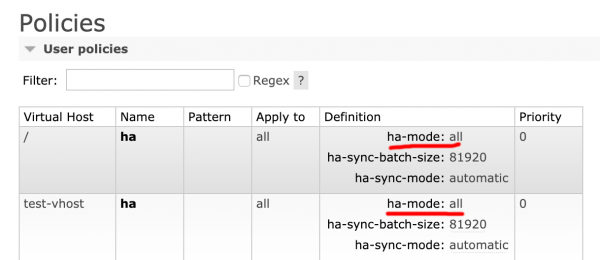
Det första, preliminära steget innan några åtgärder – kontrollera att den gamla RabbitMQ-installationen har hög tillgänglighet aktiverad (). Anledningen är uppenbar – vi vill ju inte förlora några data. För att genomföra denna kontroll kan du gå in i RabbitMQ:s adminpanel och under fliken Admin → Policies kontrollera att värdet är inställt på ha-mode: all:
Nästa steg – vi upprättar ett nytt RabbitMQ-kluster i K8s-poddar (i vårt fall till exempel med 3 noder, men antalet kan vara annat).
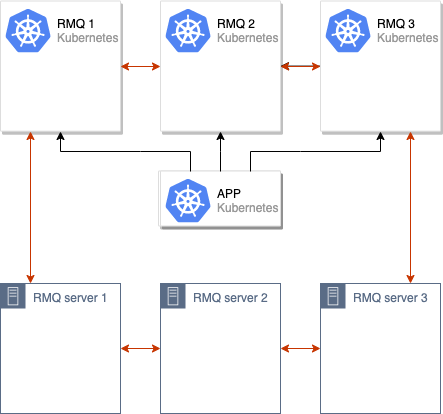
Därefter slår vi samman det gamla och det nya RabbitMQ-klustret, vilket ger oss ett enda kluster (med 6 noder):
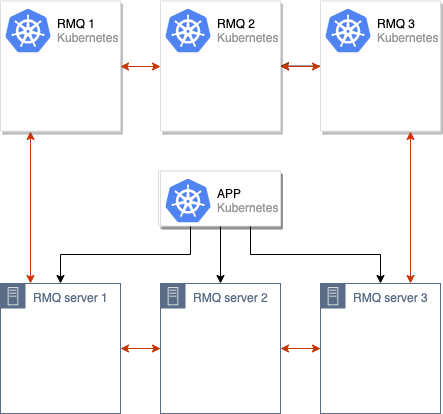
Processen för datasykronisering mellan det gamla och det nya RabbitMQ-klustret initieras. När alla data har synkroniserats mellan alla noder i klustret kan vi byta applikationen till att använda det nya klustret:
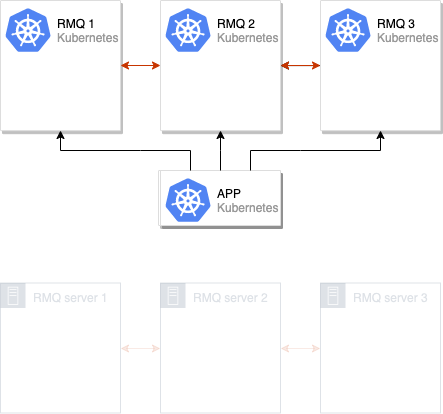
Efter dessa operationer räcker det att ta bort de gamla noderna från RabbitMQ-klustret, och flytten kan anses vara avslutad:
Denna lösning har vi använt flera gånger i vår produktion. Men för vår egen bekvämlighet har vi implementerat den inom en specialiserad system, som sprider standardkonfigurationer av RMQ på flera Kubernetes-kluster. (för dem som är nyfikna: det handlar om , om vilken vi ). Nedan kommer separata instruktioner att presenteras som var och en kan tillämpa på sina installationer för att prova den föreslagna lösningen i praktiken.
Testar i praktiken
Krav
Specifikationerna är mycket enkla:
- Kubernetes-kluster (minikube fungerar också);
- RabbitMQ-kluster (kan även distribueras på bare metal och skapas som ett vanligt kluster i Kubernetes från den officiella Helm-diagrammet).
För exemplet nedan har jag distribuerat RMQ i Kubernetes och kallat den rmq-old.
Förberedelse av stand
1. Ladda ner Helm-diagrammet och redigera det lite:
helm fetch --untar stable/rabbitmq-ha För bekvämlighetens skull anger vi lösenordet, ErlangCookie och gör en policy ha-all, så att köerna som standard synkroniseras mellan alla noder i RMQ-klustret:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
    "definition": {
      "ha-mode": "all",
      "ha-sync-mode": "automatic",
      "ha-sync-batch-size": 81920
    }
  }
2. Installera diagrammet:
helm install . --name rmq-old --namespace rmq-old3. Gå in i RabbitMQ-administrationsgränssnittet, skapa en ny kö och lägg till några meddelanden. De kommer att behövas för att vi efter migrationen ska kunna säkerställa att alla data har bevarats och att vi inte har förlorat något:

Teststandet är klart: vi har en 'gammal' RabbitMQ med data som behöver flyttas.
Migration av RabbitMQ-kluster
1. Först ska vi distribuera en ny RabbitMQ i annan namnrymden med samma ErlangCookie och lösenord för användaren. För detta gör vi de ovan beskrivna operationerna, ändrar den slutliga installationskommandot för RMQ till följande:
helm install . --name rmq-new --namespace rmq-new2. Nu behöver den nya klustern sammanfogas med den gamla. För detta går vi in i varje av pod'arna ny RabbitMQ och kör kommandona:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
I variabeln OLD_RMQ är adressen till en av noderna i den gamla RMQ-klustret.
Dessa kommandon kommer att stoppa den aktuella noden ny i RMQ-klustret, koppla den till det gamla klustret och starta den igen.
3. RMQ-klustret med 6 noder är klart:
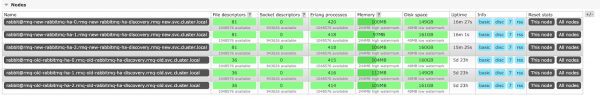
Du måste vänta tills meddelandena synkroniseras mellan alla noder. Det är inte svårt att gissa att tiden för meddelandesynkronisering beror på kapaciteten hos den hårdvara där klustret är implementerat och antalet meddelanden. I det beskrivna scenariot finns det totalt 10 meddelanden, så datan synkroniserades omedelbart, men med ett tillräckligt stort antal meddelanden kan synkroniseringen ta timmar.
Så, status för synkronisering:

Här +5 betyder att meddelandena redan finns om på 5 noder (förutom den som anges i fältet Node). Därmed har synkroniseringen genomförts framgångsrikt.
4. Det återstår bara att växla applikationens RMQ-adress till det nya klustret (specifika åtgärder här beror på vilken teknikstack du använder och andra specifika egenskaper hos applikationen), efter vilket du kan säga adjö till det gamla.
För den sista operationen (dvs. efter växling av applikationen till det nya klustret), går vi in på varje nod i den gamla i klustret och utför kommandona:
rabbitmqctl stop_app
rabbitmqctl reset
Klustret har "glömt" de gamla noderna: du kan ta bort den gamla RMQ, och flytten kommer att vara avslutad.
Anmärkning: Om du använder RMQ med certifikat förändras ingenting principiellt — flyttprocessen kommer att genomföras på precis samma sätt.
Slutsatser
Det beskrivna schemat passar praktiskt taget för alla situationer när vi behöver flytta RabbitMQ eller helt enkelt flytta till ett nytt kluster.
I vårt fall uppstod svårigheter bara en gång, när RMQ anropades från många ställen och vi inte hade möjlighet att ändra RMQ-adressen överallt. Då startade vi en ny RMQ i samma namespaces med samma etiketter, så att den skulle matcha de redan existerande tjänsterna och Ingressarna, och när vi startade podden manipulerade vi etiketter manuellt, tog bort dem i början så att ingen förfrågan hamnade på den tomma RMQ, och lade tillbaka dem efter synkronisering av meddelanden.
Samma strategi tillämpade vi vid uppgradering av RabbitMQ till en ny version med ändrad konfiguration — allt fungerade som en klocka.
P.S.
Som en logisk fortsättning på detta material förbereder vi artiklar om MongoDB (migration från en fysisk server till Kubernetes) och MySQL (hur vi förbereder denna DBMS inom Kubernetes). De kommer att publiceras inom de kommande månaderna.
P.P.S.
Läs även i vår blogg:
- «»;
- «».
Källa: habr.com
