

Som i , uppstod ett problem med den distribuerade tjänsten, låt oss kalla den Elvin. Den här gången upptäckte jag inte problemet själv, jag fick veta det av killarna från klientsidan.
En gång vaknade jag av ett missnöjt mejl på grund av stora förseningar med Elvin, som vi planerade att lansera inom kort. Specifikt stötte kunden på en försening på 99:e percentilen på omkring 50 ms, mycket över vår budget för försening. Det var förvånande, eftersom jag noggrant testade tjänsten, speciellt för förseningar, eftersom det är en källa till frekventa klagomål.
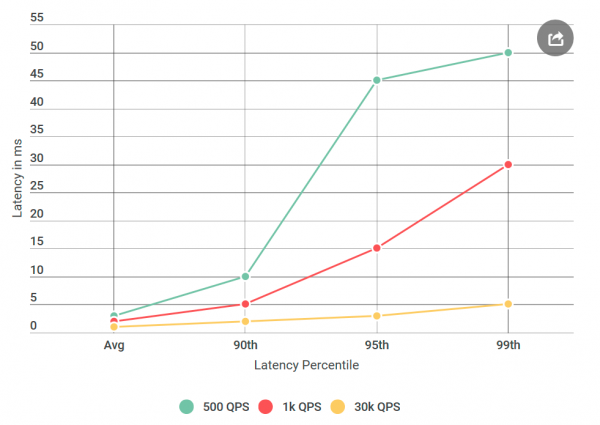
Innan jag skickade Elvin för testning genomförde jag många experiment med 40 000 förfrågningar per sekund (QPS), alla visade en försening på mindre än 10 ms. Jag var beredd att hävda att jag inte höll med deras resultat. Men när jag tittade på mejlet igen, lade jag märke till något nytt: jag testade tydligen inte de förhållanden de nämnde, deras QPS var betydligt lägre än min. Jag testade vid 40k QPS, medan de bara var vid 1k. Jag körde ytterligare ett experiment, denna gång med lägre QPS, bara för att tillfredsställa dem.
Eftersom jag skriver om detta på bloggen - ni har troligen redan förstått: deras siffror visade sig vara korrekta. Jag kontrollerade min virtuella klient gång på gång, alltid med samma resultat: ett lågt antal förfrågningar ökade inte bara förseningen, utan ökade också antalet förfrågningar med fördröjning över 10 ms. Med andra ord, om vid 40k QPS omkring 50 förfrågningar per sekund överskred 50 ms, så var det vid 1k QPS 100 förfrågningar över 50 ms varje sekund. Ett paradox!
Snäva in sökningen
När man står inför ett problem med försening i ett distribuerat system med många komponenter, är det första steget att göra en kort lista över misstänkta. Låt oss gräva lite djupare i Elvins arkitektur:
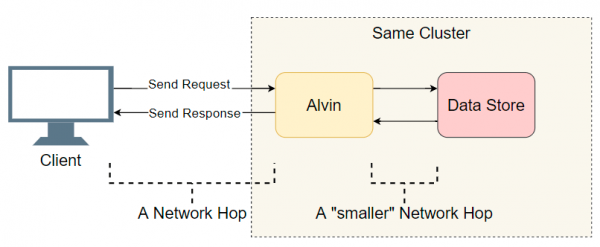
En bra utgångspunkt är listan över utförda I/O-operationer (nätverksanrop/diskåtkomst osv.). Låt oss försöka ta reda på var förseningen uppstår. Förutom den uppenbara I/O med klienten gör Elvin ett extra steg: han kontaktar datalagringen. Men detta lagringssystem fungerar i samma kluster som Elvin, så där borde förseningen vara mindre än med klienten. Så, listan över misstänkta:
- Nätverksanrop från klienten till Elvin.
- Nätverksanrop från Elvin till datalagringen.
- Diskåtkomst i datalagringen.
- Nätanrop från datalagringen till Elvin.
- Nätanrop från Elvin till klienten.
Låt oss försöka stryka vissa punkter.
Datalagringen är inte inblandad
Först konverterade jag Elvin till en ping-ping-server som inte hanterar förfrågningar. Vid mottagning av en förfrågan returnerar den ett tomt svar. Om fördröjningen minskar, är felet antingen i Elvin eller datalagringen – ingenting särskilt ovanligt. I det första experimentet får vi en sådan graf:
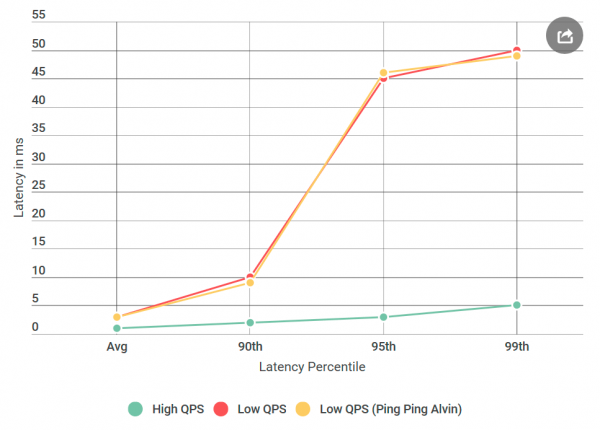
Som vi ser visar inga förbättringar sig vid användning av ping-ping-servern. Detta innebär att datalagringen inte ökar fördröjningen, och listan över misstänkta minskar med hälften:
- Nätverksanrop från klienten till Elvin.
- Nätanrop från Elvin till klienten.
Fantastiskt! Listan minskar snabbt. Jag trodde att jag nästan hade listat ut orsaken.
gRPC
Nu är det dags att presentera en ny aktör: . Detta är ett bibliotek med öppen källkod från Google för interprocesskommunikation . Även om gRPC det är väloptimerat och används i stor utsträckning, använde jag det för första gången i ett system i denna storlek, och jag förväntade mig att min implementering skulle vara suboptimal – för att uttrycka det milt.
Närvaron av gRPC i stacken gav upphov till en ny fråga: kanske det är min implementering eller själva gRPC som orsakar fördröjningen? Låt oss lägga till en ny misstänkt i listan:
- Klienten anropar biblioteket
gRPC - Bibliotek
gRPCutför ett nätanrop till biblioteketgRPCpå servern - Bibliotek
gRPCkontaktar Elvin (inversion finns inte i fallet med ping-pong-server)
För att du ska få en uppfattning om hur koden ser ut, skiljer sig min klient/Elvin-implementation inte mycket från traditionella klient-server-exempel .
Notering: den ovanstående listan är något förenklad, eftersom
gRPCden möjliggör användning av en egen (mall?) trådmodell, där exekveringsstackengRPCoch användarimplementeringen flätas samman. För enkelhetens skull kommer vi att hålla oss till denna modell.
Profileringsverktyg kommer att lösa allt
Genom att stryka datalagringarna trodde jag att jag nästan var klar: "Nu är det enkelt! Låt oss tillämpa en profil och se var fördröjningen uppstår." Jag , eftersom CPUerna är mycket snabba och oftast inte är flaskhalsar. De flesta fördröjningar uppstår när processorn måste avbryta bearbetningen för att göra något annat. Exakt CPU-profilering är just för detta: den registrerar noggrant alla och ger insikt om var fördröjningarna uppstår.
Jag tog fyra profiler: en för hög QPS (låg latens) och en med ping-pong-server på låg QPS (hög latens), både på klientsidan och serversidan. Och bara för säkerhets skull tog jag också ett prov på CPU-profilen. När jag jämför profilerna letar jag vanligtvis efter anomalier i stackspåren. Till exempel på den dåliga sidan med hög latens sker det mycket fler kontextbyten (10 gånger eller mer). Men i mitt fall var antalet kontextbyten nästan detsamma. Till min förskräckelse fanns det inget väsentligt att hitta.
Ytterligare felsökning
Jag var i djup förtvivlan. Jag visste inte vilka andra verktyg jag kunde använda, och min nästa plan var i praktiken att upprepa experimenten med olika variationer istället för att tydligt diagnostisera problemet.
Vad händer om
Från allra första början oroade jag mig för den specifika latensen på 50 ms. Det är en mycket hög tid. Jag bestämde mig för att jag skulle skära bort delar av koden tills jag kunde lista ut exakt vilken del som orsakar detta fel. Sedan följde ett experiment som lyckades.
Som vanligt verkar det i efterhand som att allt var uppenbart. Jag satte klienten på samma maskin som Elvin – och skickade en begäran till localhost. Och latensökningen försvann!
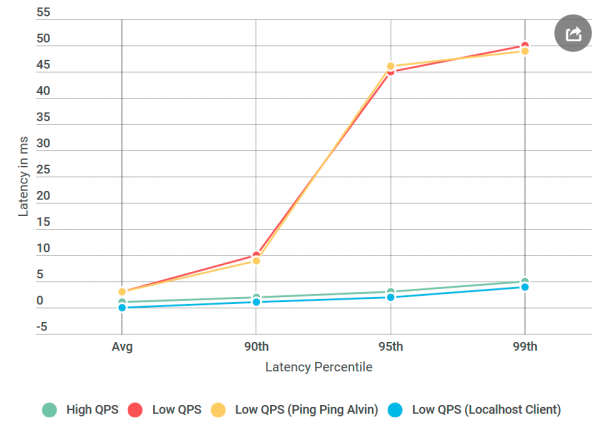
Något var fel med nätverket.
Vi lär oss nätverksingenjörens färdigheter
Jag måste erkänna: mina kunskaper om nätverkstekniker är fruktansvärda, särskilt med tanke på att jag arbetar med dem dagligen. Men nätverket var den huvudmisstänkte, och jag behövde lära mig hur man felsöker det.
Som tur är älskar internet dem som vill lära sig. Kombinationen av ping och tracert verkade vara en bra början för att felsöka problem med nätverkstrafiken.
Först körde jag på TCP-porten för Elvin. Jag använde standardinställningarna – inget speciellt. Av mer än tusen pingar översteg ingen 10 ms, förutom den första för uppvärmning. Detta står i kontrast till den observerade latensen på 50 ms i 99:e percentilen: där skulle vi på varje 100 förfrågningar se ungefär en förfrågan med en latens på 50 ms.
Sedan försökte jag : kanske var problemet på en av noderna längs vägen mellan Elvin och klienten. Men traceroten kom tillbaka med tomma händer.
Så orsaken till latensen var varken min kod, implementationen av gRPC eller nätverket. Jag började redan oro mig för att jag aldrig skulle förstå detta.
Vilken operativsystem använder vi nu
gRPC är allmänt använt i Linux, men för Windows är det exotiskt. Jag beslutade mig för att göra ett experiment som fungerade: jag skapade en virtuell Linux-maskin, kompilerade Alvin för Linux och distribuerade den.
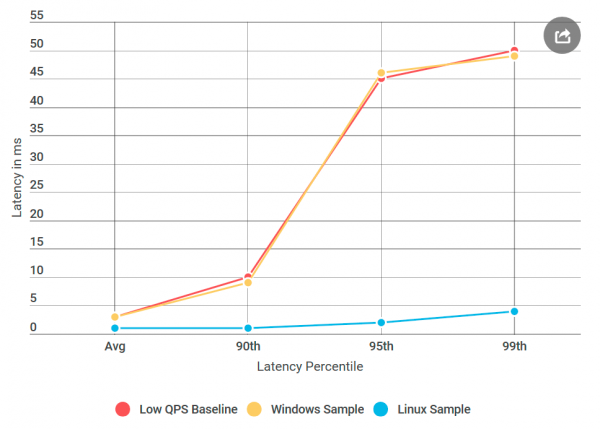
Och här är vad som hände: i Linux ping-pong-servern fanns det inte de förseningar som den motsvarande Windows-noden hade, trots att datakällan inte skilde sig. Det visar sig att problemet är implementeringen av gRPC för Windows.
Nagle-algoritmen
Under hela denna tid trodde jag att jag saknade en flagga gRPC. Nu förstår jag att det egentligen är gRPC Windows-flaggan som saknas. Jag hittade ett internt RPC-bibliotek där jag var säker på att det fungerade bra för alla installerade flaggor . Jag la sedan till alla dessa flaggor i gRPC och distribuerade Alvin på Windows, i den korrigerade ping-pong-servern för Windows!
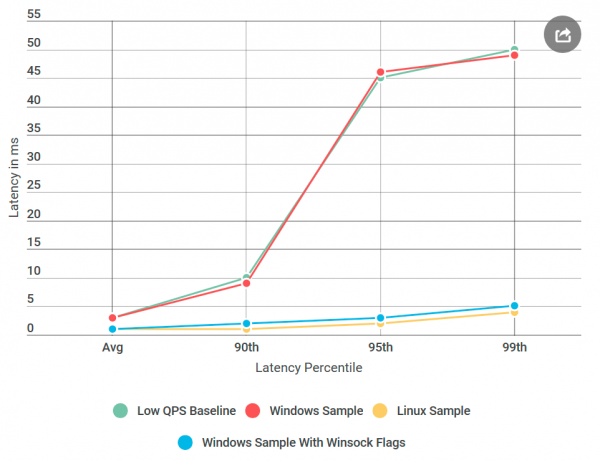
Nästan klart: jag började ta bort de tillagda flaggorna en efter en tills regressionen återkom, så jag kunde exakt identifiera orsaken. Det var den ökända -switchen för Nagle-algoritmen.
försöker minska antalet paket som skickas över nätverket genom att fördröja överföringen av meddelanden tills paketstorleken överskrider ett visst antal byte. Även om det kan vara bra för den genomsnittliga användaren, är det förödande för realtidsservrar eftersom operativsystemet kommer att fördröja vissa meddelanden, vilket orsakar fördröjningar vid låg QPS. På gRPC var denna flagga inställd i Linux-implementeringen för TCP-sockets, men inte för Windows. Jag upptäckte detta .
Slutsats
Den stora fördröjningen vid låg QPS orsakades av optimeringen av operativsystemet. När jag ser tillbaka, upptäckte profileringen ingen fördröjning eftersom den genomfördes i kärläge, inte i Jag vet inte om man kan observera Nagle-algoritmen genom ETW-fångster, men det skulle vara intressant.
När det gäller localhost-experimentet, rörde det troligen inte den faktiska nätverkskoden, och Nagle-algoritmen kördes inte, så fördröjningsproblemen försvann när klienten kontaktade Alvin genom localhost.
Nästa gång du ser en ökning av fördröjningarna vid en minskning av antalet begärningar per sekund, ska Nagle-algoritmen finnas med på din lista över misstänkta!
Källa: habr.com
