

Önskar alla en fin fredag! Det är mindre och mindre tid kvar till lanseringen av kursen , därför delar vi idag med oss av en översättning av ytterligare ett användbart material i ämnet.
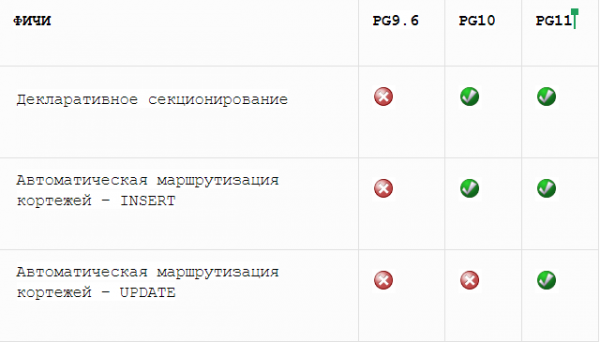
Under utvecklingen gjordes imponerande arbeten för att förbättra sektioneringen av tabeller. Sektionering av tabeller — det här är en funktion som funnits i PostgreSQL under lång tid, men om man ska uttrycka det så, existerade den i princip inte förrän version 10, där den blev en mycket användbar funktion. Tidigare hävdade vi att arv av tabeller är vår implementering av sektionering, och det stämmer. Men den här metoden tvingade er att göra det mesta av arbetet manuellt. Till exempel, om ni ville att tupler skulle sättas in i sektioner under INSERT, behövde ni konfigurera triggers för att göra det för er. Sektionering med hjälp av arv var mycket långsam och svår att utveckla extra funktioner ovanpå.
I PostgreSQL 10 såg vi födelsen av den "deklarativa sektioneringen" — en funktion avsedd att lösa många problem som var olösliga med den gamla metoden med arv. Detta ledde till uppkomsten av ett mycket kraftfullare verktyg som tillåter oss att dela upp data horisontellt!
Jämförelse av funktioner
I PostgreSQL 11 introducerades en imponerande uppsättning nya funktioner som hjälper till att öka prestandan och göra sektionerade tabeller mer transparenta för applikationer.
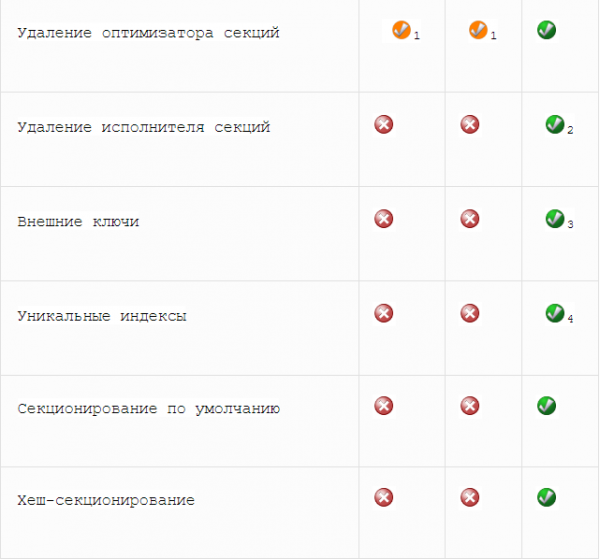
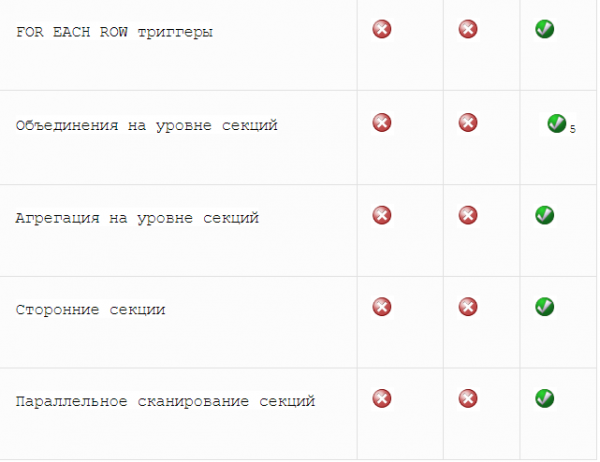
1. Använder begränsande undantag
2. Lägger till endast noder
3. Endast för sektionerad tabell, som hänvisar till en icke-sektionerad
4. Index måste innehålla alla nyckelskolumner i sektionen
5. Begränsningar på sektionen på båda sidor måste överensstämma
Performance
Här har vi också goda nyheter! En ny metod . Denna nya algoritm kan identifiera lämpliga sektioner genom att granska frågans villkor DÄR. Den tidigare algoritmen, å sin sida, kontrollerade varje sektion för att avgöra om den kunde uppfylla villkoret DÄR. Detta ledde till ytterligare ökning av planeringstiden när antalet sektioner växte.
I version 9.6, när sektionering med hjälp av arv användes, genomfördes ruttening av tuples i sektionen vanligtvis genom att skriva en triggerfunktion som innehöll en serie IF-satser för att infoga tuple i rätt sektion. Dessa funktioner kunde vara mycket långsamma vid körning. Med deklarativ sektionering som lades till i version 10, började detta fungera mycket snabbare.
Genom att använda en sektionerad tabell med 100 sektioner kan vi uppskatta prestandan vid inladdning av 10 miljoner rader i tabellen från 1 kolumn BIGINT och 5 kolumner INT.
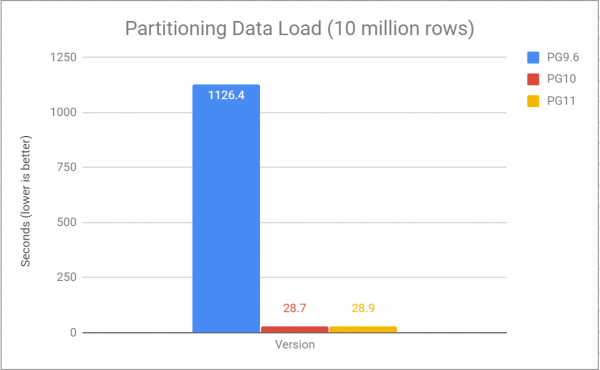
Prestandan för att fråga denna tabell för att hitta en indexerad post och utföra DML för att manipulera en post (använda endast 1 processor):
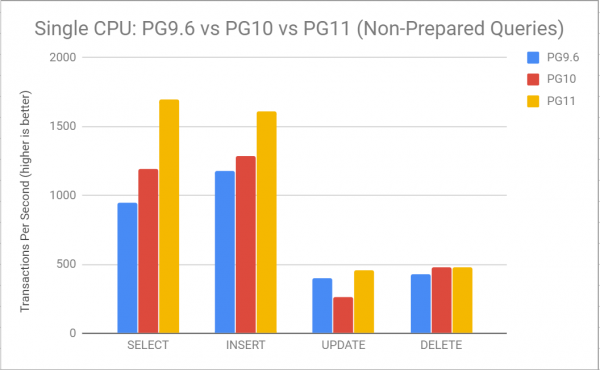
Här ser vi att prestandan för varje operation har ökat avsevärt efter PG 9.6. Förfrågningarna VÄLJ ser mycket bättre ut, särskilt de som kan utesluta flera sektioner under planeringen av förfrågningar. Detta innebär att planläggaren kan hoppa över en stor del av arbetet som den tidigare var tvungen att göra. Till exempel byggs det inte längre vägar för onödiga sektioner.
Slutsats
Sektionering av tabeller börjar bli en mycket kraftfull funktion i PostgreSQL. Det gör det möjligt att snabbt exportera data online och konvertera dem till offline, utan att vänta på att långsamma massoperationer DML ska slutföras.. Detta innebär också att relaterade data kan lagras tillsammans, vilket gör att nödvändiga data kan nås mycket effektivare. Förbättringarna som gjorts i denna version skulle inte ha varit möjliga utan utvecklarna, granskare och bidragsgivare som oförtröttligt arbetade med alla dessa funktioner.
Tack till dem alla! PostgreSQL 11 ser helt fantastiskt ut!
Så här är en kort, men ganska intressant artikel. Dela gärna kommentarer och glöm inte att registrera dig för , där programmet för kursen kommer att redovisas i detalj.
Källa: habr.com
