

När vi pratar om steganografi föreställer sig människor terrorister, pedofiler, spioner, ja, i bästa fall kryptoanarkister och andra forskare. Och verkligen, vem annars kan behöva det? dölja något från yttre ögon? Vilken nytta kan detta egentligen vara för den vanliga personen?
Det visar sig att det finns viss nytta. Därför kommer vi idag att komprimera data med hjälp av steganografimetoder. I slutet kan läsaren till och med använda sina ovärderliga JPEG-arkiv för att öka mängden ledigt utrymme på filsystemet.
Vad?
Om läsaren kommer ihåg, så är steganografi sådana konstiga algoritmer som gör det möjligt att dölja närvaron av en information inuti en annan. Med enklare ord: bild + fil == ungefär samma bild, men inte helt (istället för bilder kan det vara vad som helst, men det är oftast tydligare på dem). Samtidigt ska det inte finnas något enkelt sätt att avgöra om det finns något inuti eller inte.
Men om man inte kan skilja det ena från det andra, finns det då någon skillnad överhuvudtaget? Ur en konsuments eller användares perspektiv spelar den matematiska noggrannheten (representerad av en specifik mängd bitar) ingen roll, bara det som uppfattas av dem.
Till exempel, låt oss titta på tre bilder av en söt hund:
Akta dig, JPEG!
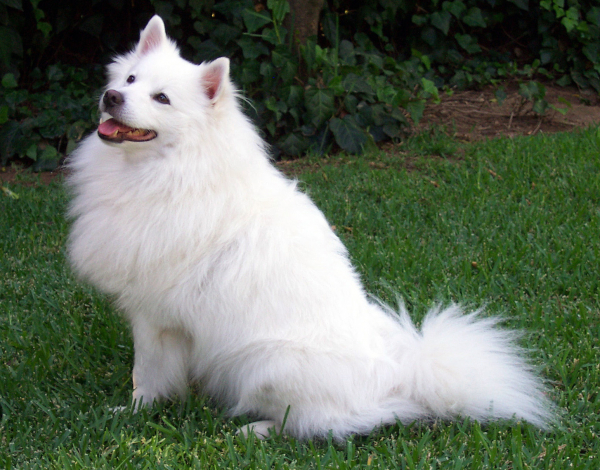
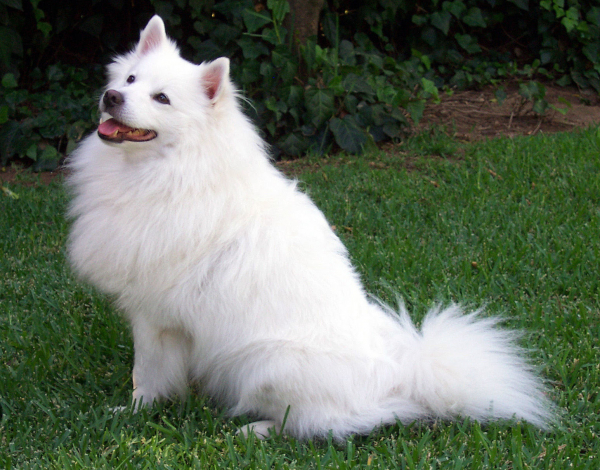
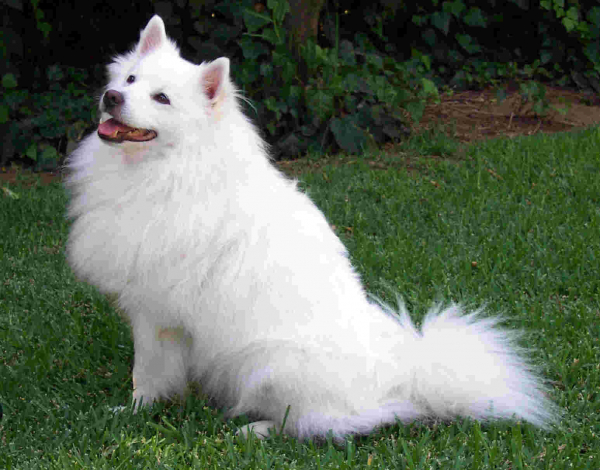
Trots den enorma storleksskillnaden är det få som skulle välja den tredje versionen. Å andra sidan är skillnaden mellan de första två bilderna inte så märkbar, och mängden information i dem (enligt min åsikt) kan likställas.
Själva den här principen är redan gammal och har länge utnyttjats av metoder för informationskomprimering med förlust. Men att bryta ner är inte att bygga, vi är intresserade av den mer avancerade sidan av frågan. Kan man integrera ytterligare information av storleken N i en fil så att dess storlek ökar med M < N, och ändringarna inte är märkbara för användaren?
Självklart går det. Men det är värt att göra ett par förtydliganden direkt:
- För det första måste metoden vara universell och ge positiva resultat med de flesta indata. Det vill säga, i genomsnitt, för godtyckliga ingångar, ska den faktiska mängden lagrad information minska. "I genomsnitt" innebär att motsatta fall kan förekomma, men de bör inte dominera.
- För det andra bör den komprimerade behållarens storlek innan införandet av information vara större än den komprimerade motsvarigheten. Att bara införa en mängd bitar i BMP-bilder med LSB-metoden är inte steganografisk kompression; eftersom den originala bilden, när den har körts genom någon DEFLATE, troligtvis blir märkbart mindre.
- För det tredje bör resultaten jämföras med redan komprimerade data som använder klassiska metoder. Detta gör att man kan ta bort den potentiella effekten av deras redundans och genomföra en mer effektiv kompression i allmänhet.
Var?
Användning av steganografi innebär att vi förutom den information som ska komprimeras också behöver behållare där den ska integreras. Den maximala mängden inbäddad information beror till stor del på specifika egenskaper, men ökar betydligt med antalet. Därför bör formatet för behållarna vara vanligt förekommande för att användaren ska ha ett tillräckligt antal för att få någon nytta av "komprimerings"-processen.
I det här sammanhanget blir grafiska, ljud- och video-filer bra kandidater. Men på grund av mångfalden av olika format, codecs och så vidare, finns det i praktiken inte så många alternativ att välja mellan.
Med allt detta i åtanke har jag valt JPEG. Det finns praktiskt taget överallt och används brett både för personligt bruk och affärsmål, och är nästan de facto-formatet för de flesta bilder.
N̶ä̶r̶ ̶?̶ Hur?
Nästa följer omkring- och tekniska scheman och beskrivningar utan större förklaringar, så de som är intresserade kan hoppa över dem och gå vidare till avsnittet "Högteknologi".
Gemensamma drag
För att kunna integrera data någonstans måste man först bestämma var. Det kan finnas hur många olika bilder som helst i filsystemet, där användaren kan vilja använda endast vissa. Den mängd önskade behållare kallar vi ett bibliotek.
Den bildas i två fall: före komprimering och före uppackning. I det första fallet kan man enkelt använda en uppsättning namn (eller bättre, ett reguljärt uttryck för dem) för filer, men i det andra krävs något mer tillförlitligt: användaren kan kopiera och flytta dem inom filsystemet, vilket hindrar korrekt identifiering. Därför behövs det att lagra deras hash-värden (md5 räcker) efter att alla modifieringar har gjorts.
Inledande sökningen med reguljära uttryck är meningslös att göra över hela filsystemet, det räcker att ange en viss rotkatalog. Dit kommer en speciell arkivfil att sparas, där dessa hash-värden finns tillsammans med annan meta-information, som behövs för den efterföljande återställningen av den komprimerade informationen.
Allt detta gäller lika mycket för vilken implementering av vilken algoritm för steganografisk datakomprimering som helst. Själva processerna för komprimering och återställning av data kan kallas paketering och uppackning.
F5
Nu när det är klart vad vi gör och varför, återstår det att beskriva själva algoritmen för att nå målet. Låt oss minnas processen för att koda en JPEG-fil (tack till Nationalbibliotekets Wiki):
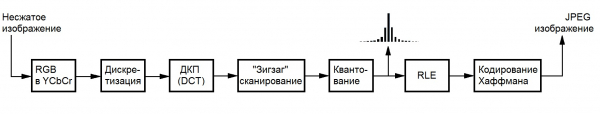
Medan vi tittar på den, är det bättre att omedelbart göra några observationer:
- Storleken på en JPEG-fil kan anses vara optimal, utan att ens försöka komprimera den med något program som WinRAR;
- Det är endast den lagrade informationen (den som är resultatet av diskret kosinustransformering, DCT) som kan modifieras för att säkerställa någon rimlig prestanda.
- För att inte förlora data i märkbara industriella skala, krävs det att göra minimala modifieringar i varje enskild bild;
För sådana villkor passar en hel familj av algoritmer, som kan ses . Den mest avancerade av dem är algoritmen av Andreas Westfeld, som arbetar med DCT-koefficienter för ljuskomponenten (människans öga är minst känsligt för just dessa förändringar). Dess allmänna schema när den arbetar med en befintlig JPEG-fil visas enligt följande schema:
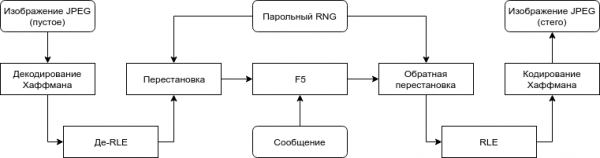
Block F5 använder en avancerad inbäddningsmetodik baserad på matris kodning. Mer om det och själva algoritmen kan läsaren bekanta sig med via länken ovan, men vi är först och främst intresserade av det faktum att man kan göra färre förändringar vid inbäddning av samma mängd information ju större storleken på den använda containern är, och för att genomföra själva algoritmen krävs endast enkla operationer av (de)kodning av Huffman och RLE.
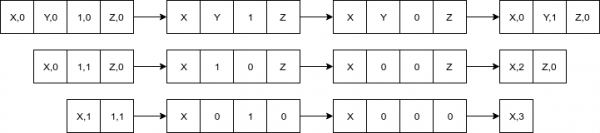
Själva ändringarna görs på heltalskoefficienterna och handlar om att minska deras absoluta värden med en enhet, vilket gör att F5 kan användas för datakomprimering. Det beror på att en koefficient med minskat absolutvärde troligen kommer att ta färre bitar efter att ha genomfört Huffman-kodning på grund av den statistiska fördelningen av värden i JPEG.
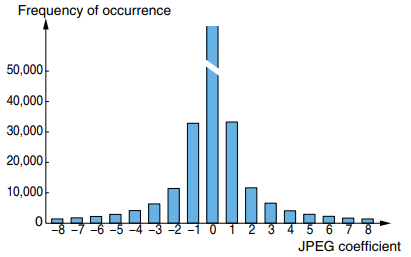
I händelse av att en nolla bildas (s.k. förkortning), kommer mängden lagrad information att minska med dess storlek, eftersom den tidigare självständiga koefficienten blir en del av den kodade RLE-sekvensen av nollor:
Modifieringar
Dataskydd och komprimering är ortogonala uppgifter, därför kan man bortse från den hemliga lösenordspermutationerna från den ursprungliga algoritmen. Dessutom behöver vi veta exakt hur man extraherar data, så all nödvändig information för detta (vilka containrar som använts, i vilken ordning, osv.) måste registreras i en separat fil och vara öppen för fri läsning av komprimeraren.
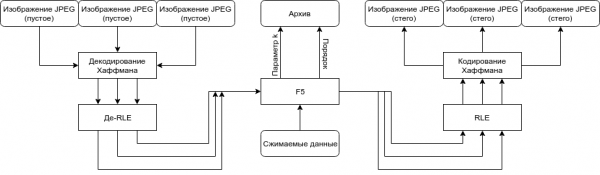
Den ursprungliga algoritmen är avsedd för överföring av hemliga meddelanden, så den arbetar åt gången endast med en container, och förutsätter att användaren själv kommer att dela upp den i delar vid behov, om det överhuvudtaget skulle uppstå. Dessutom, vid oberoende inbäddning i varje container, kommer man på förhand att behöva veta hur många bitar data som ska placeras i varje. Därför bör koefficienterna för varje element i biblioteket sammanfogas till en abstrakt stor och arbetas med enligt den ursprungliga algoritmen.
Eftersom den ursprungliga F5 tillåter användning av upp till 12% av behållarens storlek, kommer en sådan modifiering också att öka den maximala kapaciteten: "upp till 12%" av storleken på hela biblioteket är större än eller lika med summan av "upp till 12%" av varje av dess element.
Den kodifierade allmänna schemat ser ut som följer:
Själva algoritmen
Nu är det dags att beskriva själva algoritmen från början till slut, så att läsaren inte hålls i mörkret:
- Användaren definierar de binärt komprimerade data M och biblioteket L med hjälp av ett reguljärt uttryck och roten av sökvägen;
- I den ordning som elementen i biblioteket förekommer på filsystemet bildar de MC:
- Från filens data avkodas en serie koefficienter C;
- MC <- MC | C;
- Parametern k bestäms utifrån det skrämmande olikheten:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Nästa tas
n = (1 << k) - 1de lägsta bitarna av de icke-noll elementen från MC och skrivs in ia:- Den magiska hash-funktionen
f, som avbildar ett n-bitsordatill ett k-bitsords; - Om
s == 0, så ändra ingenting och algoritmen går vidare till nästa koefficienter; - Minska det absoluta värdet av koefficienten som ansvarar för
s-e bit i ordeta; - Om minskningen resulterade i att koefficienten blev 0, upprepa steget från början;
- Den magiska hash-funktionen
- Alla koefficienter kodas med RLE och Huffman, skrivs in i de ursprungliga filerna;
- I arkivfilen skrivs parametern k;
- Från varje fil L, i den ordning de förekommer från början, beräknas MD5-hash och skrivs in i arkivfilen.
Högteknologi
Den naiva formen av algoritmen och implementeringen på andra hög-nivå (särskilt, med skräpsamling) språk skulle ge förfärlig prestanda, så alla dessa svårigheter genomförde jag i rent C och genomförde en rad optimeringar både för körningshastighet och för minne (du kan inte föreställa dig hur mycket dessa bilder väger utan komprimering även till DCT). Men så, initialt lämnade körningshastigheten mycket att önska, så jag kommer inte att beskriva hela processen och de använda metoderna.
Plattformsoberoende har uppnåtts genom att använda en kombination av biblioteken libjpeg, pcre och tinydir, vilket jag tackar dem för. Som standard kompileras allt med en vanlig make, så Windows-användare måste installera något Cygwin, eller ordna med Visual Studio och biblioteken själva.
Implementeringen är tillgänglig som ett kommandoradsverktyg och ett bibliotek. De som vill veta mer om användningen av det senare kan läsa i readme-filen i repot på GitHub, vars länk jag kommer att bifoga i slutet av inlägget. Låt oss nu gå vidare till beskrivningen och demonstration av arbetet.
Hur man använder?
Med försiktighet. Använda bilder kan flyttas, döpas om och kopieras som man önskar. Men man ska vara mycket försiktig och inte ändra deras innehåll. Att ändra en enda bit kommer att leda till att hash-värdet bryts och informationen blir omöjlig att återställa.
Låt oss säga att vi efter kompileringen fått den körbara filen f5ar. Vi kan analysera storleken på biblioteket för att beräkna möjligheterna till dess användning med hjälp av flaggan -a: ./f5ar -a [sökmappe] [Perl-kompatibel reguljär uttryck]. Packning görs med kommandot ./f5ar -p [sökmappe] [Perl-kompatibel reguljär uttryck] [packad fil] [arkivnamn], och uppackning med hjälp av ./f5ar -u [arkivfil] [namn på återställd fil].
Demonstration av arbetet
För att visa metodens effektivitet har jag laddat upp en samling av 225 helt gratis hundbilder från tjänsten . Varje bild har en något högre kvalitet än vanliga användarbilder, men ändå. Varje bild har transkoderats med hjälp av libjpeg för att eliminera påverkan av bibliotekets kodningsspecifika attribut på den totala storleken. För att illustrera det sämsta exemplet på komprimerbara data har en slumpmässig 36-megabytes (lite mer än 5% av den totala storleken) jämnt fördelad fil genererats med dd.
Testprocessen är ganska enkel:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ ./f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Läser komprimerad fil... ok
Initierar arkivet... ok
Analyserar bibliotekskapacitet... klart på 16.8s
Upptäckte något garanterad kapacitet på 48439359 byte
Upptäckte möjlig kapacitet på upp till 102618787 byte
Komprimerar... klart på 32.6s
Sparar arkivet... ok

$ ./f5ar -u dogs/dogs.f5ar unpacked
Initierar arkivet... ok
Läser arkivfilen... ok
Fyller arkivet med filer... klart på 1.2s
Dekomprimerar... klart på 17.5s
Skriver utvunna data... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Eller en skärmdump för entusiaster
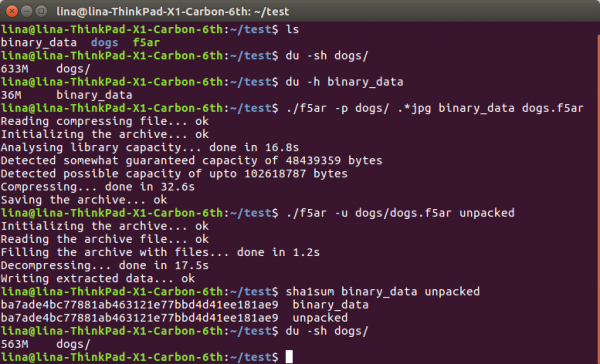
Som det framgår har vi utgått från ursprungliga 633 + 36 == 669 megabyte data på hårddisken och kommit fram till en mer tilltalande storlek av 563, vilket ger oss en kompressionsfaktor på ~1,188. Denna radikala skillnad förklaras av de extremt små förluster som liknar dem som uppnås vid JPEG-filer optimering med klassiska metoder (som tinyjpg). Naturligtvis, när steganografisk komprimering används, "förloras" inte informationen bara, utan används för att koda andra data. Dessutom är antalet "optimerade" koefficienter genom att använda F5 mycket mindre än vid traditionell optimering.
Oavsett vilka modifieringar som görs, är de helt osynliga för ögat. Under spoilern nedan kan läsaren bedöma skillnaden både visuellt och genom att subtrahera värdena för den modifierade komponenten från originalet (ju mer dämpad färgen är, desto mindre är skillnaden):
Länkar till bilder som inte fick plats på habrastorage
Original —
Modifierad —
Skillnad —
Avslutande
Jag hoppas att jag har lyckats övertyga läsaren om att sådana metoder är möjliga och värda att utforska. Det kan dock verka mycket enklare att köpa en hårddisk eller en extra kanal (för nätöverföring) än att försöka spara på detta sätt. Å ena sidan är det faktiskt så, extensiv utveckling är ofta enklare och mer pålitlig. Men å andra sidan bör vi inte glömma den intensiva utvecklingen. Det finns trots allt inga garantier för att man nästa dag kan gå till affären och köpa en ny hårddisk på tusen terabyte, men att använda de som redan finns hemma kan man alltid göra.
->
Källa: habr.com
