

Glad it's Friday! Friends, today we continue the series of publications dedicated to the course , as classes in the new group for the course will begin at the end of next week. So, let's get started!
Monitoring is enkel. This is a well-known fact. Start Nagios, run NRPE on the remote system, configure Nagios on TCP port 5666 for NRPE and you have monitoring.
It's so easy that it's uninteresting. Now you have basic metrics for CPU time, disk subsystems, and RAM, which come configured by default in Nagios and NRPE. But this isn't really 'monitoring' as such. It's just the beginning.
(Typically, you install PNP4Nagios, RRDtool, and Thruk, set notifications in Slack, and head straight to nagiosexchange, but let's skip that for now).
Good monitoring is actually quite complex; you really need to know the ins and outs of the application you are monitoring.
Is monitoring complicated?
Any server, whether Linux or Windows, will, by definition, serve some purpose. Apache, Samba, Tomcat, file storage, LDAP—all these services are more or less unique in one or more ways. Each has its own function, its own features. There are different ways to obtain metrics, KPIs (key performance indicators), that interest you when the server is under load.
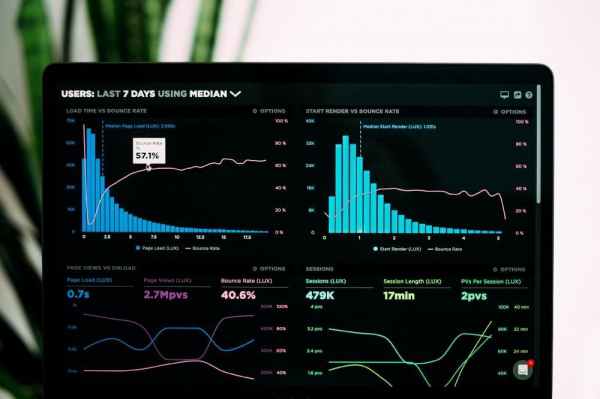
Photo by till
(I wish my dashboards were painted in neon blue colors—dreamily sighing—... hmm...)
Any software that provides services must have a mechanism for collecting metrics. Apache has the module mod-status, which displays the server status page. Nginx has stub_status. Tomcat has JMX or specialized web applications that show key metrics. MySQL has the command 'show global status' etc.
So why don’t developers embed such mechanisms into the applications they create?
Is it only developers who do this?
A certain level of indifference to embedding metrics is not limited to developers. I've worked in companies where applications were developed using Tomcat without providing any of their metrics, no service activity logs except for the general Tomcat error logs. Some developers generate an abundance of logs that are meaningless to the system administrator unlucky enough to read them at 3:15 AM.
Photo by till
Systemingenjörer som möjliggör för dessa produkter att släppas måste också bära ett visst ansvar för situationen. Få systemingenjörer har tid eller intresse att försöka få meningsfulla mått från loggar, utan kontexten av dessa mått och möjligheten att tolka dem i ljuset av applikationens aktivitet. Vissa förstår inte vilken nytta de kan få av detta, utöver indikatorer som "något för närvarande (eller snart) är fel".
Det finns ett behov av att förändra tänkesättet kring vikten av mått, vilket måste ske inte bara bland utvecklare utan också bland systemingenjörer.
För varje systemingenjör som behöver både reagera på kritiska händelser och säkerställa att de inte inträffar, är bristen på mått vanligtvis ett hinder för detta.
Men systemingenjörer grubblar oftast inte över koden, utan tjänar pengar för sitt företag. De behöver ledande utvecklare som förstår vikten av systemingenjörens ansvar i att upptäcka problem, öka medvetenheten om prestandaproblem och liknande.
Den här devops-grejen
Devops-mentaliteten beskriver synergin mellan utvecklare (dev) och drift (ops). Vilket företag som helst som hävdar att de "gör devops" måste:
- säga något som de förmodligen inte gör (en anspelning på ett meme från filmen "Prinsessan bruden" — "Jag tror inte att det betyder det du tror att det betyder!")
- uppmuntra en ställning för ständig produktförbättring.
Du kan inte förbättra en produkt och veta att den har förbättrats om du inte vet hur den fungerar just nu. Du kommer inte att kunna förstå hur produkten fungerar om du inte förstår hur dess komponenter, de tjänster den är beroende av, dess centrala smärtpunkter och flaskhalsar fungerar.
Om du inte övervakar potentiella flaskhalsar, kommer du inte att kunna följa tekniken "Fem varför" när du skriver Postmortem. Du kommer inte att kunna samla allt på en skärm för att se hur produkten fungerar eller ta reda på hur den ser ut "normal och glad".
Vridning till vänster, TILL VÄNSTER, JAG SADE, VÄÄÄÄÄÄNTE—
För mig är en av de centrala principerna inom Devops "Vridning till vänster" (shift left). Vridning till vänster i detta sammanhang betyder att flytta möjligheten (inte ansvaret, och bara möjligheterna) att göra det som systemingenjörer vanligtvis bryr sig om, till exempel att skapa prestandametrik, använda loggar mer effektivt osv., i början av programvaruleveransens livscykel (Software Delivery Life Cycle).
Photo by till
Programvaruutvecklare bör ha möjlighet att använda och förstå de övervakningsverktyg som företaget använder för att övervaka i alla dess former, metriker, loggning, övervakningsgränssnitt och, viktigast av allt, övervaka hur deras produkt fungerar i produktion. Du kan inte tvinga utvecklare att investera tid och kraft i övervakning förrän de kan se metrikerna och påverka hur de ser ut, hur produktägaren presenterar dem för deras CTO vid nästa briefing, osv.
Kort sagt
- Led hästen till vattnet. Visa utvecklarna hur många problem de kan undvika för sig själva, hjälp dem att identifiera rätt KPI:er och metriker för sina applikationer, så att det blir mindre skrik från produktägaren som får skäll av teknikchefen (CTO). Dra dem fram i ljuset, mjukt och lugnt. Om det inte fungerar, köp, hota och övertala antingen dem eller produktägaren att snabbt genomföra insamlingen av dessa metriker från applikationerna, och sedan rita diagram. Detta kommer att vara svårt, eftersom det inte kommer att betraktas som en prioritet, och produktens färdplan kommer att ha många väntande projekt för genomförande som genererar intäkter. Så du kommer att behöva en ekonomisk motivering för att rättfärdiga tid och resurser som investeras i att införa övervakning i produkten.
- Hjälp systemingenjörerna att få sin sömn. Visa dem att det är bra att använda checklistan "släpp en release" för alla produkter som släpps. Att säkerställa att alla applikationer i produktion är täckta med metrik kommer att bidra till en god natts sömn, vilket gör att utvecklarna kan se vad och var något fungerar dåligt. Ändå är det det rätta sättet att irritera och frustrera varje utvecklare, produktägare och teknisk chef att ihärdigt sätta käppar i hjulen och motstå. Ett sådant beteende kommer att påverka releasedatumet för varje produkt, om man väntar till sista minuten igen, så gör om justeringen åt vänster och integrera dessa frågor i projektplanen så snart som möjligt. Om det är nödvändigt, smyga dig in på produktmöten. Bär fejkade mustascher och hatt eller något liknande, det misslyckas aldrig. Rapportera dina problem, visa tydliga fördelar och sprid budskapet.
- Se till att både utvecklarna (dev) och driften (ops) förstår betydelsen och konsekvenserna av att produktmetrik går in i "den röda zonen". Låt inte driften vara den enda vakten som ser till att produkten fungerar, se till att utvecklarna också är delaktiga i detta (#productsquads).
- Loggar är fantastiska, men metrik är det också. Sammanfoga dem och låt inte dina loggar bli skräp i en enorm, brinnande boll av meningslöshet. Förklara och visa utvecklarna varför ingen annan än dem kommer att kunna förstå deras loggar, visa dem hur det är att titta på meningslösa loggar klockan 3:15 på morgonen.
Photo by till
Det var allt för nu. Nytt material lanseras nästa vecka. Om du vill veta mer om kursen, hälsar vi dig välkommen till , som äger rum redan på måndag. Och just nu ser vi traditionsenligt fram emot dina kommentarer.
Källa: habr.com
