

Hej alla. Jag arbetar som ledande systemadministratör på OK och ansvarar för portalen. Jag vill berätta om hur vi har byggt upp processen för automatisk byte av diskar, och hur vi sedan uteslöt administratören från denna process och ersatte honom med en bot.
Den här artikeln är en slags translitterering till HighLoad+ 2018
Byggande av processen för byte av diskar
Först lite siffror
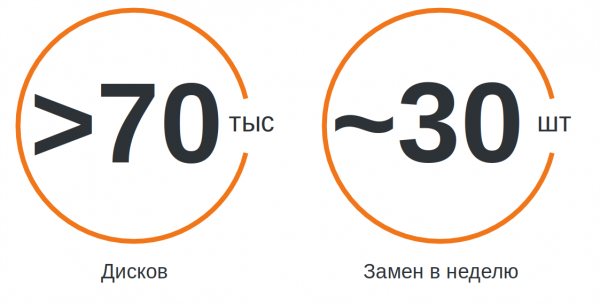
OK är en gigantisk tjänst som används av miljontals människor. Den stöds av cirka 7000 servrar som är belägna i 4 olika datacenter. I servrarna finns över 70 000 diskar. Om man staplar dem ovanpå varandra får man ett torn som är mer än 1 km högt.
Hårddiskar är den komponent i servern som oftast går sönder. Med sådan volym måste vi byta ut cirka 30 diskar varje vecka, och denna procedur har blivit en obehaglig rutin.
Incidenter
Vi har i vårt företag infört en heltäckande incidenthantering. Varje incident registrerar vi i Jira och löser och analyserar sedan. Om incidenten har påverkat användarna samlas vi för att fundera på hur vi snabbare kan reagera i sådana situationer, hur vi kan minska effekten, och självklart hur vi kan förhindra upprepning.
Lagringsenheter är inget undantag. Deras tillstånd övervakas av Zabbix. Vi bevakar meddelanden i Syslog för att upptäcka skriv-/läserfel, analyserar tillståndet hos HW/SW-RAID, och övervakar SMART, samt beräknar slitaget för SSD.
Hur diskar byttes tidigare
När en trigger tänds i Zabbix skapas en incident i Jira och tilldelas automatiskt till de aktuella ingenjörerna i datacentren. Detta gör vi för alla HW-incidenter, det vill säga sådana som kräver någon form av fysiskt arbete med utrustningen i datacentret.
Ingenjören i datacentret är en person som hanterar frågor relaterade till hårdvaran, ansvarar för installation, underhåll och demontering av servrar. När han får en biljett sätter han igång med arbetet. I diskhyllorna byter han ut diskarna själv. Men om han inte har tillgång till rätt enhet ber ingenjören jouransvariga systemadministratörer om hjälp. Först måste disken tas ur rotation. För detta behöver man göra nödvändiga ändringar på servern, stoppa applikationerna och avmontera disken.
Under den arbetsdagar är den jourhavande systemadministratören ansvarig för hela portalens funktion. Han utreder incidenter, utför reparationer och hjälper utvecklarna med mindre uppgifter. Han arbetar inte med hårddiskarna.
Tidigare kommunicerade datacentertekniker med systemadministratören via chatt. Teknikerna skickade länkar till Jira-biljetter, och administratören gick igenom dem och förde en logg över arbetet i någon anteckningsbok. Men för sådana uppgifter är chattar besvärliga: informationen är ostrukturerad och går fort förlorad. Dessutom kunde administratören enkelt gå ifrån datorn och vara otillgänglig under en tid, medan teknikern stod vid servern med en hög av diskar och väntade.
Men det värsta var att administratörerna inte såg hela bilden: vilka diskincidenter som fanns och var potentiella problem kunde uppstå. Detta beror på att vi lämnar alla hårdvaruincidenter till ingenjörerna. Ja, man kunde visa alla incidenter på administratörens instrumentpanel, men de är väldigt många, och administratören involverades endast i vissa av dem.
Dessutom kunde ingenjören inte korrekt prioritera, eftersom han inte visste något om syftet med de specifika servrarna eller om fördelningen av data över lagringsenheterna.
Ny procedur för byten
Det första vi gjorde var att separera alla diskincidenter till en egen typ "HW-disk" och lägga till fälten "namn på blockenhet", "storlek" och "disktyp" så att denna information sparades i biljetten och man inte behövde ständigt utbyta den i chatt.
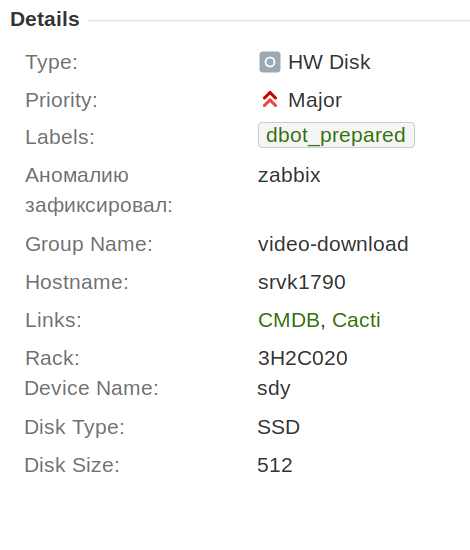
Vi kom också överens om att vi inom ett och samma incident skulle byta endast en disk. Detta förenklade avsevärt processen för automatisering, insamling av statistik och arbete i framtiden.
Dessutom lade vi till fältet "ansvarig administratör". Dit sätts den jourhavande systemadministratören automatiskt. Det är mycket praktiskt, eftersom ingenjören nu alltid ser vem som är ansvarig. Det behövs inte gå till kalendern och leta. Just detta fält har gjort det möjligt att visa biljetter på administratörens instrumentpanel där hans hjälp kan behövas.
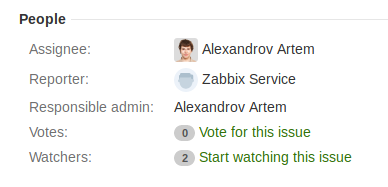
För att alla deltagare ska dra maximal nytta av nyheterna har vi skapat filter och instrumentpaneler och berättat om dem för teamet. När folk förstår förändringarna distanserar de sig inte från dem som något onödigt. Ingenjören behöver veta racknumret där servern är placerad, storlek och typ på disken. För administratören är det viktigt att först och främst förstå vilken grupp servrar det handlar om och vilken effekt som kan uppnås vid diskbyte.
Att ha fält och deras visning är praktiskt, men det löste inte behovet av att använda chattar. För detta var vi tvungna att förändra arbetsprocessen.
Tidigare var det så här:
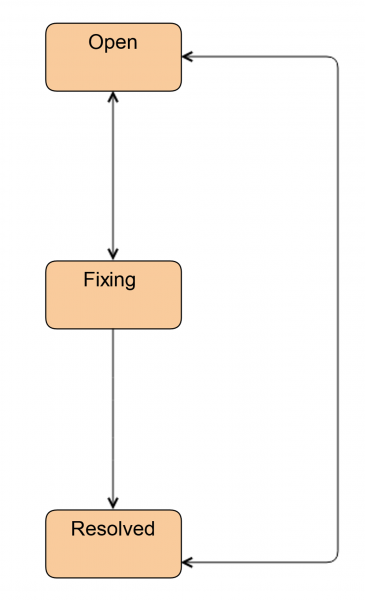
I dag fortsätter ingenjörerna att arbeta så här när de inte behöver hjälp av administratören.
Det första vi gjorde var att införa en ny status Investigate. I den här statusen befinner sig ärendet när ingenjören ännu inte har bestämt sig för om han behöver hjälp från administratören eller inte. Genom denna status kan ingenjören överföra ärendet till administratören. Dessutom markerar vi ärenden med denna status när vi behöver byta disk, men själva disken inte finns på plats. Sådant sker vid CDN och avlägsna platser.
Vi har också lagt till statusen Redo. Ärendet övergår till denna status efter diskbytet. Det vill säga, allt är redan gjort, men HW/SW RAID synkroniseras på servern. Detta kan ta ganska lång tid.
Om en administratör involveras i arbetet blir schemat lite mer komplicerat.
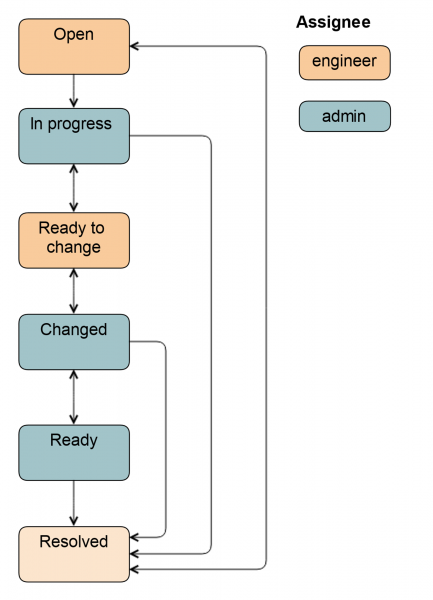
Från statusen Öppen kan ärendet överföras både av systemadministratören och ingenjören. I statusen In progress tar administratören ur disken från rotation så att ingenjören enkelt kan ta ut den: han aktiverar belysningen, avmonterar disken, stoppar applikationer beroende på den specifika servergruppen.
Sedan övergår ärendet till Ready to change: detta är en signal till ingenjören att disken kan tas bort. Alla fält i Jira är redan ifyllda, ingenjören vet vilken typ och storlek på disken. Dessa uppgifter fylls antingen i automatiskt i den föregående statusen eller av administratören.
Efter diskbytet övergår ärendet till statusen Changed. Det kontrolleras att rätt disk sattes in, partitioneringen görs, applikationen startas och vissa uppgifter för datag återställning utförs. Ärendet kan också övergå till statusen Redo, i detta fall förblir administratören ansvarig, eftersom han införde disken i rotation. Det fullständiga schemat ser ut så här.
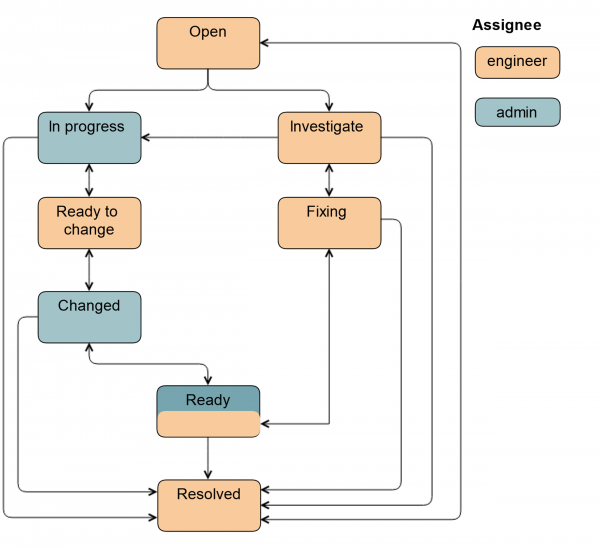
Tillkomsten av nya fält har avsevärt underlättat vårt arbete. Teamet har börjat arbeta med strukturerad information, vilket har gjort det tydligt vad som behöver göras och i vilket steg. Prioriteringarna har blivit mycket mer relevanta, eftersom de nu ställs in av administratören.
Behovet av chattar har försvunnit. Självklart kan administratören skriva till ingenjören "det här måste bytas snabbare", eller "det är redan kväll, hinner du byta?". Men vi kommunicerar inte längre dagligen i chattarna om dessa frågor.
Diskarna byts nu i grupper. Om administratören kommer till arbetet lite tidigare och har lite ledig tid, samt inget har fungerat fel, kan han förbereda flera servrar för byte: sätta in fält, ta bort diskar från rotation och överlämna uppgiften till ingenjören. Ingenjören kommer lite senare till datacentret, ser uppgiften, tar de nödvändiga lagringsenheterna från lagret och byter dem omedelbart. Som ett resultat har hastigheten på bytena ökat.
Erfarenheterna från att bygga arbetsflödet
- Vid utformningen av proceduren är det nödvändigt att samla information från olika källor.
Vissa av våra administratörer visste inte att ingenjören bytte diskar självständigt. Några trodde att ingenjörerna övervakade synkroniseringen av MD RAID, även om vissa av dem inte ens hade tillgång till det. Några av de ledande ingenjörerna gjorde det, men inte alltid, eftersom processen inte var dokumenterad någonstans. - Proceduren måste vara enkel och tydlig.
Det är svårt för en person att hålla många steg i huvudet. De viktigaste angränsande statusarna i Jira måste lyftas upp på huvudskärmen. Vi kan till exempel kalla "I progress" för "Redo att byta". Andra statusar kan döljas i en rullgardinsmeny så att de inte stör. Men det är bättre att inte begränsa människor, ge dem möjlighet till övergång.
Förklara värdet av nyheterna. När människor förstår dem, accepterar de den nya proceduren bättre. Det var mycket viktigt för oss att folk inte bara klickade sig igenom hela processen, utan gick igenom den. Sedan byggde vi automatisering på detta. - Vänta, analysera, förstå.
Vi spenderade cirka en månad på att bygga processen, teknisk implementation, möten och diskussioner. Implementeringen tog mer än tre månader. Jag har sett hur folk sakta börjar använda den nya funktionen. I de första skedena var det mycket negativitet. Men det hade inget att göra med själva processen eller dess tekniska implementation. Till exempel använde en administratör inte Jira, utan ett Jira-plugin i Confluence, och vissa saker var honom otillgängliga. När vi visade honom Jira, ökade hans produktivitet både när det gällde gemensamma uppgifter och diskbyten.
Automatisering av diskbyten
Vi har försökt att automatisera diskbyten flera gånger. Vi hade redan arbetat fram skript, men de gick antingen i interaktivt eller manuellt läge och krävde att de startades. Endast efter implementeringen av den nya processen förstod vi att det var just det vi saknade.
Eftersom processen för byte nu är uppdelad i steg, där varje steg har en specifik utförare och en lista med åtgärder, kan vi införa automatisering stegvis, istället för att göra det helt på en gång. Till exempel kan det enklaste steget - Ready (kontroll av RAID/data-synkronisering) enkelt delegeras till en bot. När boten lärt sig lite kan den få en mer ansvarsfull uppgift - att föra in disken i rotation, etc.
Zoologisk trädgård av installationer
Innan vi pratar om boten, låt oss göra en liten översikt över vår zoologiska trädgård av installationer. Först och främst beror det på den enorma storleken av vår infrastruktur. För det andra försöker vi anpassa den mest optimala hårdvarukonfigurationen för varje tjänst. Vi har cirka 20 olika modeller av hårdvaru-RAID, främst LSI och Adaptec, men vi har även HP och DELL i olika versioner. Varje RAID-controller har sin egen hanteringsverktyg. Kommandosatser och deras utdata kan variera från version till version för varje RAID-controller. Där HW-RAID inte används kan det finnas mdraid.
Nästan alla våra nya installationer gör vi utan diskreservning. Vi försöker att inte längre använda hårdvara och mjukvara RAID, eftersom vi säkerhetskopierar våra system på datacenter-nivå, och inte servernivå. Men det finns självklart många legacy-servrar som måste stödjas.
Någonstans dirigeras diskar i RAID-kontroller raw-enheter, någonstans används JBOD. Det finns konfigurationer med en systemdisk i servern, och om den behöver bytas ut måste servern rullas om med installation av operativsystem och applikationer, dessutom med samma versioner, för att sedan lägga till konfigurationsfiler och starta applikationerna. Det finns också många grupper av servrar där redundans sker inte på nivån av lagringssystemet, utan direkt i applikationerna själva.
Totalt har vi mer än 400 unika grupper av servrar som kör omkring 100 olika applikationer. För att täcka ett så enormt antal alternativ behövde vi ett multifunktionellt automatiseringsverktyg. Helst med ett enkelt DSL, så att vem som helst, inte bara den som skrev det, kan underhålla det.
Vi valde Ansible eftersom det är agentfritt: ingen förberedelse av infrastruktur behövdes, och det var enkelt att komma igång. Dessutom är det skrivet i Python, som är standard i teamet.
Översiktsdiagram
Låt oss titta på översiktsdiagrammet för automatisering med hjälp av ett exempel på en incident. Zabbix detekterar att disken sdb har kraschat, en trigger tänds, och en ticket skapas i Jira. Administratören tittar på den, inser att det inte är en duplikat och inte en falsk positiv, vilket innebär att disken måste bytas ut, och han överför ticketen till In progress.
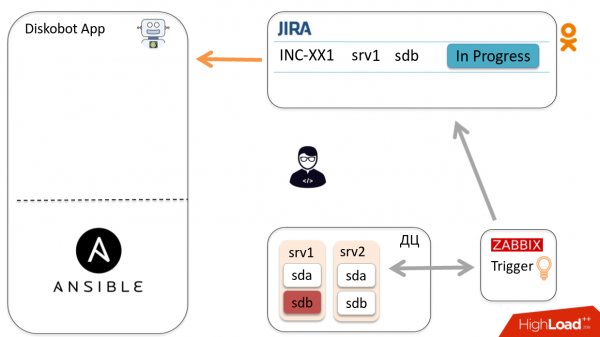
Applikationen DiskoBot, skriven i Python, kontrollerar regelbundet Jira efter nya tickets. Den märker att det har dykt upp en ny ticket i In progress, vilket aktiverar den motsvarande tråden som startar playbook i Ansible (detta görs för varje status i Jira). I det här fallet startas Prepare2change.
Ansible skickas till värden, plockar bort disken från rotation och rapporterar statusen till applikationen via Callbacks.
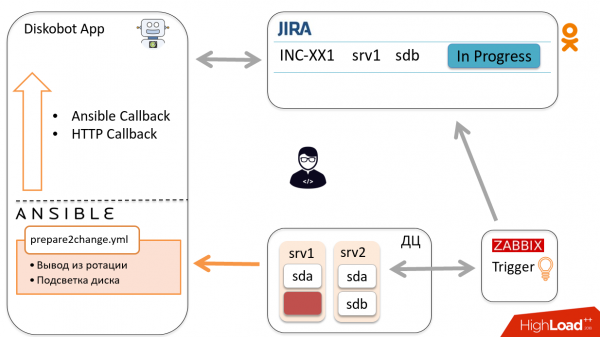
Baserat på resultatet överför boten automatiskt ticketen till Ready to change. Ingenjören får en avisering och går för att byta disken, varefter han för över ticketen till Changed.
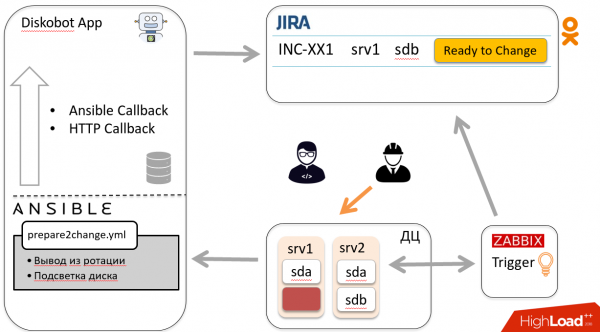
Enligt den ovanbeskrivna schemat återgår ticketen till boten, som startar en annan playbook, går till värden och sätter in disken i rotation. Boten stänger ticketen. Hurra!
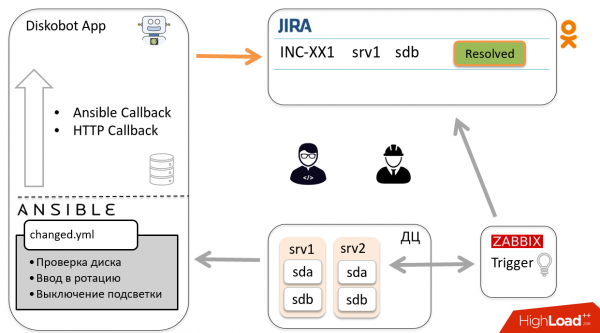
Nu pratar vi om några komponenter i systemet.
Diskobot
Denna applikation är skriven i Python. Den väljer tickets från Jira enligt JQL. Beroende på ticketens status kommer den sistnämnda att gå till den motsvarande hanteraren, som i sin tur startar den Ansible playbook som motsvarar statusen.
JQL och undersökningsintervall definieras i applikationens konfigurationsfil.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Till exempel, bland biljetter i statusen In progress, väljs endast de som har fälten Disk size och Device name ifyllda. Device name är namnet på blockenheten som behövs för att köra playbook’en. Disk size behövs för att ingenjören ska veta vilken storlek på disken som krävs.
Bland biljetter med statusen Ready filtreras biljetter med etiketten dbot_ignore. För övrigt använder vi Jira-etiketter både för sådan filtrering och för att märka dubbletter av biljetter, samt för att samla statistik.
Vid ett fel i playbook’en tilldelar Jira etiketten dbot_failed så att det senare går att reda ut.
Interaktion med Ansible
Applikationen interagerar med Ansible via . I playbook_executor skickar vi filnamnet och en uppsättning variabler. Detta gör att vi kan hålla Ansible-projektet i form av vanliga yml-filer, istället för att beskriva det i Python-kod.
Dessutom överförs namn på blockenheten, status för biljetten och callback_url via *extra_vars*, där fråga nyckeln är inbäddad — den används för callback i HTTP.
För varje körning genereras en tillfällig inventory som består av en värd och en grupp som denna värd ingår i, så att group_vars tillämpas.
Här är ett exempel på en uppgift som implementerar HTTP callback.
Resultatet av playbook-körningar får vi genom callback(s). De finns i två typer:
- , den tillhandahåller data om resultaten av playbook-körningen. Där beskrivs uppgifter som har startats, som har genomförts framgångsrikt eller misslyckats. Denna callback anropas vid slutet av körningen av playbook’en.
- HTTP callback för att få information under körningen av playbook’en. I Ansible-uppgiften gör vi en POST/GET-förfrågan till vår applikation.
Genom HTTP callback(s) överförs variabler som har definierats vid körningen av playbook’en och som vi vill spara och använda i kommande körningar. Dessa data skriver vi till sqlite.
Även genom HTTP callback lämnar vi kommentarer och ändrar statusen för biljetten.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Som många liknande uppgifter har vi flyttat det till en separat gemensam fil och inkluderar det vid behov för att inte ständigt upprepa det i playbooks. Här nämns callback_url, där issue key och host name är inbäddade. När Ansible utför denna POST-begäran förstår boten att den kom inom ramen för en viss incident.
Här är ett exempel från playbooken där vi tog bort en disk från MD-enheten:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Denna uppgift ändrar Jira-biljetten till status "Ready to change" och lägger till en kommentar. Dessutom sparas listan över md-enheter från vilka disken har tagits bort i variabeln mdam_data, och partitionens dump från parted sparas i parted_info.
När ingenjören sätter in en ny disk kan vi använda dessa variabler för att återställa partitionens dump och registrera disken i de md-enheter där den togs bort.
Ansible check-läge
Det var skrämmande att aktivera automatiseringen. Därför beslutade vi oss för att köra alla playbooks i läget
, i vilket Ansible inte utför några åtgärder på servrarna, utan endast emulerar dem.
Denna körning går genom en separat callback-modul, och resultatet av playbookens körning sparas i Jira som en kommentar.
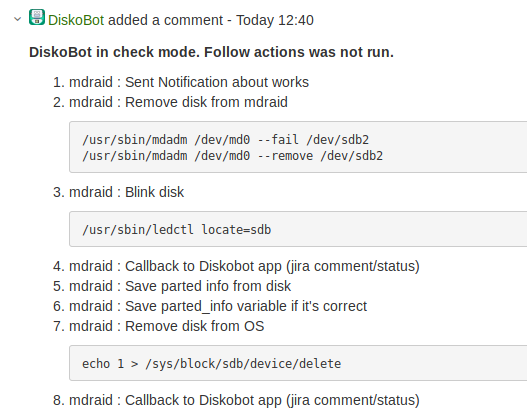
För det första gjorde detta att vi kunde validera botens och playbookarnas funktion. För det andra ökade det administratörernas förtroende för boten.
När vi genomgick valideringen och insåg att vi kan köra Ansible inte bara i dry run-läget, skapade vi en knapp i Jira, Run Diskobot, för att köra samma playbook med samma variabler på samma värd, men i normalt läge.
Dessutom används knappen för att köra om playbooken vid eventuell fel.
Strukturen för Playbooks
Jag har redan nämnt att beroende på statusen för Jira-biljetten, kör boten olika playbooks.
För det första är det mycket enklare att organisera ingången.
För det andra är det i vissa fall helt enkelt nödvändigt.
Till exempel, vid byte av systemdisk måste man först gå till distributionssystemet, skapa en uppgift, och efter korrekt distribution blir servern tillgänglig via ssh och man kan installera applikationen. Om vi hade gjort allt detta i en playbook skulle Ansible inte ha kunnat utföra den på grund av värdens otillgänglighet.
Vi använder Ansible-roller för varje servergrupp. Här kan man se hur playbooks är organiserade i en av dem.
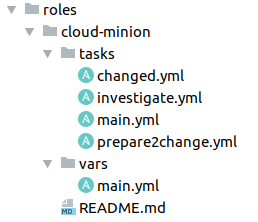
Det är bekvämt eftersom det är tydligt var olika uppgifter ligger. I main.yml, som är ingången för Ansible-rollen, kan vi ha en enkel include baserat på ticketstatus eller gemensamma uppgifter som behövs för alla, till exempel identifiering eller hämta token.
Investigation.yml
Körs för biljetter i statusen Investigation och Open. Det viktigaste för denna playbook är namnet på blockenheten. Denna information är inte alltid tillgänglig.
För att få denna information analyserar vi Jira-sammanfattningen, det senaste värdet från Zabbix-trigger. Där kan namnet på blockenheten finnas — om vi har tur. Annars kan det innehålla mount point, då måste vi gå till servern, parsa och räkna ut rätt disk. Triggern kan också skicka scsi-adress eller annan information. Men ibland finns det inga ledtrådar, och vi måste analysera.
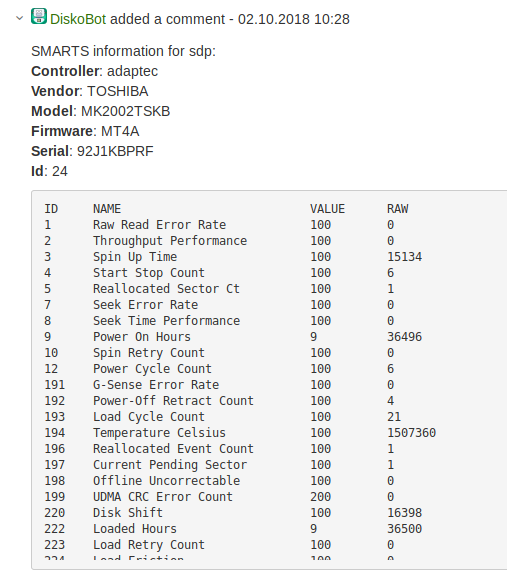
När vi har namnet på blockenheten samlar vi information om typ och storlek på disken för att fylla i fälten i Jira. Vi får också information om tillverkaren, modell, firmware, ID, SMART, och allt detta läggs till kommentaren i Jira-ticket. Administratören och ingenjören behöver nu inte leta efter dessa uppgifter. 🙂
prepare2change.yml
Ta ut disken från rotation, förbereda för byte. Det är det svåraste och mest ansvarsfulla steget. Här kan man stanna applikationen när den inte kan stoppas. Eller ta ut en disk som hade brist på repliker, vilket påverkar användarna och kan leda till dataförlust. Här har vi flest kontroller och aviseringar i chatten.
I det enklaste fallet handlar det om att ta bort disken från HW/MD RAID.
I mer komplexa situationer (i våra lagringssystem), när redundans utförs på applikationsnivå, måste man gå in i applikationen via API, rapportera om uttag av disken, inaktivera den och initiera återställningen.
Vi migrerar nu massivt till , och om servern är molnbaserad, kontaktar Diskobot molnets API, säger att den tänker arbeta med denna mini-server — servern där containrar körs — och ber "migrera alla containrar från denna mini-server". Samtidigt slår den på diskens belysning så att ingenjören direkt kan se vilken som behöver tas bort.
changed.yml
Efter diskbytet kontrollerar vi först dess tillgänglighet.
Ingenjörer byter inte alltid ut diskar, så vi har lagt till en kontroll av de SMART-värden som vi är nöjda med.
Vilka attribut tittar vi påReallocated Sectors Count (5) < 100
Current Pending Sector Count (107) == 0
Om disken inte klarar kontrollen meddelas ingenjören om att den ska bytas ut igen. Om allt är i ordning släcks belysningen, mätningen appliceras och disken tas i rotation.
ready.yml
Det enklaste fallet: kontroll av synkronisering av HW/SW raid eller avslutning av datasykronisering i applikationen.
Applikations-API
Jag har nämnt flera gånger att boten ofta kontaktar applikations-API:et. Självklart hade inte alla applikationer de nödvändiga metoderna, så vi var tvungna att revidera dem. Här är de viktigaste metoderna som vi använder:
- Status. Status för klustret eller disken för att förstå om det går att arbeta med det;
- Start/stop. Aktivering och deaktivering av disken;
- Migrate/restore. Migrering och återställande av data under och efter bytet.
Erfarenhet från Ansible
Jag älskar Ansible väldigt mycket. Men ofta, när jag ser på olika opensource-projekt och ser hur folk skriver playbooks, blir jag lite skrämd. Komplexa logiska sammanflätningar av when/loop, brist på flexibilitet och idempotens på grund av frekvent användning av shell/command.
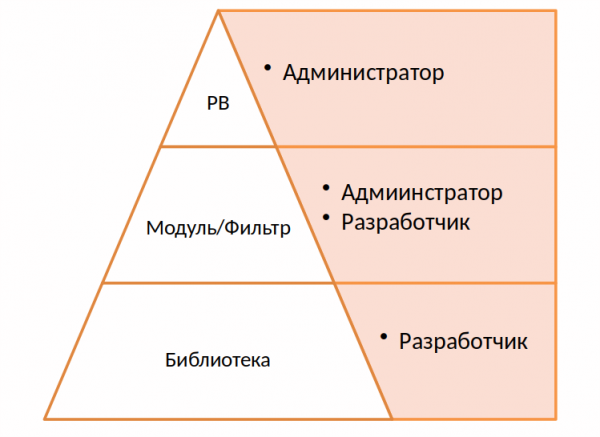
Vi har valt att förenkla allt så mycket som möjligt genom att dra nytta av Ansibles modulär struktur. På högsta nivå finns playbooks, som kan skrivas av vilken administratör som helst, extern utvecklare som har lite kunskap om Ansible.
- name: Blink disk
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
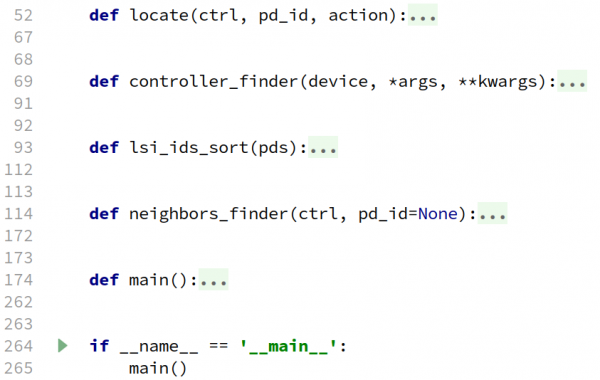
Om någon logik är svår att implementera i playbooks, tar vi ut den i en Ansible-modul eller filter. Skripten kan skrivas antingen i Python eller vilket annat språk som helst.
De är lätta och snabba att skriva. Till exempel består modulen för att blinka disken, vars användning beskrivs ovan, av 265 rader.
På den lägsta nivån finns biblioteket. För detta projekt skrev vi en separat applikation, en slags abstraktion över hårdvaru- och mjukvaru-RAID som utför motsvarande förfrågningar.
Ansibles starkaste sidor är dess enkelhet och tydliga playbooks. Jag anser att vi bör utnyttja detta och inte generera skrämmande yaml-filer och en mängd villkor, shell-kod och loopar.
Om du vill upprepa vår erfarenhet med Ansible API, ha två saker i åtanke:
- Playbook_executor och playbook kan överhuvudtaget inte ges en timeout. Det finns en timeout för ssh-sessioner, men ingen timeout för playbook. Om vi försöker avmontera en disk som inte längre finns i systemet, kommer playbook att köras oändligt, så vi var tvungna att slå in dess körning i ett eget wrapper och döda den efter timeout.
- Ansible är baserat på fork-processer, så dess API är inte trådsäkert. Vi kör alla våra playbooks entrådigt.
Som ett resultat har vi lyckats automatisera bytet av cirka 80 % av diskarna. Generellt har hastigheten för bytena fördubblats. Idag tittar administratören bara på incidenten och beslutar om disken behöver bytas eller inte, och gör sedan ett enda klick.
Men nu börjar vi ställas inför ett annat problem: vissa nya administratörer vet inte hur man byter diskar. 🙂
Källa: habr.com
