

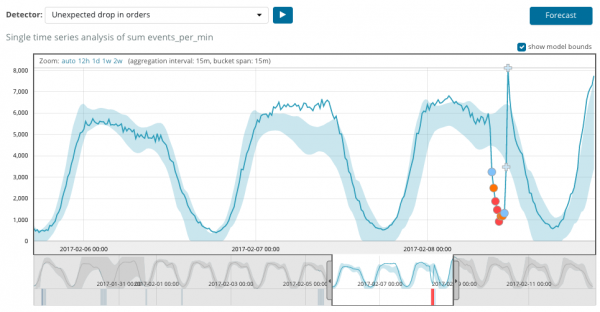
Vi påminner om att Elastic Stack bygger på den icke-relationella databasen Elasticsearch, webbgränssnittet Kibana och datainsamlingsverktyg (det mest kända är Logstash, olika Beats, APM och andra). En av de trevliga tilläggarna till hela denna produktstack är dataanalys med hjälp av maskininlärningsalgoritmer. I artikeln undersöker vi vad dessa algoritmer innebär. Vi ber er att läsa vidare.
Maskininlärning är en betald funktion i den kvalitetsfria Elastic Stack och ingår i X-Pack. För att börja använda den behöver man bara aktivera en 30-dagars provversion efter installationen. Efter att provperioden har löpt ut kan man begära stöd för förlängning eller köpa en prenumeration. Kostnaden för prenumerationen baseras inte på datavolym, utan på antalet använda noder. Nej, datavolymen påverkar självklart antalet noder som behövs, men denna licensieringsmetod är mer människovänlig i förhållande till företagets budget. Om hög prestanda inte är nödvändig kan man spara pengar.
ML i Elastic Stack är skrivet i C++ och fungerar utanför JVM, där själva Elasticsearch körs. Det vill säga att processen (den kallas för autodetect) konsumerar allt som JVM inte tar hand om. På demoväggen är det inte så kritiskt, men i produktionsmiljö är det viktigt att avsätta separata noder för ML-uppgifter.
Maskininlärningsalgoritmer delas in i två kategorier - och . I Elastic Stack tillhör algoritmen kategorin "utan lärare". Enligt kan man se den matematiska grunden för maskininlärningsalgoritmer.
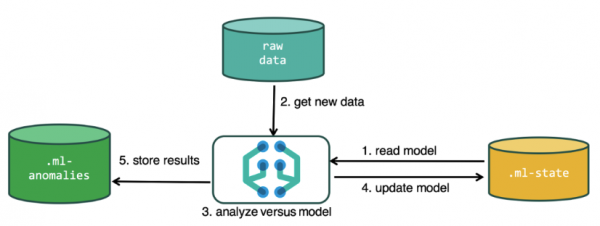
För att utföra analys använder maskininlärningsalgoritmen data som lagras i Elasticsearch-index. Uppdrag för analys kan skapas både från Kibana-gränssnittet och via API. Om man gör detta via Kibana är vissa saker inte nödvändiga att veta. Till exempel, ytterligare index som algoritmen använder under arbetets gång.
Ytterligare index som används i analysprocessen.ml-state - information om statistiska modeller (analysinställningar);
.ml-anomalies-* - resultat från ML-algoritmer;
.ml-notifications - inställningar för aviseringar om analysresultat.
Databasen i Elasticsearch består av index och de dokument som lagras i dem. Om man jämför med en relationsdatabas kan man likna ett index vid databasens schema och ett dokument vid en post i en tabell. Denna jämförelse är villkorlig och ges för att förenkla förståelsen av det följande materialet för dem som bara hört talas om Elasticsearch.
Genom API:et finns samma funktionalitet tillgänglig som via webbgränssnittet, så för tydlighetens skull och för att förstå koncepten kommer vi att visa hur man konfigurerar via Kibana. I menyn till vänster finns en sektion för maskininlärning där man kan skapa en ny uppgift (Job). I Kibana-gränssnittet ser detta ut som på bilden nedan. Nu kommer vi att gå igenom varje typ av uppgift och visa vilken analys som kan konstrueras här.
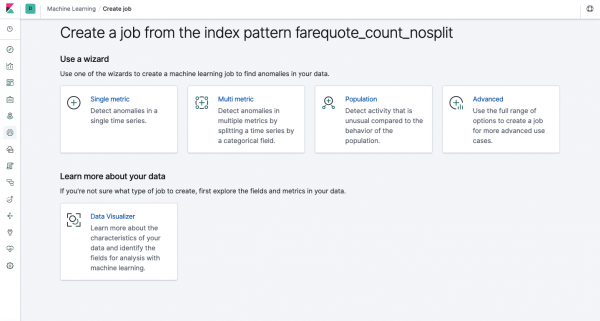
Single Metric — analys av en enda mätning, Multi Metric — analys av två eller fler mätningar. I båda fallen analyseras varje mätning i en isolerad miljö, det vill säga att algoritmen inte tar hänsyn till beteendet hos de parallellt analyserade mätningarna, vilket kan ha framkommit i fallet med Multi Metric. För att göra beräkningen med hänsyn till korrelationen mellan olika mätningar kan man tillämpa Population-analys. Advanced är en finjustering av algoritmerna med ytterligare alternativ för specifika uppgifter.
Single Metric
Analys av förändringar i en enda mätning är det enklaste man kan göra här. Efter att ha klickat på Skapa uppgift kommer algoritmen att söka efter avvikelser.
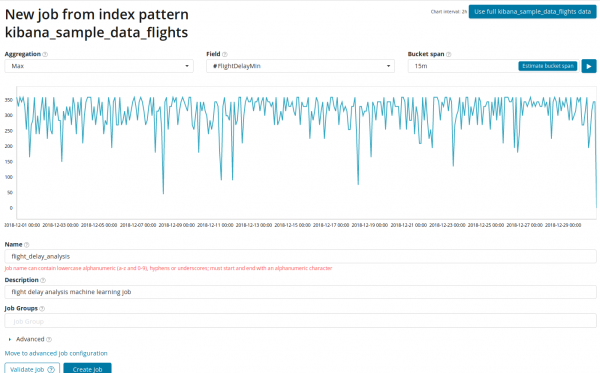
I fältet Aggregation kan man välja tillvägagångssätt för att söka efter avvikelser. Till exempel, när Min värden som är lägre än typiska kommer att anses som avvikande. Det finns Max, Hign Mean, Low, Mean, Distinct och andra. Beskrivning av alla funktioner kan ses .
I fältet Field anger numeriskt fält i dokumentet som vi ska analysera.
I fältet — granulariteten av intervallen på tidslinjen som analysen kommer att göras på. Man kan lita på automatiseringen eller välja manuellt. På bilden nedan ges ett exempel på för låg granularitet — du kan missa en avvikelse. Med denna inställning kan man justera algoritmens känslighet för avvikelser.
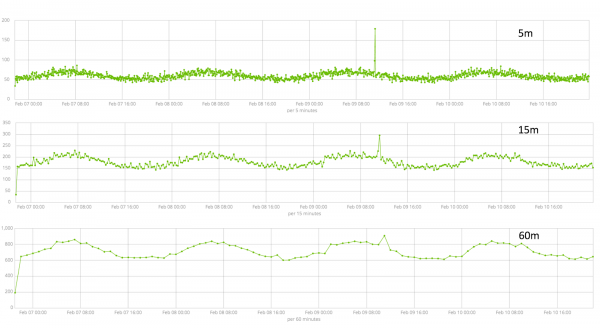
Varaktigheten av de insamlade data är en nyckelfaktor som påverkar effektiviteten i analysen. Vid analysen bestämmer algoritmen återkommande intervall, beräknar konfidensintervall (grundlinjer) och identifierar avvikelser — ovanliga avvikelser från normalt beteende hos mätningen. Bara som exempel:
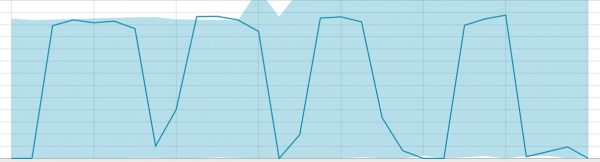
Grundlinjer för ett litet datasegment:
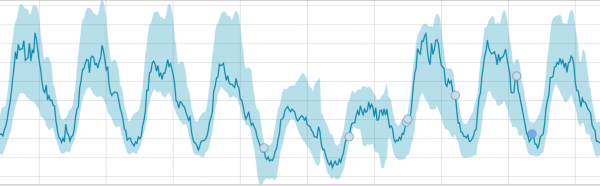
När algoritmen har något att lära sig — ser grundlinjerna ut så här:
Efter att uppdraget har körts, identifierar algoritmen avvikande anomalier från normen och rankar dem efter sannolikheten för anomalier (färgen på motsvarande etikett anges inom parentes):
Varning (blå): mindre än 25
Mindre (gul): 25-50
Större (orange): 50-75
Kritiskt (röd): 75-100
I diagrammet nedan visas ett exempel på funna anomalier.
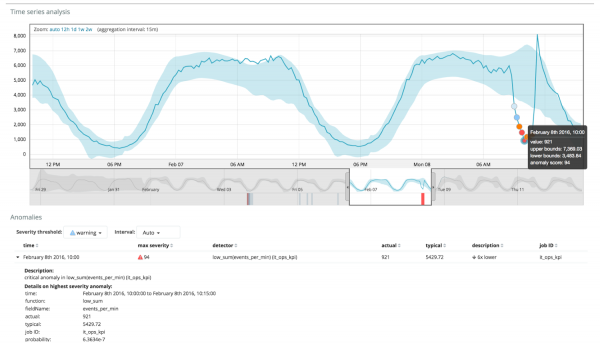
Här syns siffran 94, som anger sannolikheten för anomalier. Det är uppenbart att eftersom värdet är nära 100, så är detta en anomali. I kolumnen under diagrammet anges en försvinnande liten sannolikhet på 0,000063634% att detta värde förekommer.
Förutom att söka efter anomalier i Kibana kan man också initiera prognoser. Detta görs enkelt och från samma vy med anomalier — knappen Prognos i det övre högra hörnet.
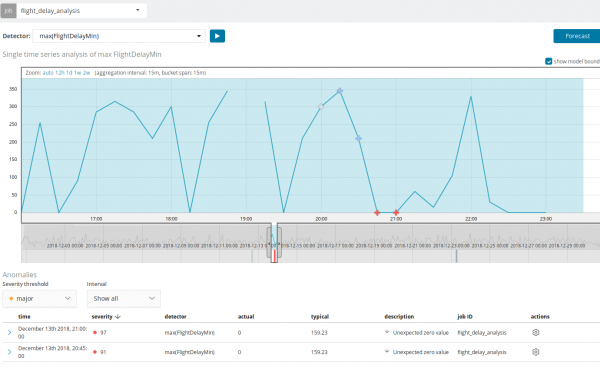
Prognosen sträcker sig högst 8 veckor framåt. Även om man verkligen önskar — mer än så går inte enligt design.
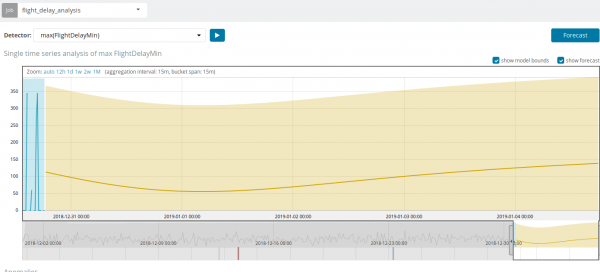
I vissa situationer kan prognosen vara mycket användbar, exempelvis när man övervakar användarlast på infrastrukturen.
Multi Metric
Vi går vidare till den nästa möjligheten av ML i Elastic Stack — analys av flera metrik i en enda sats. Men det betyder inte att en metrik kommer att analyseras i förhållande till en annan. Det är samma sak som Single Metric, men med flera metrik på en skärm för att underlätta jämförelse av påverkan av en på den andra. Vi kommer att tala om analysen av beroendet mellan en metrik och en annan i delen Population.
Efter att ha klickat på rutan med Multi Metric kommer ett fönster med inställningar att dyka upp. Vi kommer att stanna vid dem mer i detalj.
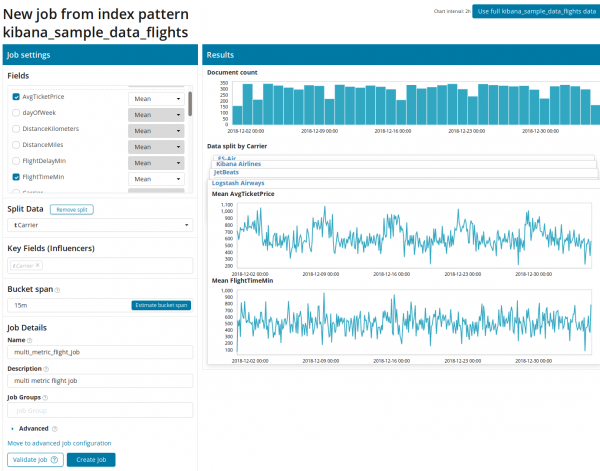
Först måste du välja fälten för analys och aggregering av data på dessa. Aggregeringsalternativen här är desamma som för Single Metric (Max, Hign Mean, Low, Mean, Distinct och andra). Därefter kan data vid behov delas upp enligt ett av fälten (fältet Split Data). I exemplet delade vi upp detta efter fältet OriginAirportID. Observera att diagrammet för metrik nu visas som en mängd olika diagram till höger.
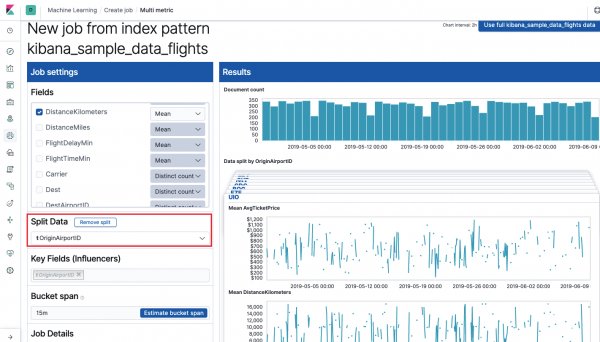
Fältet Key Fields (Influencers) påverkar direkt de funna anomalierna. Som standard kommer det alltid att finnas minst ett värde här, men du kan lägga till fler. Algoritmen kommer att ta hänsyn till påverkan av dessa fält vid analysen och visa de mest "inflytelserika" värdena.
Efter att ha startat kommer gränssnittet i Kibana att se ut ungefär så här.
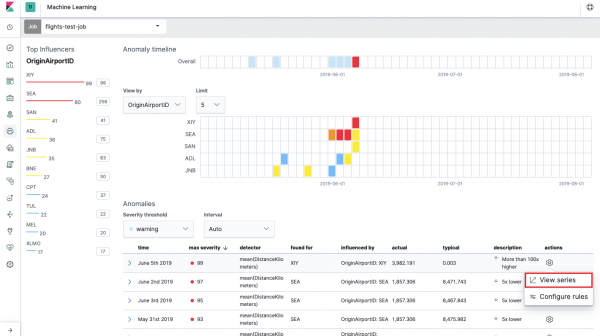
Detta är en så kallad värmekarta över anomalier för varje värde av fältet. OriginAirportID, som vi angav i Split Data. Precis som i fallet med Single Metric indikerar färgen nivån av avvikelse. En liknande analys är praktisk att göra, till exempel för arbetsstationer för att spåra de med misstänkt många inloggningar osv. Vi har redan skrivit , som också kan samlas in och analyseras här.
Under värmekartan finns en lista över avvikelser, och man kan gå till varje enskild avvikelse för en detaljerad analys.
Population
För att söka efter avvikelser mellan correlationer mellan olika metrik i Elastic Stack finns det en specialiserad Population-analys. Just med hjälp av den kan man leta efter avvikande värden i prestandan hos en server i jämförelse med andra, till exempel vid en ökning av antalet förfrågningar till det mål systemet.
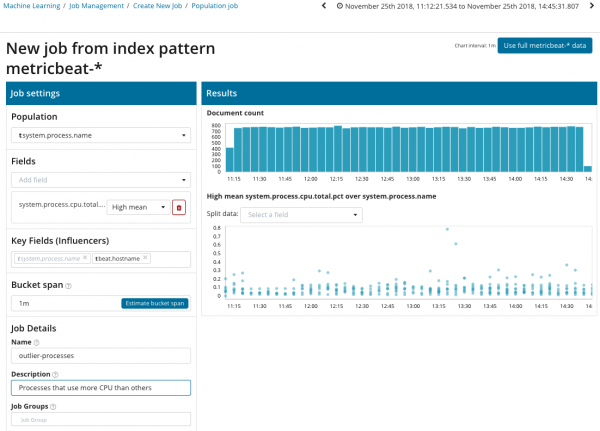
I denna illustration anges i Population-fältet det värde som de analyserade metrikerna kommer att relatera till. I detta fall är det namn på processen. Som resultat kommer vi att se hur CPU-belastningen hos varje process påverkade varandra.
Observera att grafen med de analyserade uppgifterna skiljer sig från fallen med Single Metric och Multi Metric. Detta gjordes i Kibana av design för att förbättra uppfattningen av distributionen av värdena i de analyserade uppgifterna.
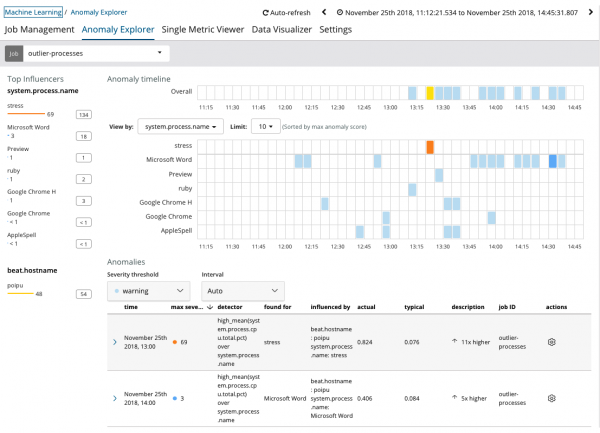
Från grafen kan man se att processen stress (för övrigt skapad av ett specialverktyg) på servern poipu, som påverkade (eller var inflytelserik) i uppkomsten av denna avvikelse.
Avancerad
Analys med finjustering. Vid avancerad analys i Kibana visas ytterligare inställningar. Efter att ha klickat på skapande-menyn på rutan Avancerad visas en sådan här dialogruta med flikar. Fliken Job Details har medvetet utelämnats, där finns grundläggande inställningar som inte rör själva analysinställningen.
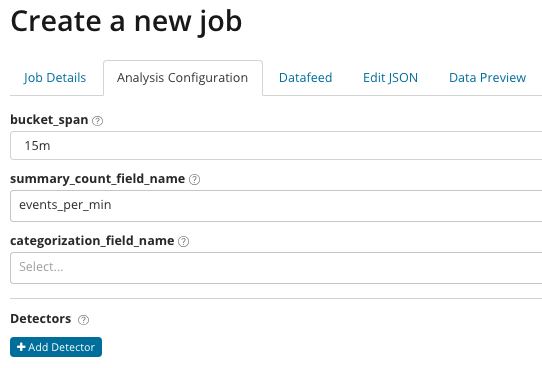
I summary_count_field_name kan valfritt ange namnet på fältet i dokumenten som innehåller aggregerade värden. I detta exempel — antalet händelser per minut. I anges namnet på fältet i dokumentet som innehåller ett visst variabelvärde. Med mönstrets hjälp kan detta fält användas för att dela upp de analyserade uppgifterna i delmängder. Observera knappen Add detector på föregående illustration. Nedan resultatet av att klicka på denna knapp.
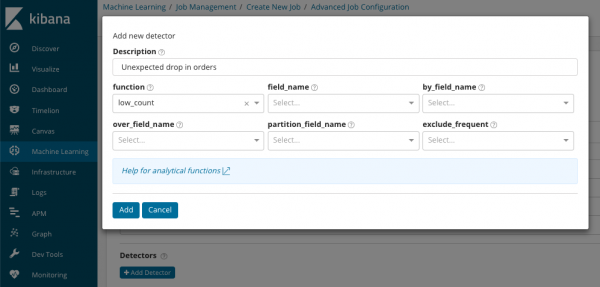
Här är ett ytterligare inställningsblock för att anpassa anomalidetektorn för en specifik uppgift. Konkreta användningsfall (särskilt inom säkerhet) planerar vi att ta upp i kommande artiklar. Till exempel, ett av de behandlade fallen. Det handlar om att hitta sällan förekommande värden och realiseras .
I fältet function kan du välja en specifik funktion för att söka efter anomalier. Förutom rare, finns det ett par andra intressanta funktioner — . Dessa identifierar anomalier i beteendet hos mätvärden under dagen eller veckan respektive. Andra analysfunktioner .
I field_name anger det fält i dokumentet som analysen kommer att baseras på. By_field_name kan användas för att dela analysresultaten efter varje särskilt värde av det angivna fältet. Om over_field_name används blir det population-analys, som vi diskuterade ovan. Om ett värde anges i partition_field_name, kommer separata baslinjer att beräknas för varje värde av detta dokumentfält (till exempel kan namnet på servern eller processen på servern fungera som värde). I exclude_frequent kan du välja all eller none, vilket innebär uteslutning (eller inkludering) av ofta förekommande värden i dokumentfälten.
I artikeln har vi försökt ge en så kortfattad presentation som möjligt av maskininlärningens möjligheter i Elastic Stack, men det finns fortfarande många detaljer kvar att ta upp. Berätta gärna i kommentarerna om vilka fall ni har lyckats lösa med hjälp av Elastic Stack och för vilka uppgifter ni använder det. För att kontakta oss kan ni använda privata meddelanden på Habr eller .
Källa: habr.com
