

I artikeln kommer jag att berätta hur vi närmade oss frågan om tillförlitlighet för PostgreSQL, varför det blev viktigt för oss och vad vi slutligen åstadkom.
Vi har en högbelastad tjänst: 2,5 miljoner användare världen över, över 50 000 aktiva användare varje dag. Servrarna ligger i Amazon inom en region i Irland: mer än 100 olika servrar är ständigt i drift, varav nästan 50 har databaser.
Hela backend-området är en stor monolitisk stateful-applikation på Java, som upprätthåller en konstant websocket-anslutning till klienten. När flera användare arbetar samtidigt på samma tavla ser alla förändringar i realtid, eftersom varje förändring registreras i databasen. Vi har ungefär 10 000 förfrågningar per sekund till våra databaser. Under toppbelastning skriver vi i Redis med 80-100 000 förfrågningar per sekund.
Varför vi gick från Redis till PostgreSQL
Ursprungligen fungerade vår tjänst med Redis, en key-value-lagring som lagrar all data i minnet. servern.
Fördelar med Redis:
- Hög svarsförmåga, eftersom allt lagras i minnet;
- Bekväm backup och replikering.
Nackdelar med Redis för oss:
- Det finns inga verkliga transaktioner. Vi försökte simulera dem på applikationsnivå. Tyvärr fungerade detta inte alltid bra och krävde mycket komplicerad kod.
- Datamängden är begränsad av mängden minne. När datamängden ökar kommer minnet att växa, och till slut kommer vi att nå kapacitetsgränserna för den valda instansen, vilket i AWS kräver att vi stoppar vår tjänst för att ändra typ av instans.
- Det är nödvändigt att ständigt upprätthålla en låg latensnivå, eftersom vi har ett mycket stort antal förfrågningar. Optimal latens för oss är 17-20 ms. Vid en latens på 30-40 ms får vi långa svar på våra applikationsförfrågningar och degradering av tjänsten. Tyvärr inträffade detta i september 2018, när en av instanserna med Redis av någon anledning fick en latens som var dubbelt så hög som vanligt. För att lösa problemet stoppade vi tjänsten mitt på dagen för underhåll och ersatte den problematiska Redis-instansen.
- Det är lätt att få inkonsekvens i datan även vid små fel i koden och sedan spendera mycket tid på att skriva kod för att rätta till dessa data.
Vi har beaktat nackdelarna och insett att vi behöver flytta till något mer bekvämt, med normala transaktioner och mindre beroende av latens. Vi genomförde en undersökning, analyserade många alternativ och valde PostgreSQL.
Vi har flyttat till den nya databasen i 1,5 år och har bara flyttat en liten del av datan, så vi arbetar för närvarande med både Redis och PostgreSQL. Mer om etapperna för flytten och övergången av data mellan databaserna står det i artikeln av min kollega.
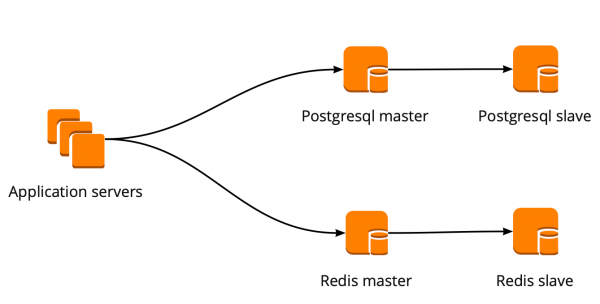
När vi precis började flytta, arbetade vår applikation direkt med databasen och kommunicerade med master Redis och PostgreSQL. PostgreSQL-klustret bestod av en master och en replik med asynkron replikering. Så här såg schemat ut för arbete med databaserna:
Implementering av PgBouncer
Under tiden vi flyttade, utvecklades produkten också: antalet användare och servrar som arbetade med PostgreSQL ökade, och vi började få brist på anslutningar. PostgreSQL skapar en separat process för varje anslutning och förbrukar resurser. Antalet anslutningar kan ökas till en viss punkt, annars finns risken att databasen arbetar suboptimalt. Den ideala lösningen i en sådan situation är att välja en anslutningshanterare som placeras framför databasen.
Vi hade två alternativ för anslutningshanterare: Pgpool och PgBouncer. Men den första stöder inte transaktionsläge med databasen, så vi valde PgBouncer.
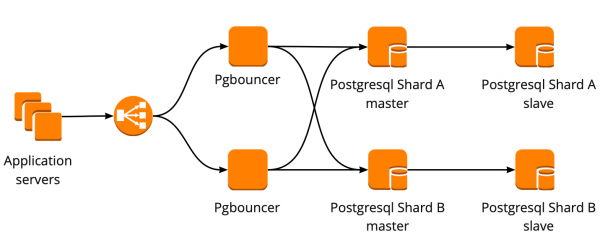
Vi har ställt in följande arbetsschema: vår applikation kommunicerar med en PgBouncer, som har PostgreSQL-masters bakom sig, och bakom varje master finns en replik med asynkron replikering.
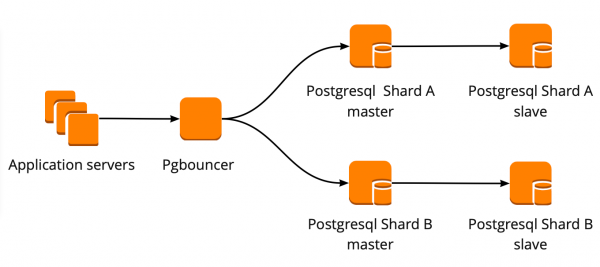
Samtidigt kunde vi inte lagra hela datamängden i PostgreSQL och hastigheten på datahanteringen var viktig för oss, så vi började shardera PostgreSQL på applikationsnivå. Det ovan beskrivna schemat är relativt bekvämt för detta: vid tillägg av ett nytt shard är det tillräckligt att uppdatera PgBouncer-konfigurationen så att applikationen kan börja arbeta med det nya shardet.
Felresistens för PgBouncer
Detta system fungerade fram till dess att den enda instansen av PgBouncer dog. Vi befinner oss i AWS, där alla instanser körs på hårdvara som ibland går ner. I sådana fall flyttas instansen bara till ny hårdvara och fungerar igen. Så var även fallet med PgBouncer, men den blev otillgänglig. Resultatet av detta nedfall blev att vår tjänst var otillgänglig i 25 minuter. AWS rekommenderar för sådana situationer att använda redundans på användarsidan, vilket vi inte hade implementerat vid den tidpunkten.
Efter detta började vi seriöst fundera på tillförlitlighet för PgBouncer och PostgreSQL-kluster, eftersom en liknande situation kunde inträffa med vilken instans som helst i vårt AWS-konto.
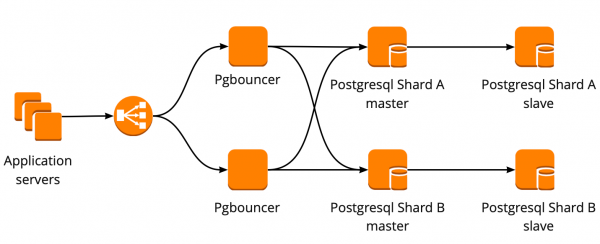
Vi byggde PgBouncer:s redundansmodell på följande sätt: alla applikationsservrar kontaktar Network Load Balancer, bakom vilken det finns två PgBouncer-instanser. Varje PgBouncer pekar på samma master PostgreSQL för varje shard. Om en instans av AWS faller, omdirigeras all trafik genom den andra PgBouncer. AWS säkerställer redundans för Network Load Balancer.
Denna konfiguration gör det problemfritt att lägga till nya PgBouncer-servrar.
Att skapa ett tillförlitligt PostgreSQL-kluster
Vid lösningen av denna uppgift övervägde vi olika alternativ: skräddarsydd failover, repmgr, AWS RDS, Patroni.
Egenutvecklade skript
Dessa kan övervaka masterns status och, om den faller, höja en replik till master och uppdatera PgBouncer-konfigurationen.
Fördelarna med detta tillvägagångssätt ligger i den maximala enkelheten, eftersom du själv skriver skripten och exakt förstår hur de fungerar.
Nackdelar:
- Master kan ha överlevt, istället kan ett nätverksfel ha inträffat. Failover, utan att veta detta, kommer att höja en replik till master, och den gamla master kommer att fortsätta att fungera. Som ett resultat får vi två servrar i rollen som master och vi vet inte vilken av dem som har de senaste aktuella uppgifterna. En sådan situation kallas också split-brain;
- Vi blev utan replik. I vår konfiguration finns det en master och en replik, efter omkopplingen höjs replik till master och vi har inga fler replikar, så vi måste manuellt lägga till en ny replik;
- Ytterligare övervakning av failover-processen behövs, och vi har 12 shard av PostgreSQL, vilket innebär att vi måste övervaka 12 kluster. Vid ökning av antalet shards får vi inte glömma att uppdatera failover.
Egenutvecklad failover verkar mycket komplicerad och kräver omfattande support. När det gäller en PostgreSQL-kluster är detta den enklaste lösningen, men den är inte skalbar, så den passar oss inte.
Repmgr
Replication Manager för PostgreSQL-kluster, som kan hantera driften av ett PostgreSQL-kluster. Det finns ingen automatisk failover ‘ur lådan’, så det krävs att man skriver sin egen ‘wrapper’ ovanpå den färdiga lösningen. Så det kan visa sig vara ännu mer komplicerat än med egenutvecklade skript, därför bestämde vi oss för att inte ens pröva Repmgr.
AWS RDS
Stöder allt nödvändigt för oss, kan göra backups och stöder connection pool. Har automatisk switchning: när huvudservern dör blir en replica den nya huvudservern, och AWS ändrar DNS-posterna till den nya huvudservern, medan replication kan finnas i olika AZ.
Nackdelar inkluderar avsaknaden av finjustering. Ett exempel på finjusteringar: på våra instanser finns det begränsningar för TCP-anslutningar, vilket tyvärr inte går att göra i RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Dessutom är priset för AWS RDS nästan dubbelt så hög som det vanliga priset för instansen, vilket var den huvudsakliga anledningen till att vi avstod denna lösning.
Patroni
Detta är en mal på python för att hantera PostgreSQL med bra dokumentation, automatisk failover och öppen källkod på GitHub.
Fördelar med Patroni:
- Varje konfigurationsparameter är tydligt beskriven, det är klart hur allt fungerar;
- Automatisk failover fungerar ur lådan;
- Skriven i python, och eftersom vi själva skriver mycket i python, kommer vi att ha lättare att hantera problem och kanske till och med hjälpa till med projektets utveckling;
- Hanterar PostgreSQL helt och hållet, gör att man kan ändra konfigurationen direkt på alla noder i klustret, och om en omstart av klustret krävs för att tillämpa den nya konfigurationen, kan detta också göras med hjälp av Patroni.
Nackdelar:
- Det framgår inte tydligt i dokumentationen hur man korrekt arbetar med PgBouncer. Även om det är svårt att kalla detta en nackdel, eftersom uppgiften för Patroni är att hantera PostgreSQL, och hur anslutningar går till Patroni är vårt problem;
- Få exempel på implementering av Patroni i stor skala, samtidigt som det finns många exempel på implementering från grunden.
Slutligen valde vi att använda just Patroni för att skapa en hög tillgänglighet kluster.
Implementeringsprocessen av Patroni
Innan vi introducerade Patroni hade vi 12 PostgreSQL-shardar med konfigurationen en master och en replika med asynkron replikering. Applikationsservrarna kontaktade databaserna via Network Load Balancer, som hade två instanser med PgBouncer, som i sin tur hade alla PostgreSQL-servrar.
För att implementera Patroni behövde vi välja en distribuerad lagring för klusterkonfigurationen. Patroni fungerar med distribuerade konfigurationslagringssystem som etcd, Zookeeper och Consul. Vi har faktiskt en fullt funktionell Consul-kluster i produktion som arbetar i samverkan med Vault och som vi inte använder på något annat sätt. Ett utmärkt tillfälle att börja använda Consul för sitt avsedda syfte.
Hur fungerar Patroni med Consul
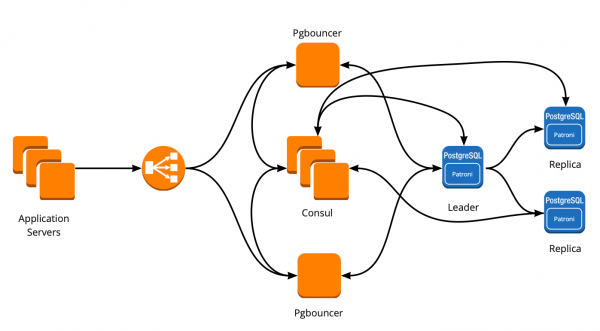
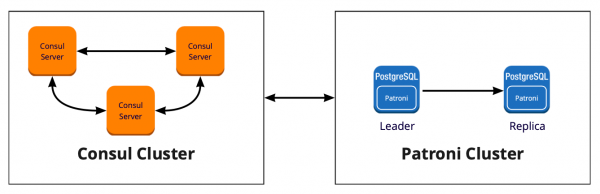
Vi har ett Consul-kluster som består av tre noder och ett Patroni-kluster som består av en ledare och en replik (i Patroni kallas master för klusterledare och slavarna för replikor). Varje instans av Patroni-klustret skickar kontinuerligt information om klusterstatus till Consul. Därför kan man alltid i Consul ta reda på den aktuella konfigurationen av Patroni-klustret och vem som för tillfället är ledare.
För att koppla Patroni till Consul räcker det med att studera den officiella dokumentationen, som säger att man måste ange värd i formatet http eller https beroende på hur vi arbetar med Consul, samt kopplingsschema, vilket är valfritt:
host: värd:port för Consul-slutpunkten, i formatet: http(s)://host:port
schema: (valfritt) http eller https, standardinställningen är http
Det ser enkelt ut, men här börjar underströmmarna. Vi arbetar med Consul via en säker anslutning genom https, och vår anslutningskonfiguration ser ut på följande sätt:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Men så fungerar det inte. Vid starten kan inte Patroni ansluta till Consul, eftersom den försöker gå via http.
För att lösa problemet hjälpte källkoden för Patroni. Tur att den är skriven i python. Det visar sig att värdparametern inte parsas alls, utan protokollet måste anges i schema. Så här ser blocket för fungerande konfiguration ut för att arbeta med Consul hos oss:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Så, vi har valt en lagringslösning för konfigurationen. Nu måste vi förstå hur PgBouncer kommer att byta sin konfiguration när ledaren i klustret Patroni ändras. Det finns inget svar på denna fråga i dokumentationen, eftersom det inte finns någon beskrivning av hur PgBouncer fungerar.
I jakten på en lösning fann vi en artikel (tyvärr minns jag inte titeln) där det stod att Consul-template hjälpte mycket i kopplingen mellan PgBouncer och Patroni. Detta fick oss att undersöka hur Consul-template fungerar.
Det visade sig att Consul-template ständigt övervakar konfigurationen av PostgreSQL-klustret i Consul. Vid byte av ledare uppdaterar den PgBouncer-konfigurationen och skickar ett kommando för att ladda om den.
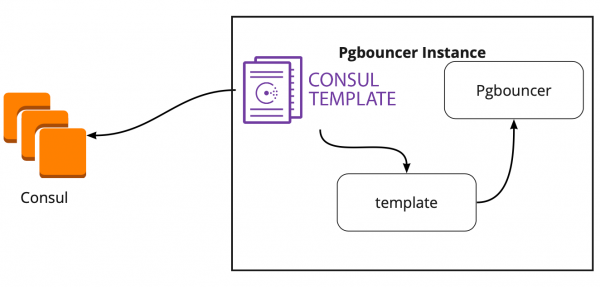
En stor fördel med template är att den lagras i kodform, så när en ny shard läggs till behöver vi bara göra ett nytt commit och uppdatera template automatiskt, vilket stöder principen om Infrastructure as Code.
Ny arkitektur med Patroni
Resultatet blev följande arbetsmönster:
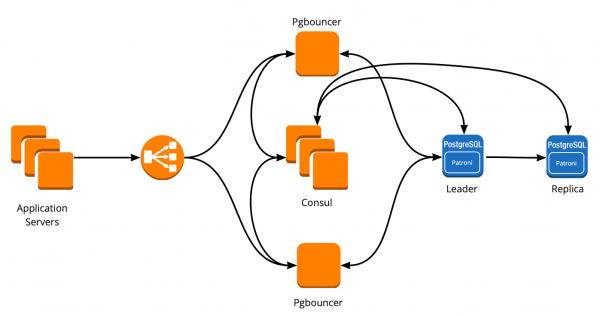
Alla applikationsservrar kontaktar load balancern → bakom den står två instanser av PgBouncer → på varje instans körs Consul-template, som övervakar statusen för varje Patroni-kluster och ser till att PgBouncer-konfigurationen är aktuell, vilket dirigerar förfrågningar till den nuvarande ledaren i varje kluster.
Manuell testning
Innan denna lösning implementerades i produktion testade vi den i en liten testmiljö och kontrollerade det automatiska växlingen. Vi öppnade en tavla, flyttade en lapp och just då "dödade" vi ledaren i klustret. I AWS räcker det med att stänga av instansen via konsolen.
Lappen återvände inom 10-20 sekunder, och sedan började den flytta normalt igen. Det betyder att Patroni-klustret fungerade korrekt: det bytte ledare, skickade information till Consul och Consul-template plockade omedelbart upp denna information, ersatte PgBouncer-konfigurationen och skickade ett kommando för reload.
Hur överlever man hög belastning och bibehåller minimal driftstopp?
Allt fungerar utmärkt! Men nya frågor dyker upp: Hur fungerar det under hög belastning? Hur snabbt och säkert ska allt rullas ut på produktion?
Att svara på den första frågan hjälper oss att använda en testmiljö där vi genomför belastningstestning. Den är helt identisk med produktionen när det kommer till arkitektur och har genererade testdata som ungefär motsvarar produktionens volym. Vi beslutar oss för att "ta ner" en av PostgreSQL-mästarna under testet och se vad som händer. Men innan vi gör det är det viktigt att kontrollera den automatiska distributionen, eftersom vi i denna miljö har flera PostgreSQL-shards, vilket innebär att vi får en utmärkt testning av konfigurationsskripten före produktion.
Båda uppgifterna ser ambitiösa ut, men vi har PostgreSQL 9.6. Kanske vi bör uppgradera direkt till 11.2?
Vi planerar att göra detta i två steg: först uppgradera versionen till 11.2, och sedan starta Patroni.
Uppgradering av PostgreSQL
För att snabbt uppgradera versionen av PostgreSQL måste du använda alternativet -k, som skapar hårda länkar på disken och eliminerar behovet av att kopiera dina data. För databaser på 300-400 GB tar uppgraderingen 1 sekund.
Vi har många shards, så uppgraderingen måste ske automatiskt. För detta har vi skrivit en Ansible-playbook som utför hela uppgraderingsprocessen åt oss:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--länk </b>
--gammal-datadir='' --ny-datadir=''
 --gammal-bindir=''  --ny-bindir=''
 --gammal-alternativ=' -c konfigurationsfil='
 --nya-alternativ=' -c konfigurationsfil='
Här är det viktigt att notera att innan uppgraderingen påbörjas måste den köras med parametern —check, för att vara säker på att uppgraderingen är möjlig. Vårt skript gör också en ersättning av konfigurationerna under uppgraderingen. Skriptet körde på 30 sekunder, vilket är ett utmärkt resultat.
Starta Patroni
För att lösa det andra problemet räcker det med att titta på konfigurationen för Patroni. I det officiella repository finns ett exempel på en konfiguration med initdb som hanterar initialiseringen av en ny databas vid första starten av Patroni. Men eftersom vi redan har en färdig databas, har vi helt enkelt tagit bort den delen från konfigurationen.
När vi började installera Patroni på en befintlig PostgreSQL-kluster och starta den stötte vi på ett nytt problem: båda servrarna startades som ledare. Patroni vet inget om det tidigare tillståndet av klustret och försöker starta båda servrarna som två separata kluster med samma namn. För att lösa detta problem är det nödvändigt att ta bort datakatalogen från slaven:
rm -rf /var/lib/postgresql/Detta måste göras endast på slaven!
Vid anslutning av en ren replik gör Patroni en basebackup av ledaren och återställer den på repliken, för att sedan hämta det aktuella tillståndet via wal-loggar.
En annan utmaning vi stött på är att alla PostgreSQL-kluster som standard kallas main. När varje kluster inte vet något om de andra är det okej. Men när du vill använda Patroni måste alla kluster ha ett unikt namn. Lösningen är att byta namn på klustret i PostgreSQL-konfigurationen.
Belastningstest
Vi genomförde ett test som simulerar användarbeteende på plattformarna. När belastningen nådde vårt genomsnittliga dagliga värde upprepade vi exakt samma test, vi stängde av en instans med ledande PostgreSQL. Den automatiska failovern fungerade som förväntat: Patroni bytte ledare, Consul-template uppdaterade PgBouncers konfiguration och skickade en reload-kommando. Från våra grafer i Grafana kunde vi se att det fanns fördröjningar på 20-30 sekunder och ett litet antal fel från servrar relaterade till anslutningen till databasen. Det är en normal situation, sådana värden är acceptabla för vår failover och absolut bättre än driftsstopp.
Utrullning av Patroni i produktion
Som ett resultat fick vi följande plan:
- Utrullning av Consul-template på PgBouncer-servrar och start;
- Uppgradering av PostgreSQL till version 11.2;
- Byta klusternamn;
- Starta Patroni-klustret.
Vår plan gör det möjligt att utföra första punkten nästan när som helst, vi kan gradvis ta bort varje PgBouncer från drift och genomföra utrullning och start av consul-template. Det var precis vad vi gjorde.
För snabb utrullning använde vi Ansible, eftersom vi redan hade testat alla playbooks i testmiljön, och tiden för att genomföra hela scenariot var mellan 1,5 och 2 minuter för varje shard. Vi kunde rulla ut varje shard sekventiellt utan att stänga av vår tjänst, men vi skulle behöva stänga av varje PostgreSQL i några minuter. I sådana fall kunde användare vars data finns på den shard inte arbeta fullt ut under tiden, vilket är oacceptabelt för oss.
Lösningen på den här situationen blev ett planerat underhåll som genomförs var tredje månad. Detta är ett fönster för planerat arbete när vi stänger av vår tjänst helt och uppgraderar databasinstanser. Det var en vecka kvar till nästa fönster, och vi valde att vänta och förbereda oss ytterligare. Under väntetiden vidtog vi extra precaution: för varje PostgreSQL-shard lyfte vi en reservreplik för att hantera eventuella misslyckanden och en ny instans för varje shard, som skulle bli en ny replik i Patroni-klustret, så att vi inte behövde köra ett kommando för att ta bort data. Allt detta hjälpte till att minimera risken för fel.
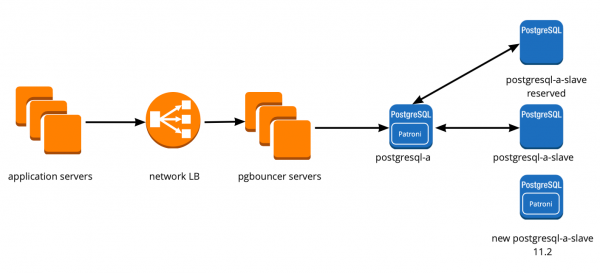
Vi startade om vår tjänst och allt fungerade som det skulle, användarna fortsatte sitt arbete, men vi märkte en onormalt hög belastning på Consul-servrarna.
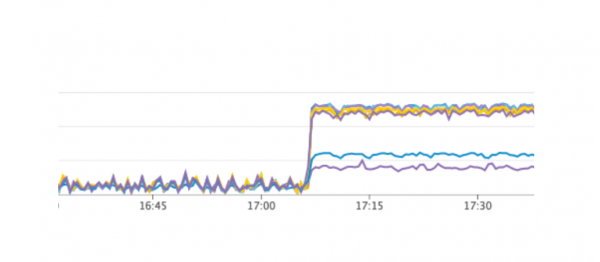
Varför såg vi inte detta i testmiljön? Detta problem illustrerar tydligt vikten av att följa principen Infrastructure as code och att utveckla hela infrastrukturen, från testmiljöer till produktionsmiljöer. Annars är det lätt att få sådana problem som vi fick. Vad hände? Consul kom först till produktion och senare till testmiljöerna, vilket resulterade i att versionen av Consul i testmiljöerna var högre än i produktion. Just i en av versionerna rättades en CPU-läckage när man arbetade med consul-template. Så vi uppdaterade helt enkelt Consul för att lösa problemet.
Starta om Patroni-klustret
Men vi fick ett nytt problem som vi inte ens misstänkte. Vid uppdateringen av Consul tar vi helt enkelt bort Consul-noden från klustret med kommandot consul leave → Patroni ansluter till en annan Consul-server → allting fungerar. Men när vi kom till den sista instansen av Consul-klustret och skickade kommando consul leave till den, startade alla Patroni-kluster om, och i loggarna såg vi följande felmeddelande:
FEL: get_cluster
Spår tillbaka (senaste anropet sist):
...
RetryFailedError: 'Överskred återförsöksfristen'
FEL: Fel vid kommunikation med DCS
<b>LOGG: databasystemet är avstängt</b>
Patroni-klustret kunde inte få information om sitt kluster och startade om.
För att hitta en lösning kontaktade vi författarna till Patroni genom en issue på GitHub. De föreslog förbättringar av våra konfigurationsfiler:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Vi lyckades reproducera problemet i testmiljön och testade dessa inställningar där, men tyvärr fungerade de inte.
Problemet är fortfarande olöst. Vi planerar att prova följande lösningar:
- Använda Consul-agent på varje instans i Patroni-klustret;
- Korrigera problemet i koden.
Vi förstår var felet uppstår: problemet ligger troligen i användningen av standardtimeouten, som inte åsidosätts via konfigurationsfilen. När den sista Consul-servern tas bort från klustret fryser hela Consul-klustret, vilket varar längre än en sekund, och därför kan Patroni inte få klustrets status och startar om hela klustret.
Lyckligtvis har vi inte stött på några fler fel.
Resultat av användningen av Patroni
Efter en framgångsrik start av Patroni lånade vi en extra replika i varje kluster. Nu finns det en form av kvorum i varje kluster: en ledare och två repliker, för säkerhets skull vid split-brain under omkoppling.
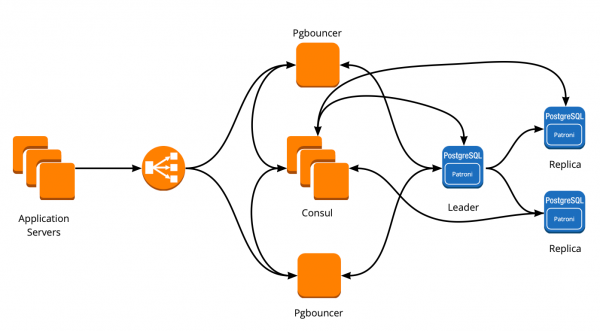
Patroni har fungerat på produktion i mer än tre månader. Under denna tid har det redan hjälpt oss. Nyligen dog ledaren för ett av klustren i AWS, automatisk failover utlöste, och användarna kunde fortsätta arbeta. Patroni uppfyllde sin huvuduppgift.
En liten sammanfattning av användningen av Patroni:
- Bekvämligheterna med att ändra konfigurationen. Det räcker att ändra konfigurationen på en instans så synkroniseras den över hela klustret. Om en omstart krävs för att tillämpa den nya konfigurationen, kommer Patroni att meddela detta. Patroni kan starta om hela klustret med ett enda kommando, vilket också är mycket bekvämt.
- Automatisk failover fungerar och har redan hjälpt oss.
- Uppgradering av PostgreSQL utan driftstopp för applikationen. Först måste replikerna uppgraderas till den nya versionen, sedan byta ledare i Patroni-klustret och uppgradera den gamla ledaren. Under detta sker nödvändig testning av den automatiska failovern.
Källa: habr.com
