

Introduktion
Det är dags att köpa en lagringslösning. Vilken ska man välja, vem ska man lyssna på? Leverantör A pratar om leverantör B, och så finns det integratör C som ger motsatt råd och rekommenderar leverantör D. I en sådan situation kan även en erfaren arkitekt för lagringssystem bli snurrig, särskilt med alla nya leverantörer och trender som SDS och hyperkonvergens.
Så hur ska man reda ut allt detta och inte hamna i kläm? Vi ( Anton Zhbankov och Evgeny Elizarov) ska försöka förklara detta på ett begripligt sätt.
Denna artikel sammanfaller på många sätt och är i praktiken en förlängning av "" när det gäller valet av lagringssystem och en översikt av lagringsteknologier. Vi kommer kort att gå igenom den allmänna teorin, men vi rekommenderar också att läsa den nämnda artikeln.
Varför
Det är ofta möjligt att observera hur en ny person kommer till ett forum eller en specialiserad chatt, som till exempel Storage Discussions, och ställer frågan: "jag får två alternativ för lagringslösningar – ABC SuperStorage S600 och XYZ HyperOcean 666v4, vad rekommenderar ni?"
Och så börjar folk jämföra olika specifika funktioner hos implementeringarna, som för en oinsatt person kan verka helt obegripliga.
Så den viktigaste och första frågan man måste ställa sig långt innan man börjar jämföra specifikationer i kommersiella erbjudanden är – VARFÖR? Vad behöver man denna lagringslösning för?
Svaret kommer att vara oväntat, och i sann Tony Robbins-stil – för att lagra data. Tack, kapten! Och ändå, ibland gräver vi så djupt ner i jämförelsen av detaljer att vi glömmer varför vi gör allt detta.
Så lagringssystemets uppgift är att lagra och ge tillgång till DATA med angiven prestanda. Det är just här vi börjar.
Data
Datatyp
Vilka uppgifter planerar vi att lagra? En mycket viktig fråga som kan utesluta många lagringssystem från övervägande. Till exempel, om lagring av videoinspelningar och foton planeras. Det kan genast utesluta system som är designade för att hantera slumpmässig åtkomst med små block, eller system med specifika funktioner för komprimering / deduplicering. Dessa kan vara utmärkta system, inget ont vill vi säga. Men i det här fallet kan deras styrkor å sin sida bli svagheter (video och foto kan inte komprimeras) eller helt enkelt öka kostnaden för systemet avsevärt.
Och vice versa, om den avsedda användningen är en belastad transaktionell databas, så kommer utmärkta strömmande system för multimedia som kan leverera gigabyte per sekund att vara ett dåligt val.
Datamängd
Hur mycket data planerar vi att lagra? Mängden växer alltid till kvalitet, det får man aldrig glömma, speciellt i vår tid av exponentiell datatillväxt. System av petabyteklass är inte längre ovanliga, men ju fler petabyte i volym, desto mer specifika blir systemen, och desto mindre kommer den vanliga funktionaliteten hos system med slumpmässig åtkomst i liten och medelstor volym att vara tillgänglig. Det beror helt enkelt på att bara statistikövervakning av blockåtkomst blir större än den tillgängliga mängden RAM-minne på kontrollerna. För att inte nämna komprimering / tiering. Anta att vi vill byta till en kraftfullare komprimeringsalgoritm och pressa 20 petabyte data. Hur lång tid skulle det ta: ett halvår, ett år?
Å andra sidan, varför göra en stor sak av det om vi bara behöver lagra och bearbeta 500 GB data? Endast 500. Konsument-SSD:er (med låg DWPD) av denna storlek kostar nästan ingenting. Varför bygga en fabrik med Fiber Channel och köpa en extern lagringslösning av hög kvalitet till priset av en järnvägsbro?
Vilken procentandel av den totala volymen är heta data? Hur ojämnt är belastningen över datavolymen? Här kan teknik för flerlagrad lagring eller Flash Cache vara mycket till hjälp om volymen av heta data är obetydlig i förhållande till det totala. Å andra sidan, vid en jämn belastning över hela volymen, som ofta förekommer i strömmande system (övervakning, vissa analyseringssystem), kommer sådana teknologier inte att tillföra något, utan bara öka kostnaden / komplexiteten i systemet.
IS
Den andra sidan av data är ett informationssystem som använder dessa data. IS har en uppsättning krav som är ärvda från data. Mer om IS finns i "Design av ett virtualiserat datacenter".
Krav på redundans / tillgänglighet
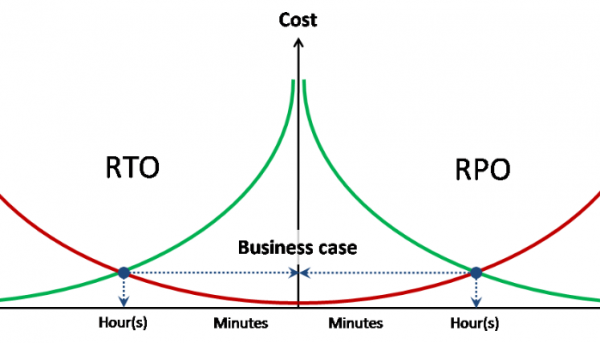
Krav på redundans / tillgänglighet för data är ärvda från det användande IS och uttrycks i tre siffror — RPO, RTO, tillgänglighet.
Tillgänglighet — andelen under en angiven tidsperiod under vilken data är tillgängliga för arbete med dem. Detta uttrycks vanligtvis i antal nior. Till exempel innebär två nior per år att tillgängligheten är 99%, eller att 95 timmar av oåtkomlighet per år är tillåtna. Tre nior — 9,5 timmar per år.
RPO / RTO är indikatorer som inte är sammanlagda, utan för varje incident (katastrof), i motsats till tillgänglighet.
RPO — mängden förlorade data vid en katastrof (i timmar). Till exempel, om säkerhetskopiering sker en gång om dagen, så RPO = 24 timmar. Det vill säga, vid en katastrof och total förlust av lagringssystem kan data motsvarande upp till 24 timmar (från den sista säkerhetskopieringen) förloras. Baserat på det angivna RPO för IS skrivs reglerna för säkerhetskopiering. Dessutom kan man utifrån RPO förstå hur mycket synkron eller asynkron replikering av data som behövs.
RTO — återställningstiden för tjänsten (åtkomst till data) efter en katastrof. Utifrån det angivna RTO-värdet kan vi förstå om en metrokluster behövs, eller om en enkelriktad replikering räcker. Om en flercontrollers lagringssystem i högklass behövs också.
Krav på prestanda
Trots att detta är en ganska uppenbar fråga, så är det just här som de flesta svårigheter uppstår. Beroende på om ni redan har någon infrastruktur eller inte, kommer vägarna för att samla in nödvändig statistik att byggas.
Du har redan en lagringslösning och letar efter en ersättning, eller vill köpa en till för att expandera. Här är det enkelt. Du förstår vilka tjänster du redan har och vilka du planerar att implementera inom en snar framtid. Baserat på de nuvarande tjänsterna har du möjlighet att samla statistik om prestanda. Bestäm det aktuella antalet IOPS och de nuvarande latenserna – vad är dessa värden och räcker de för dina behov? Detta kan göras både från lagringssystemet och från värdarna som är anslutna till det.
Det är viktigt att inte bara titta på den aktuella belastningen, utan att se över en viss period (helst en månad). Titta på vilka maximala toppar som förekommer under dagen, vilken belastning som skapas av säkerhetskopiering, osv. Om din lagringslösning eller programvara inte ger dig en komplett uppsättning av dessa uppgifter, kan du använda det gratis verktyget RRDtool, som kan arbeta med de flesta populära lagringslösningar och switchar och kan ge dig detaljerad statistik om prestanda. Det är också värt att se över belastningen på värdarna som arbetar med denna lagringslösning, samt på specifika virtuella maskiner eller vad som konkret arbetar på denna värd.
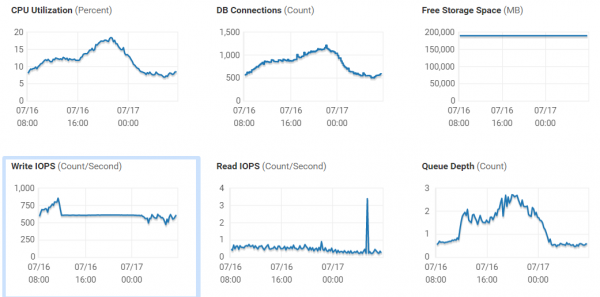
Det är värt att nämna separat att om latenserna på volymen och datalagringen som finns på denna volym skiljer sig ganska mycket, så bör du uppmärksamma din SAN-nätverk; det finns en stor chans att det finns problem med den, och innan du köper ett nytt system är det värt att ta itu med denna fråga, eftersom risken för att öka prestandan i det nuvarande systemet är mycket hög.
Du bygger infrastruktur från grunden, eller köper ett system för en ny tjänst vars belastningskrav du inte är bekant med. Här finns det flera alternativ: prata med kollegor på specialiserade resurser för att försöka ta reda på och förutsäga belastningen, vända dig till en integratör som har erfarenhet av att implementera sådana tjänster och som kan beräkna belastningen åt dig. Det tredje alternativet (vanligtvis det mest komplicerade, särskilt om det handlar om skräddarsydda eller sällsynta applikationer) är att försöka ta reda på prestandakrav från systemutvecklarna.
Och uppmärksamhet, den mest korrekta varianten ur ett praktiskt tillämpningsperspektiv är en pilot på den aktuella utrustningen, eller på utrustningen som tillhandahålls för test av leverantören/integratören.
Speciella krav
Speciella krav är allt som inte faller under krav på prestanda, tillgänglighet och funktionalitet för direkt databehandling och tillhandahållande.
Ett av de enklaste speciella kraven på lagringssystemet kan kallas "överförbara informationsbärare". Det blir omedelbart klart att detta lagringssystem måste inkludera ett bandbibliotek eller helt enkelt en streamer, där en säkerhetskopia lagras. Därefter skriver en särskilt utbildad person ut bandet och bär stolt det till ett särskilt kassaskåp.
Ett annat exempel på ett speciellt krav är ett skyddat stötbeständigt utförande.
Där
Den andra huvudkomponenten i valet av ett lagringssystem är information om VAR detta lagringssystem kommer att stå. Allt från geografi eller klimatförhållanden till personalen.
Beställaren
För vem planeras detta lagringssystem? Frågan har följande grunder:
Statlig beställare / kommersiell.
Den kommersiella beställaren har inga begränsningar och är inte ens skyldig att genomföra upphandlingar, förutom enligt sina egna interna regler.
Statliga beställaren är en annan sak. 44 FZ och andra finesser med upphandlingar och specifikationer som kan överklagas.
Beställare under sanktioner
Här är frågan mycket enkel — valet begränsas bara till de erbjudanden som är tillgängliga för denna beställare.
Interna regler / godkända leverantörer / modeller som får köpas
Frågan är också ytterst enkel, men det är viktigt att komma ihåg.
Var fysiskt
I denna del tar vi upp alla frågor om geografi, kommunikationskanaler och mikroklimat i platsen för installation.
Personal
Vem kommer att arbeta med detta lagringssystem? Det är minst lika viktigt som vad lagringssystemet faktiskt kan göra.
Hur lovande, fantastisk och imponerande lagringssystemet från leverantör A än må vara, är det nog meningslöst att installera det om personalen endast kan arbeta med leverantör B, och inga framtida inköp eller fortsatt samarbete med A planeras.
Och naturligtvis finns det den omvända sidan av frågan - hur tillgänglig är den utbildade personalen direkt i företaget och potentiellt på arbetsmarknaden i denna geografiska plats. För regioner kan det ha stor betydelse att välja lagringssystem med enkla gränssnitt eller möjlighet för fjärrcentraliserad hantering. Annars kan det i något skede bli plågsamt. Internet är fullt av historier om hur en nyanställd, en nyexaminerad student, konfigurerade något så att hela kontoret föll.
Miljö
Och naturligtvis är en viktig fråga - i vilken miljö kommer detta lagringssystem att fungera.
- Vad gäller elförsörjning / kylning?
- Vilken typ av anslutning
- Var kommer det att installeras
- Och så vidare.
Ofta anses dessa frågor som självklara och tas inte riktigt i beaktande, men ibland kan det just vara dessa som kan vända allt på huvudet.
Vad
leverantör
Vid denna tidpunkt (mitt 2019) kan den ryska marknaden för lagringssystem delas in i fem kategorier:
- Högsta divisionen - erkända företag med ett brett utbud från de enklaste diskställ till hi-end (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Andra divisionen - företag med begränsat utbud, nischaktörer, seriösa SDS-leverantörer eller nykomlingar (Fujitsu, Datacore, Infinidat, Huawei, Pure etc.)
- Tredje divisionen - nischlösningar i low-end segmentet, billiga SDS, handgjorda produkter på ceph och andra öppna projekt (Infortrend, Starwind etc.)
- SOHO-segmentet - små och mycket små lagringssystem för hem/små kontor (Synology, QNAP etc.)
- Importerat lagringssystem - här ingår både first division-hårdvara med omklistrade etiketter och sällsynta representanter från den andra (RAIDIX, vi ger dem en chans för den andra), men huvudsakligen är detta den tredje divisionen (Aerodisk, Baum, Depo etc.)
Indelningen är ganska villkorlig och betyder inte alls att tredje eller SOHO-segmentet är dåligt och inte kan användas. I specifika projekt med tydligt definierade datamängder och lastprofiler kan de fungera mycket bra, långt över första divisionen i förhållande till pris/kvalitet. Det är viktigt att först bestämma målen, framtida tillväxt, nödvändig funktionalitet - och då kommer Synology att tjäna dig troget, och ditt hår kommer att bli mjukt och silkeslent.
En av de viktiga faktorerna vid val av leverantör är den aktuella miljön. Hur många och vilka lagringssystem har ni redan, och vilka lagringssystem kan ingenjörerna arbeta med? Behöver ni ytterligare en leverantör, en ytterligare kontaktpunkt, kommer ni att migrera hela belastningen gradvis från leverantör A till leverantör B?
Man bör inte skapa fler entiteter än nödvändigt.
iSCSI / FC / Fil
Det finns ingen enhetlig åsikt bland ingenjörerna angående åtkomstprotokoll, och diskussionerna liknar mer teologiska debatter än tekniska. Men generellt kan följande punkter noteras:
FCoE är snarare död än levande.
FC vs iSCSI. En av de viktigaste fördelarna med FC 2019 jämfört med IP-lagring, en dedikerad fabrik för datatillgång, uppvägs av ett dedikerat IP-nätverk. Det finns inga globala fördelar med FC jämfört med IP-nätverk och IP kan användas för att bygga lagringssystem med vilken belastning som helst, till och med system för tunga databaser för stora bankers kärnsystem. Å andra sidan har FC:s död profeterats i flera år, men något har konstant hindrat det. Idag utvecklar till exempel vissa aktörer på marknaden aktivt standarden NVMeoF. Om den kommer att dela öde med FCoE — tiden får utvisa.
Filåtkomst är inte heller något att förbise. NFS / CIFS presterar utmärkt i produktionsmiljöer och, om de är rätt utformade, har de inte fler klagomål än blockprotokoll.
Hybrid / All Flash Array
Klassiska lagringssystem kommer i två typer:
- AFA (All Flash Array) — system som är optimerade för användning av SSD.
- Hybrid — som tillåter användning av både HDD och SSD eller en kombination av dem.
Den största skillnaden mellan dem är de stödda lagringsteknologierna för effektivitet och den maximala prestandanivån (höga IOPS-värden och låg latens). Både dessa system (i de flesta av sina modeller, med undantag för lågprissegmentet) kan fungera både som blockenheter och filsystem. Vilken nivå systemet har avgör både det stödda funktionaliteten och hos de lägre modellerna är det oftast nedskalat till en minimal nivå. Detta är viktigt att tänka på när du granskar specifikationerna för en specifik modell, och inte bara möjligheterna för hela sortimentet som helhet. Naturligtvis påverkas även systemets tekniska specifikationer som processor, minnesvolym, cache, antal och typer av portar etc. Ur styrelsesynpunkt, skiljer sig AFA från hybrid (disk) system endast i hur mekanismer för arbete med SSD-enheter implementeras, och även om du använder SSD i ett hybrid system betyder det inte att du kommer att kunna uppnå prestandanivåer på samma nivå som en AFA-enhet. Dessutom är inline-mekanismer för effektiv lagring i hybrid system oftast avstängda, och att aktivera dem leder till en minskning av prestandan.
Specialiserade lagringssystem
Förutom allmänt förekommande lagringssystem som främst är inriktade på snabb databehandling, finns det specialiserade lagringssystem med centrala principer som är grundligt annorlunda än de vanliga (låg latens, många IOPS):
Media.
Dessa system är avsedda för lagring och bearbetning av mediefiler som kännetecknas av stor storlek. Därför blir latensen praktiskt taget oviktig, och fokus flyttas till förmågan att skicka och ta emot data med hög bandbredd i många parallella strömmar.
Deduplikationslagringssystem för säkerhetskopior.
Eftersom säkerhetskopior vanligtvis sällan liknar varandra (en genomsnittlig säkerhetskopia skiljer sig från gårdagens med 1-2 %), packar denna klass av system mycket effektivt de data som lagras på dem inom en relativt liten mängd fysiska enheter. I vissa fall kan komprimeringsförhållanden uppnå 200 till 1.
Objektlagringssystem.
I dessa lagringssystem finns det inga vanliga volymer med blockåtkomst eller filandelar; de påminner mest om en enorm databas. Åtkomst till ett objekt som lagras i ett sådant system sker via en unik identifierare eller metadata (till exempel alla objekt i JPEG-format, med ett skapelsedatum mellan XX-XX-XXXX och YY-YY-YYYY).
Compliance-system.
De är inte så vanliga i Ryssland idag, men det är värt att nämna dem. Syftet med sådana lagringssystem är att garantera datalagring för att uppfylla säkerhetspolicyer eller regulatoriska krav. I vissa system (till exempel EMC Centera) har en funktion för att förhindra radering av data implementerats — så snart nyckeln vrids och systemet går in i detta läge, kan varken administratören eller någon annan fysiskt ta bort redan inspelade data.
Egendomliga teknologier
Flash-cache
Flash-cache är ett gemensamt namn för alla egendomliga teknologier som använder flashminne som andra nivåns cache. Vid användning av flash-cache beräknas lagringssystemet vanligtvis för att hantera den etablerade belastningen från magnetiska diskar, medan den maximala belastningen hanteras av cachen.
Vid detta tillfälle är det nödvändigt att förstå belastningsprofilen och graden av lokalisering av åtkomst till lagringens volymblock. Flash-cache är en teknologi för belastningar med hög lokaliseringsgrad av förfrågningar, och är praktiskt taget oanvändbar för jämnt belastade volymer (som till exempel för analytiska system).
Två implementationer av flash-cache finns på marknaden:
- Read Only. I detta fall cachas endast data för läsning, medan skrivning sker direkt på diskarna. Vissa tillverkare, som exempelvis NetApp, anser att skrivningen på deras lagringssystem sker optimalt ändå, och cachen inte tillför något.
- Read/Write. Inte bara läsning utan även skrivning cachas, vilket tillåter buffring av flödet och minskar effekten av RAID-straffet, vilket i sin tur ökar den totala prestandan för lagringssystem med en mindre optimal skrivmekanism.
Tiering
Flerlagerslagring (tiering) — en teknik som kombinerar nivåer med olika prestanda i en gemensam diskpool, såsom SSD och HDD. Vid en tydlig ojämnhet i åtkomsten till datablokkar kan systemet automatiskt balansera datablokkar genom att flytta belastade till en högpresterande nivå, medan kalla blåsor istället flyttas till en långsammare.
Hybrida system i låg och medelklass använder fler-nivå lagring med databehandling mellan nivåerna enligt schema. I detta fall är blockstorleken för fler-nivå lagring hos de bästa modellerna 256 MB. Dessa egenskaper gör det omöjligt att betrakta teknologin för fler-nivå lagring som en teknologi för att öka prestanda, som många felaktigt tror. Fler-nivå lagring i låg- och medelklassystem är en teknik för att optimera lagringskostnader för system med uttalad ojämn belastning.
Snapshot
Oavsett hur mycket vi pratar om tillförlitligheten hos lagringssystem, finns det många sätt att förlora data som inte är beroende av hårdvaruproblem. Det kan vara virus, hackare eller vilken form av oavsiktlig radering/korruption av data som helst. Av den anledningen är säkerhetskopiering av produktionsdata en oumbärlig del av en ingenjörs arbete.
En snapshot är en bild av en volym vid en specifik tidpunkt. När vi arbetar med de flesta system, såsom virtualisering, databaser osv., behöver vi ta en sådan bild som vi kommer att kopiera data från till säkerhetskopian, samtidigt som våra informationssystem kan fortsätta arbeta med den volymen. Men man bör komma ihåg att inte alla snapshots är lika användbara. Olika leverantörer har olika metoder för att skapa snapshots, relaterade till deras arkitektur.
CoW (Copy-On-Write). Vid försöket att skriva en datablokk kopieras dess ursprungliga innehåll till ett speciellt område, varefter skrivningen genomförs normalt. På så sätt förhindras skador på data inom snapshoten. Naturligtvis orsakar alla dessa "parasitiska" manipulationer med data en extra belastning på lagringssystemet, och av denna anledning rekommenderar leverantörer med sådan implementering att inte använda mer än ett dussin snapshots och att inte använda dem alls på högbelastade volymer.
RoW (Redirect-on-Write). I detta fall fryses den ursprungliga volymen naturligt, och vid försök att skriva en datablokk skriver lagringssystemet data till ett speciellt område i det lediga utrymmet, vilket ändrar placeringen av denna block i metadata-tabellen. Detta minskar antalet skrivoperationer, vilket i slutändan neutraliserar prestandafall och tar bort begränsningar på snapshots och deras antal.
Snapshots finns också i två typer i förhållande till applikationer:
Application consistent. Vid skapandet av snapshoten kontaktar lagringssystemet agenten i konsumentens operativsystem, som tvingar diskcacheminnen att skrivas ut från minnet till disken och får applikationen att göra detsamma. I detta fall kommer data som återställs från snapshoten att vara konsekventa.
Crash consistentI det här fallet sker inget liknande och snapshots skapas som de är. Vid återställning från en sådan snapshot är situationen densamma som om strömmen plötsligt skulle stängas av, och viss data som är kvar i cacheminnet och inte hunnit nå disken kan gå förlorad. Sådana snapshots är enklare att genomföra och påverkar inte prestandan hos applikationerna, men är mindre pålitliga.
Varför behövs snapshots i datalagringssystem?
- Agentlös säkerhetskopiering direkt från lagringssystemet
- Skapande av testmiljöer baserade på verkliga data
- I fallet med filbaserade lagringssystem kan de användas för att skapa VDI-miljöer genom att använda snapshots från lagringssystemet istället för hypervisorn.
- Säkerställande av låga RPO genom att skapa snapshots enligt ett schema med en frekvens som är betydligt högre än frekvensen för säkerhetskopiering.
Kloning
Kloning av volym — fungerar på ett liknande sätt som snapshots, men syftar inte bara till att läsa data, utan för att arbeta med det på heltid. Vi kan erhålla en exakt kopia av vår volym med all data på den, utan att göra en fysisk kopia, vilket sparar utrymme. Vanligtvis används volymkloning antingen i Test & Dev eller om du vill kontrollera funktionaliteten hos vissa uppdateringar på ditt IT-system. Kloning gör det möjligt att göra detta så snabbt och kostnadseffektivt som möjligt när det gäller diskresurser, eftersom endast de ändrade datablokkerna kommer att skrivas.
Replikering / journalföring
Replikering — en mekanism för att skapa en kopia av data på ett annat fysiskt lagringssystem. Vanligtvis finns det en egen teknik hos varje leverantör som fungerar bara inom sin egen produktlinje. Men det finns också tredjepartslösningar, inklusive de som arbetar på hypervisornivå, som till exempel VMware vSphere Replication.
Funktionaliteten hos de proprietära teknikerna och bekvämligheten vid deras användning överträffar vanligtvis de universella, men de är inte tillämpbara när det till exempel behövs skapa en replik från NetApp till HP MSA.
Replikering delas in i två underkategorier:
Synkron. Vid synkron replikering skickas skrivoperationen omedelbart till den andra lagringssystemet och bekräftas inte förrän den fjärran lagringssystemet bekräftar det. Detta ökar åtkomstfördröjningen, men vi får en exakt spegelbild av data. Det vill säga RPO = 0 vid förlust av det primära lagringssystemet.
Asynkron. Skrivoperationer utförs endast på det primära lagringssystemet och bekräftas omedelbart, samtidigt som de samlas i en buffert för paketöverföring till det fjärrlagringssystemet. Denna typ av replikering är relevant för mindre värdefulla data eller för kanaler med låg överföringskapacitet eller hög fördröjning (typiskt för avstånd över 100 km). Därmed är RPO = frekvensen för paketöverföring.
Ofta finns det tillsammans med replikeringen en mekanism för journalföring av skrivoperationer. I detta fall avsätts ett särskilt område för journalföring och skrivoperationer bevaras med viss tidsdjup eller begränsat av journalens storlek. För vissa proprietära teknologier, som till exempel EMC RecoverPoint, finns det integration med systemprogramvara som gör det möjligt att koppla specifika bokmärken till en viss post i journalen. Tack vare detta är det möjligt att återställa volymens tillstånd (eller skapa en klon) inte bara till den 23 april klockan 11:59:13.013, utan till en tidpunkt som föregick “DROP ALL TABLES; COMMIT”.
Metrokluster
Metrokluster är en teknologi som möjliggör att skapa en tvåvägs synkron replikering mellan två lagringssystem på ett sådant sätt att denna par ser ut som ett enda lagringssystem. Används för att skapa kluster med geografiskt spridda noder på metroavstånd (mindre än 100 km).
I exemplet på användning i en virtualiseringsmiljö tillåter metrokluster att skapa en datastor med virtuella maskiner, som är skrivbar omedelbart från två datacenter. I detta fall skapas ett kluster på hypervisor-nivå som består av värdar i olika fysiska datacenter, kopplade till denna datastor. Detta möjliggör följande:
- Full automation of the recovery process after the death of one of the data centers. Without any additional means, all VMs that were operating in the deceased data center will be automatically restarted in the remaining one. RTO = high availability cluster timeout (15 seconds for VMware) + time for OS boot and service startup.
- Disaster avoidance or, in Swedish, undvikande av katastrofer. If scheduled power work is planned in data center 1, we can migrate all critical loads to data center 2 non-stop in advance, before the work begins.
Virtualisering
Virtualization of storage systems is technically the use of volumes from another storage system as disks. A storage system virtualizer can simply pass through another's volume to the consumer as its own, while simultaneously mirroring it to another storage system, or even create a RAID from external volumes.
Classic representatives in the field of storage virtualization are EMC VPLEX and IBM SVC. And of course, storage systems with virtualization functionality — NetApp, Hitachi, IBM / Lenovo Storwize.
Why might it be needed?
- Mirroring at the storage system level. A mirror is created between volumes, with one half possibly on HP 3Par and the other on NetApp. And the virtualizer from EMC.
- Data migration with minimal downtime between storage systems from different manufacturers. Suppose that data needs to be migrated from an old 3Par that is being decommissioned to a new Dell. In this case, consumers are disconnected from the 3Par, the volumes are passed under VPLEX and re-presented to the consumers. Since no bits on the volume have changed, work continues. In the background, the process of mirroring the volume to the new Dell begins, and upon completion, the mirror is broken and the 3Par is disconnected.
- Organization of metroclusters.
Compression / deduplication
Compression and deduplication are technologies that allow you to save disk space on your storage system. It should be noted right away that not all data is suitable for compression and/or deduplication in general, while some types of data compress and deduplicate better, while others do not.
Compression and deduplication come in 2 types:
Inline — komprimering och deduplicering av datablokkar sker innan dessa data skrivs till disken. På så sätt beräknar systemet bara hashvärdet för blocket och jämför det med tabellen över redan existerande. För det första går detta snabbare än en direkt skrivning till disken, för det andra sparar vi på diskutrymme.
Post — när dessa operationer utförs på redan skrivna data som finns på diskarna. Därför skrivs data först till disken, och först sedan beräknas hashvärdet och överflödiga block tas bort för att frigöra diskinventarier.
Det bör nämnas att de flesta leverantörer använder båda metoderna, vilket gör det möjligt att optimera dessa processer och därmed öka deras effektivitet. Många leverantörer av lagringssystem har verktyg som gör det möjligt att analysera dina datamängder. Dessa verktyg fungerar efter samma logik som implementerats i lagringssystemet, därför kommer den uppskattade effektiviteten att stämma överens. Glöm inte att många leverantörer har program för att garantera effektivitet, som lovar att nivåerna inte kommer att vara lägre än de som angivits för specifika (eller alla) typer av data. Och man ska inte förakta detta program, eftersom man genom att designa systemet efter sina behov, med hänsyn till den effektivitetsfaktor som gäller för just detta system, kan spara på volymen. Det är också värt att notera att dessa program är avsedda för AFA-system, men genom att köpa en mindre mängd SSD jämfört med HDD i klassiska system, kan detta sänka kostnaderna, och även om man inte når samma kostnadsnivå som på disk systemet, kan man komma ganska nära.
Modell
Och här kommer vi till den rätta frågan.
“Jag har fått två alternativ för lagringssystem — ABC SuperStorage S600 och XYZ HyperOcean 666v4, vad rekommenderar ni?”
Förvandlas till “Jag har fått två alternativ för lagringssystem — ABC SuperStorage S600 och XYZ HyperOcean 666v4, vad rekommenderar ni?
Målbelastning blandade virtuella maskiner VMware för produktions/test/utveckling. Test = produktion. 150 TB per styck med en toppprestanda på 80 000 IOPS med 8kb block 50% slumpmässig åtkomst 80/20 läsning-skrivning. 300 TB för utveckling, där räcker 50 000 IOPS, 80 slumpmässig, 80 skrivning.
Produktion förväntas i metroklyngan RPO = 15 minuter RTO = 1 timme, utveckling i asynkron replikering RPO = 3 timmar, test på en plats.
Det skulle bli 50 TB databaser, det skulle vara bra för dem med loggning.
Vi har Dell-servrar överallt, de gamla Hitachi-lagringssystemen klarar knappt av det, vi planerar en ökning av belastningen med 50% i både volym och prestanda.
Som man säger, i en välformulerad fråga finns 80% av svaret.
Ytterligare information
Vad rekommenderar författarna att bekanta sig med mer?
Böcker
- Oliefer och Olifer "Datakommunikationsnät". Boken hjälper till att systematisera och kanske bättre förstå hur dataöverföringsmiljön för IP / Ethernet lagringssystem fungerar.
- "EMC Information Storage and Management". En utmärkt bok om grunderna kring lagringssystem, varför, hur och varför.
Forum och chattar
Allmänna rekommendationer
Priser
Nu, vad gäller priser — på lagringssystem är priserna om de dyker upp, oftast listpriser, från vilka varje kund får en individuell rabatt. Rabattens storlek beror på många parametrar, så att förutsäga vilket slutpris just ert företag får, utan att fråga distributören, är helt enkelt omöjligt. Men samtidigt har det på sistone blivit vanligt att low-end modeller dyker upp i vanliga datorbutiker, som till exempel eller . Där kan man direkt köpa det system man är intresserad av till ett fast pris, precis som andra datorhårdvaror.
Men jag vill genast påpeka att en direkt jämförelse av TB/$ inte är korrekt. Om man ser på det från den synvinkeln skulle den billigaste lösningen vara en enkel JBOD + server, vilket inte ger den flexibilitet eller pålitlighet som ett fullt, tvåkontrollerande lagringssystem erbjuder. Detta betyder inte att JBOD är helt värdelöst, utan man måste återigen förstå mycket tydligt — hur och för vilka ändamål ni kommer att använda denna lösning. Man hör ofta att det inte finns något som kan gå sönder i JBOD, där finns ju bara ett backplane. Men även backplanes kan sluta fungera. Allt går sönder förr eller senare.
Sammanfattningsvis
Man bör jämföra system med varandra inte bara utifrån pris eller prestanda, utan utifrån en helhet av alla parametrar.
Köp endast HDD om du är säker på att du behöver dem. För låga belastningar och osammanhängande datatyper, överväg istället lagringslösningar med SSD-garantiprogram, som nu finns hos de flesta leverantörer (och de fungerar faktiskt, även i Sverige), men allt beror på de program och data som kommer att finnas i denna lagringslösning.
Jaga inte efter låga priser. Ibland döljer sig många obehagliga överraskningar under dessa, ett exempel som Evgenij Elizarov beskrivit i sina artiklar om . Och slutligen kan denna billighet kosta dig mer. Kom ihåg - "den som är snål betalar två gånger".
Källa: habr.com
