

Hur kan man öka antalet databasfrågor med tio gånger utan att byta till en kraftfullare server och ändå behålla systemets funktionalitet? Jag ska berätta hur vi kämpade mot minskad prestanda i vår databas, hur vi optimerade SQL-frågor för att betjäna så många användare som möjligt utan att öka kostnaderna för beräkningsresurser.
Jag skapar en tjänst för hantering av affärsprocesser för byggföretag. Cirka 3 000 företag arbetar med oss. Mer än 10 000 personer arbetar varje dag med vårt system i 4-10 timmar. Det löser olika uppgifter inom planering, avisering, varning, validering… Vi använder PostgreSQL 9.6. I databasen har vi cirka 300 tabeller och varje dag får vi upp till 200 miljoner frågor (10 000 olika). I genomsnitt har vi 3-4 000 frågor per sekund, under de mest aktiva stunderna över 10 000 frågor per sekund. Majoriteten av frågorna är OLAP. Tillägg, modifieringar och borttagningar är mycket färre, så OLTP-belastningen är relativt liten. Jag gav dessa siffror så att ni kan bedöma omfattningen av vårt projekt och förstå hur vår erfarenhet kan vara användbar för er.
Första bilden. Lyrisk
När vi började utveckla, tänkte vi inte särskilt mycket på vilken belastning som skulle ligga på databasen och vad vi skulle göra om servern slutade fungera. Vid utformningen av databasen följde vi allmänna rekommendationer och försökte undvika att skjuta oss själva i foten, men längre än så gick vi inte i råd som "använd inte mönstret Vi gick inte. Vi designade utifrån normaliseringsprinciperna för att undvika dataduplicering och brydde oss inte om att påskynda vissa frågor. När de första användarna kom, stötte vi på prestandaproblem. Som vanligt var vi helt oförberedda för detta. De första problemen var enkla. I allmänhet löstes allt genom att lägga till en ny index. Men det kom en tid då enkla lappar slutade fungera. När vi insåg att vi saknade erfarenhet och att det blev allt svårare att förstå vad problemen berodde på, anlitade vi specialister som hjälpte oss att korrekt konfigurera servern, ansluta övervakning, och visade oss vart vi skulle titta för att få .
Andra bilden. Statistik
Vi har ungefär 10 000 olika förfrågningar som körs på vår databas varje dag. Av dessa 10 000 finns det stora förfrågningar som körs 2-3 miljoner gånger med en genomsnittlig körningstid på 0,1-0,3 ms, och så finns det förfrågningar med en genomsnittlig körningstid på 30 sekunder som anropas 100 gånger om dagen.
Det var inte möjligt att optimera alla 10 000 förfrågningar, så vi beslutade att ta reda på hur vi skulle rikta våra insatser för att korrekt öka databasens prestanda. Efter flera iterationer började vi dela upp förfrågningarna i typer.
TOP-förfrågningar
Dessa är de tyngsta förfrågningarna som tar mest tid (total tid). Det är förfrågningar som antingen anropas mycket ofta eller som tar mycket lång tid att genomföra (långa och frekventa förfrågningar har redan optimerats under de första iterationerna i jakten på hastighet). Totalt spenderar servern mest tid på att exekvera dem. Det är också viktigt att separera toppförfrågningarna efter total exekveringstid och separat efter IO-tid. Sätten att optimera sådana förfrågningar är något olika.
Det är vanlig praxis för alla företag att arbeta med TOP-förfrågningarna. De är få, och även optimering av en enda förfrågan kan frigöra 5-10% av resurserna. Men ju mer projektet "växer", desto mer okomplicerad blir optimeringen av TOP-förfrågningarna. Alla enkla metoder är redan utförda, och den mest "tunga" förfrågan tar "bara" 3-5% av resurserna. Om TOP-förfrågningarna totalt tar mindre än 30-40% av tiden, har du förmodligen redan ansträngt dig för att de ska fungera snabbt, och det är dags att gå vidare till optimering av förfrågningar i nästa grupp.
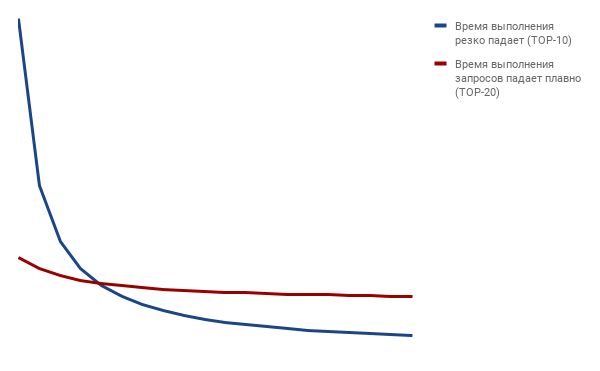
Frågan kvarstår: hur många toppförfrågningar ska inkluderas i den här gruppen? Jag brukar ta minst 10, men inte fler än 20. Jag försöker se till att tiden för den första och sista i TOP-gruppen inte skiljer sig mer än 10 gånger. Så om körningstiden för förfrågningarna faller kraftigt från plats 1 till 10, så tar jag TOP-10; om nedgången är mer gradvis, ökar jag gruppens storlek till 15 eller 20.
Medel (medium)
Detta är alla förfrågningar som kommer direkt efter TOP, med undantag för de senaste 5-10%. Vanligtvis ligger möjligheten att avsevärt öka serverns prestanda i optimeringen av just dessa förfrågningar. Dessa förfrågningar kan utgöra upp till 80%. Men även om deras andel har överskridit 50%, betyder det att det är dags att titta noggrannare på dem.
Svansen (tail)
Som nämnts, dessa förfrågningar ligger i slutet och tar upp 5-10 % av tiden. Man kan glömma dem, endast om man inte använder automatiska analysverktyg för förfrågningar, då kan deras optimering också göras billigt.
Hur bedömer man varje grupp?
Jag använder en SQL-fråga som hjälper till att göra en sådan bedömning för PostgreSQL (jag är säker på att man kan skriva en liknande fråga för många andra databashanteringssystem).
SQL-fråga för att bedöma storleken på TOP-MEDIUM-TAIL grupper
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) AS sum_tail
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800 THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
Frågeresultatet består av tre kolumner, var och en innehåller procentandelen av tiden som går åt till att behandla förfrågningar från denna grupp. Inom frågan finns två siffror (i mitt fall är det 20 och 800) som skiljer förfrågningar från en grupp till en annan.
Så här relaterar andelarna av förfrågningar vid början av optimeringsarbetet och nu.
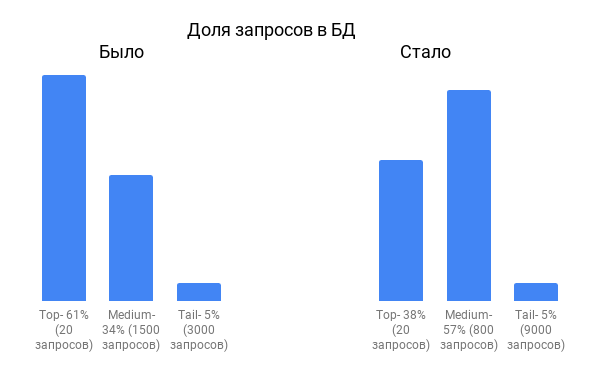
Diagrammet visar att andelen TOP-förfrågningar har minskat kraftigt, medan "medel" har ökat.
Till en början inkluderade TOP-förfrågningar uppenbara misstag. Med tiden försvann barnsjukdomarna, andelen TOP-förfrågningar minskade, och det krävdes allt mer ansträngning för att snabba upp de tunga förfrågningarna.
För att få texten av förfrågningarna använder vi följande fråga
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Här är en lista över de mest använda metoderna som hjälpte oss att snabba upp TOP-förfrågningar:
- Omdesign av systemet, till exempel omarbetning av logiken för aviseringar till en meddelandebroker istället för periodiska förfrågningar till databasen.
- Lägg till eller ändra index.
- Omarbeta ORM-förfrågningar till ren SQL.
- Omarbeta logiken för lazy laddning av data.
- Caching genom denormalisering av data. Till exempel har vi en koppling mellan tabellerna Leverans -> Faktura -> Förfrågning -> Ansökan. Det vill säga varje leverans är kopplad till en ansökan genom andra tabeller. För att inte koppla alla tabeller i varje förfrågning duplicerade vi kopplingen till ansökan i tabellen Leverans.
- Caching av statiska tabeller med referenser och sällan förändrade tabeller i programmets minne.
Ibland krävde förändringar en betydande redesign, men gav en avlastning på 5-10% av systemet och var berättigade. Med tiden blev vinsten allt mindre och redesignen blev allt mer omfattande.
Då uppmärksammade vi den andra gruppen av förfrågningar - gruppen av medelstora. Det fanns betydligt fler förfrågningar i den och det verkade som om en analys av hela gruppen skulle ta väldigt mycket tid. Men de flesta förfrågningarna visade sig vara väldigt enkla att optimera, och många problem återkom i olika varianter. Här är exempel på några typiska optimeringar som vi tillämpade på tiotals liknande förfrågningar och varje grupp av optimerade förfrågningar avlastade databasen med 3-5%.
- Istället för att kontrollera förekomsten av poster med COUNT och full skanning av tabellen började vi använda EXISTS.
- Vi avskaffade DISTINCT (det finns ingen allmän lösning, men ibland kan man enkelt bli av med det och snabba upp förfrågan 10-100 gånger).
Till exempel, istället för en förfrågan för att hämta alla förare från en stor leveransdatabas (DELIVERY)
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
gjorde vi en förfrågan mot en jämförelsevis liten tabell PERSON
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Det verkade som om vi använde en korrelerad subfråga, men den ger en snabbare körning på mer än 10 gånger.
- I många fall avstod vi helt från COUNT och
- istället för
UPPER(s) LIKE JOHN%VPS KVM.
s ILIKE "John%"
Varje specifik förfrågan lyckades vi på vissa sätt accelerera med 3-1000 gånger. Trots de imponerande resultaten, trodde vi först att det inte fanns något syfte med att optimera en förfrågan som utförs på 10 ms, som ligger i den tredje hundradet av de tyngsta förfrågningarna och som totalt sett bara utgör bråkdelar av procenten av databassbelastningen. Men genom att tillämpa samma recept på en grupp av liknande förfrågningar återhämtade vi flera procent. För att slippa spendera tid på manuell granskning av alla hundratals förfrågningar skrev vi några enkla skript som med hjälp av reguljära uttryck identifierade liknande förfrågningar. Slutligen gjorde den automatiska sökningen efter grupper av förfrågningar att vi ytterligare kunde förbättra vår prestanda med blygsamma insatser.
Resultatet är att vi redan har arbetat med samma hårdvara i tre år. Den genomsnittliga belastningen ligger runt 30%, och under toppar går den upp till 70%. Antalet förfrågningar och användare har ökat ungefär tio gånger. Och allt detta tack vare vårt ständiga övervakande av dessa grupper av förfrågningar TOP-MEDIUM. Så snart en ny förfrågan dyker upp i TOP-gruppen analyserar vi den genast och försöker snabbare. MEDIUM-gruppen granskas en gång i veckan med hjälp av skript för förfrågningsanalys. Om vi hittar nya förfrågningar som vi redan vet hur vi ska optimera, ändrar vi dem snabbt. Ibland hittar vi nya sätt att optimera som kan tillämpas direkt på flera förfrågningar.
Enligt våra prognoser kan den nuvarande servern hantera en ökning av antalet användare med ytterligare 3-5 gånger. Men vi har också ett ess i rockärmen - vi har fortfarande inte flyttat SELECT-förfrågningarna till spegeln, som rekommenderas. Men vi gör inte det medvetet, eftersom vi vill först helt utnyttja möjligheterna för "smart" optimering innan vi sätter in "tyngre artilleri".
En kritisk granskning av det utförda arbetet kan föreslå att man använder vertikal skalning. Att köpa en kraftfullare server istället för att låta specialister slösa tid. En server kan kosta ganska lite, särskilt eftersom våra gränser för vertikal skalning fortfarande inte har utnyttjats. Men antalet förfrågningar har ökat tio gånger. Under åren har systemets funktionalitet ökat och nu finns det fler typer av förfrågningar. Den funktionalitet som fanns, utförs tack vare cachen med färre, men mer effektiva förfrågningar. Det betyder att vi kan multiplicera med fem för att få den verkliga hastighetsökningen. Så enligt de mest blygsamma beräkningarna kan man säga att hastighetsökningen har varit 50 gånger eller mer. Att vertikalt uppgradera servern 50 gånger skulle kosta mer. Särskilt med tanke på att en gång utförd optimering fungerar hela tiden, medan fakturan för den hyrda servern kommer varje månad.
Källa: habr.com
