

Obs. övers.: Vi presenterar tekniska detaljer om orsaken till det senaste driftstoppet hos molntjänsten som drivs av skaparna av Grafana. Detta är ett klassiskt exempel på hur en ny och, till synes, oerhört nyttig funktion, avsedd att förbättra infrastrukturen… kan orsaka problem om man inte tar hänsyn till de många nyanser som påverkar dess användning i produktion. Det är fantastiskt när sådana här material dyker upp som gör att man kan lära sig inte bara av sina egna misstag. Detaljer finns i översättningen av denna text från vice VD för produkt på Grafana Labs.
Fredagen den 19 juli slutade tjänsten Hosted Prometheus i Grafana Cloud att fungera i ungefär 30 minuter. Jag ber om ursäkt till alla kunder som drabbades av avbrottet. Vårt mål är att tillhandahålla de verktyg som behövs för övervakning, och vi förstår att deras otillgänglighet försvårar er vardag. Vi tar denna incident på stort allvar. I denna notis förklaras vad som hände, hur vi reagerade och vad vi gör för att förhindra att detta händer igen.
Bakgrund
Grafana Cloud Hosted Prometheus-tjänsten är baserad på — CNCF-projektet för att skapa en horisontellt skalbar, hög tillgänglighet, multitenant-tjänst för Prometheus. Cortex-arkitekturen består av en uppsättning separata mikroservicer, var och en med sin egen funktion: replikering, lagring, förfrågningar osv. Cortex utvecklas aktivt, nya funktioner tillkommer ständigt och prestandan förbättras. Vi distribuerar regelbundet nya versioner av Cortex till kluster så att kunderna kan dra nytta av dessa funktioner - tack och lov kan Cortex uppdateras utan driftstopp.
För uppdateringar utan driftstopp kräver tjänsten Ingester i Cortex en extra Ingester-replik under uppdateringsprocessen. (Obs. övers.: — en grundläggande komponent i Cortex. Dess uppgift är att samla in en konstant ström av prover, gruppera dem i chunkar för Prometheus och spara dem i databaser som DynamoDB, BigTable eller Cassandra. Det gör det möjligt för gamla Ingester att skicka aktuella data till nya Ingester. Det är värt att notera att Ingester är resurskrävande. För deras drift behövs 4 kärnor och 15 GB minne per pod, vilket innebär 25% av CPU-kraften och minnet för den grundläggande maskinen i våra Kubernetes-kluster. Generellt har vi vanligtvis mycket mer oanvända resurser i klustret än 4 kärnor och 15 GB minne, så vi kan enkelt köra dessa extra Ingester under uppdateringar.
Men det händer ofta att det under normala driftförhållanden inte finns några 25% oanvända resurser på någon av maskinerna. Och vi strävar inte efter det: CPU och minne behövs alltid för andra processer. För att lösa detta problem har vi beslutat att använda . Tanken är att tilldela Ingester ett högre prioritet än andra (stateless) mikrotjänster. När vi behöver starta en extra (N+1) Ingester, tillfälligt flyttar vi andra, mindre pods. Dessa pods flyttas till lediga resurser på andra maskiner, vilket lämnar ett tillräckligt stort "hål" för att starta en extra Ingester.
Torsdagen den 18 juli införde vi fyra nya nivåer av prioriteringar i våra kluster: kritisk, en hög, medel och låg. De testades på det interna klustret utan kundtrafik i ungefär en vecka. Som standard fick pods utan angiven prioritet medel prioritet, medan Ingester hade en klass med hög prioritet. Kritisk var reserverad för övervakning (Prometheus, Alertmanager, node-exporter, kube-state-metrics osv.). Vår konfiguration är öppen, och du kan se PR:en .
Krasch
Fredagen den 19 juli startade en av ingenjörerna ett nytt dedikerat Cortex-kluster för en stor kund. Konfigurationen för detta kluster inkluderade inte de nya prioriteringarna för pods, så alla nya pods fick standardprioritet — medel.
Kubernetes-klustret hade inte tillräckligt med resurser för det nya Cortex-klustret, och det befintliga produktionsklustret för Cortex hade inte uppdaterats (Ingester kvarstod utan hög prioritet). Eftersom Ingester i det nya klustret som standard hade medel prioritet, och de befintliga produktionspoddarna fungerade helt utan prioritet, trängde Ingester från det nya klustret ut Ingester från det befintliga produktionsklustret för Cortex.
ReplicaSet för den utdrivna Ingester i produktionsklustret upptäckte den utdrivna podden och skapade en ny för att upprätthålla det angivna antalet kopior. Den nya podden tilldelades som standard medel prioritet, och den "gamla" Ingester i produktionen förlorade resurser. Resultatet blev en lavinartad process, som ledde till att alla poddar med Ingester för produktionskluster av Cortex drevs ut.
Ingester är tillståndsinriktade och lagrar data från de senaste 12 timmarna. Detta gör att vi mer effektivt kan komprimera dem innan de skrivs till långtidslagring. För detta utför Cortex datasharding baserat på serier, använder en distribuerad hash-tabell (Distributed Hash Table, DHT), och replikerar varje serie på tre Ingester med hjälp av kvorumkonsensus i stilen av Dynamo. Cortex skriver inte data till Ingester som är avstängda. Därför, när ett stort antal Ingester lämnar DHT, kan Cortex inte säkerställa tillräcklig replikation av poster, och de "faller".
Upptäckta och åtgärdande
Nya Prometheus-notifikationer baserade på "felbudget" (error-budget-based — detaljer kommer i en framtida artikel) började ge larm efter 4 minuter från det att avstängningen började. Under de följande fem minuterna diagnostiserade vi problemet och ökade den underliggande Kubernetes-klustret för att rymma både nya och befintliga produktionskluster.
Ytterligare fem minuter senare hade de gamla Ingester lyckats skriva sina data, medan de nya startade, och Cortex-klustren blev återigen tillgängliga.
Ytterligare 10 minuter gick åt till att diagnostisera och åtgärda out-of-memory (OOM) fel från autentiseringens omvända proxyservrar som låg framför Cortex. OOM-felen orsakades av en tiodubbling av QPS (som vi misstänker beror på överdrivet aggressiva förfrågningar från klientens Prometheus-servrar).
Konsekvenser
Den totala driftstoppstiden var 26 minuter. Data gick inte förlorade. Ingester lyckades ladda alla in-memory-data till lagringslösningen. Under avstängningen buffrade Prometheus-servrarna hos kunderna de (remote) poster med hjälp av baserad på WAL (skapad av från Grafana Labs) och upprepade de misslyckade posterna efter kraschen.
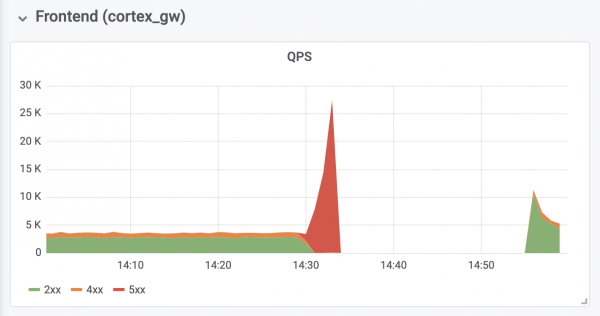
Skrivoperationer för produktionsklustret
Slutsatser
Det är viktigt att dra lärdomar från denna incident och vidta nödvändiga åtgärder för att förhindra att den upprepas.
När man ser tillbaka måste man erkänna att vi inte skulle ha ställt in prioritet som standard medel förrän alla Ingester i produktion hade fått en hög prioritet. Dessutom borde vi ha sett till deras höga prioritet i förväg. Nu är allt åtgärdat. Vi hoppas att vår erfarenhet kommer att hjälpa andra organisationer som överväger att använda pod-prioriteringar i Kubernetes.
Vi kommer att lägga till en extra kontrollnivå för distributionen av eventuella ytterligare objekt vars konfigurationer är globala för klustret. Framöver kommer sådana ändringar att bedömas avbästa resultatet (subjektiv åsikt).ett större antal personer. Dessutom ansågs modifieringen som ledde till felet vara för obetydlig för ett separat projekt dokument — den diskuterades endast i GitHub-ärendet. Från och med nu kommer alla sådana konfigurationsändringar att åtföljas av motsvarande projektdokumentation.
Slutligen kommer vi att automatisera skalningen av autentiseringsproxy-servern för att förhindra OOM vid överbelastning, vilket vi bevittnat, och analysera standardinställningarna i Prometheus relaterade till rollback och skalning för att förhindra liknande problem i framtiden.
Det fel som upplevdes hade också vissa positiva konsekvenser: genom att få tillgång till de nödvändiga resurserna återhämtade sig Cortex automatiskt utan ytterligare ingripande. Vi fick också värdefull erfarenhet av att arbeta med — vårt nya loggaggregationssystem, — som hjälpte till att säkerställa att alla Ingester fungerade korrekt både under och efter felet.
P.S. från översättaren
Läs även i vår blogg:
- «»;
- «»;
- «»;
- «».
Källa: habr.com
