

Inom ramen för forskningsprojektet har arbetet påbörjats för att lägga till i GCC en funktion som möjliggör att dela upp kompilationsprocessen i flera parallellt körande trådar. För närvarande används för att öka bygghastigheten på flerkärniga system en metod där separata kompilatorprocesser startas via make, där varje process bygger en separat kodfil. Det nya projektet experimenterar med att möjliggöra parallellisering på kompilatornivå, vilket potentiellt kan öka effektiviteten på flerkärniga system.
För testning en separat parallelliseringsgren av GCC förberetts, där ett nytt parameter "—param=num-threads=N" föreslås för att ange antalet trådar. I det initiala skedet har vi implementerat att flytta mellanprocedurala optimeringar till separata körtrådar, som cykliskt anropas för varje funktion och som lämpar sig väl för parallellisering. Separata trådar har tilldelats GIMPLE-operationer som ansvarar för plattformsoberoende optimeringar och utvärderar samverkan mellan funktioner.
I nästa steg planeras även att flytta mellanprocedurala RTL-optimeringar till separata trådar, som tar hänsyn till hårdvaruplattformens egenskaper. Efter detta planeras implementering av parallellisering av intra-procedurala optimeringar (IPA), som tillämpas på koden inom en funktion, oberoende av anropsspecifika egenskaper. Den begränsande faktorn är för närvarande skräpsamlaren, där en global lås har lagts till som inaktiverar skräpsamlingsåtgärder under körning i flertrådigt läge (i framtiden kommer skräpsamlaren att anpassas för flertrådigt genomförande av GCC).
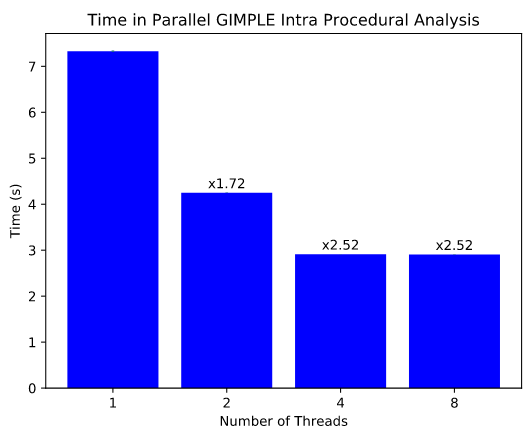
För att bedöma prestandaförändringar har ett testpaket tagits fram som bygger en fil gimple-match.c, som innehåller mer än 100 000 kodrader och 1 700 funktioner. Tester på ett system med CPU Intel Core i5-8250U med 4 fysiska kärnor och 8 virtuella (Hyperthreading) visade en minskning av körtiden för Intra Procedural GIMPLE-optimeringar från 7 till 4 sekunder vid körning av 2 trådar och ner till 3 sekunder vid körning av 4 trådar, vilket innebär en hastighetsökning av det aktuella byggsteget med 1,72 och 2,52 gånger, respektive. Tester visade också att användningen av virtuella kärnor vid Hyperthreading inte leder till en ökning av prestandan.
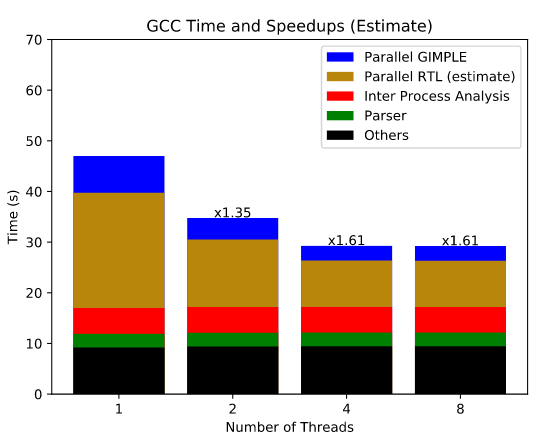
Den totala byggtiden har minskats med cirka 10%, men enligt prognoser kommer parallellisering av RTL-optimeringar att ge mer märkbara resultat, eftersom detta steg tar avsevärt mer tid vid kompilering. Efter parallellisering av RTL förväntas den totala byggtiden minska med 1,61 gånger. Efter det kan byggtiden minskas ytterligare med 5-10% genom att parallellisera IPA-optimeringar.
Källa: opennet.ru
