

Jag har alltid varit nyfiken på hur jag kan bättre organisera böckerna i mitt digitala bibliotek. Slutligen kom jag fram till en lösning med automatisk räkning av sidantal och andra funktioner. Alla intresserade är välkomna att läsa vidare.
Del 1. Dropbox
Alla böcker jag har ligger på Dropbox. Det finns fyra kategorier som jag har delat upp allt i: Lärbok, Handbok, Skönlitteratur, Facklitteratur. Men handböckerna lägger jag inte till i tabellen.
Största delen av böckerna är .epub, resten är .pdf. Så den slutgiltiga lösningen måste täcka båda alternativen.
Vägarna till böckerna ser ungefär ut så här:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Om boken är skönlitterär tas kategorin (dvs 'Design' i det ovanstående fallet) bort.
Jag beslöt mig för att inte krångla med Dropbox API, lyckligtvis har jag deras app installerad som synkroniserar mappen. Så planen är att hämta böcker från mappen, köra varje bok genom en ordräknare och lägga till den i Notion.
Del 2. Lägga till en rad
Själva tabellen bör se ungefär ut så här. OBS: kolumnnamnen är bäst att göra med latinska bokstäver.
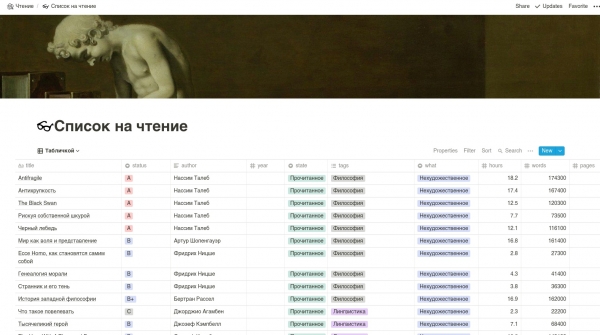
Vi kommer att använda det inofficiella Notion API, eftersom det officiella ännu inte har kommit.

Vi går till Notion, trycker Ctrl + Shift + J, går till Application -> Cookies, kopierar token_v2 och kallar det TOKEN. Sedan går vi till den sida där vår biblioteks-tabell finns och kopierar länken. Vi kallar det NOTION.
Sedan skriver vi koden för att ansluta till Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Därefter skriver vi en funktion för att lägga till en rad i tabellen.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Skönlitteratur":
            row.author = tags[2]

        elif tags[0] == "Facklitteratur":
            row.tags = tags[2]

        elif tags[0] == "Läroböcker":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Vad som händer här är att vi tar och lägger till en ny rad i tabellen som första rad. Sedan splittar vi vår väg på '/' och får taggar. Taggarna handlar om 'Skönlitteratur', 'Design', vem författaren är och så vidare. Sedan fyller vi i alla nödvändiga fält i tabellen.
Del 3. Beräkna ord, timmar och andra fördelar
Det här är en lite svårare uppgift. Som vi minns har vi två format: ePub och PDF. Medan det är klart med ePub — där finns förmodligen orden, så är det inte så entydigt med PDF: den kan bestå av bara hopklistrade bilder.
Så funktionen för att räkna ord i PDF kommer att se ut så här: vi tar antalet sidor och multiplicerar med en viss konstant (det genomsnittliga antalet ord per sida).
Så här är den:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Det genomsnittliga WORDS_PER_PAGE för ett A4-blad är ungefär 300.
Nu låt oss skriva en funktion för att räkna sidor. Vi kommer att använda .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Därefter skriver vi en del för att räkna sidor i ePub. Vi använder . Här tar vi boken, konverterar den till rader, och räknar orden i varje rad.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Nu ska vi räkna tiden. Vi tar vårt favoritantal ord och delar det med din läshastighet.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Del 4. Kopplar ihop alla delar
Vi behöver gå igenom alla möjliga vägar i vår mapp med böcker. Kontrollera om boken redan finns i Notion: om den finns — behöver vi inte skapa en rad.
Sedan behöver vi bestämma filtypen, och beroende på detta räkna antalet ord. I slutet lägga till boken.
Så här ser vår kod ut:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Och funktionen för att kontrollera om boken har lagts till ser ut så här:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Slutsats
Tack till alla som läste den här artikeln. Jag hoppas att den hjälper dig att läsa mer 🙂
Källa: habr.com
