

Portalchefen för Banki.ru, Andrey Nikolsky, delade med sig av insikter under förra årets konferens. om föräldralösa tjänster: hur man identifierar en föräldralös i infrastrukturen, varför föräldralösa tjänster är problematiska, vad man kan göra med dem, och hur man ska agera om inget hjälper.
Under detta finns den textuella versionen av föredraget.
Hej kollegor! Jag heter Andrey och jag ansvarar för driften på Banki.ru.
Vi har stora tjänster, som monolitiska tjänster, det finns tjänster i en mer klassisk mening, och så finns det väldigt små. I min arbetsvardag skulle jag säga att om en tjänst är enkel och liten, så är det en mikro-tjänst, och om den inte är särskilt enkel och inte liten, så är det bara en tjänst.
Fördelar med tjänster
Jag kommer snabbt att gå igenom fördelarna med tjänster.
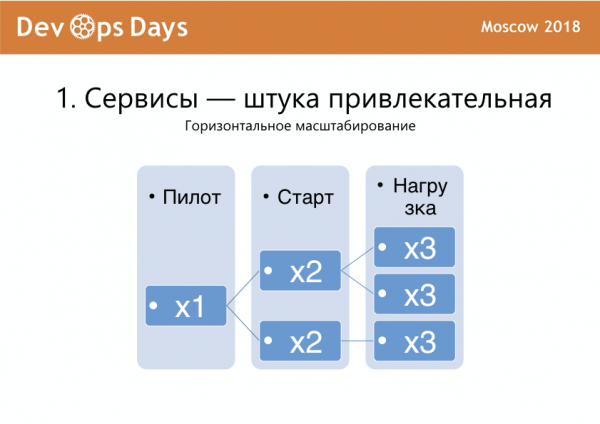
Först och främst — skalbarhet. Du kan snabbt göra något på tjänsten och starta i produktion. Om du får trafik, kan du klona tjänsten. Få ytterligare trafik, klona en gång till och leva med det. Det är en bra bonus och när vi började ansågs det vara det viktigaste skälet till varför vi överhuvudtaget gjorde detta.
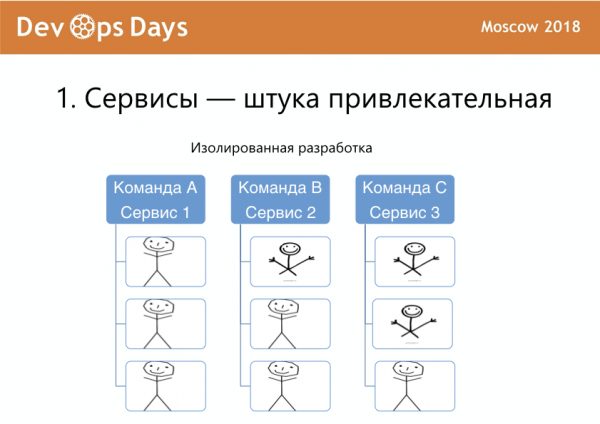
För det andra, isolerad utveckling, där du har flera utvecklingsteam, flera olika utvecklare i varje team, och varje team utvecklar en egen tjänst.
Men det finns en nyans med teamen. Utvecklare är olika. Och det finns till exempel Jag såg detta för första gången hos Maxim Dorofeev. Ibland finns det snöflingor i vissa team, och i andra team finns det inte. Det gör att olika tjänster som används inom företaget blir något ojämna.
Titta på bilden: det här är en bra utvecklare, han har stora händer och kan göra mycket. Det stora problemet är varifrån dessa händer kommer.
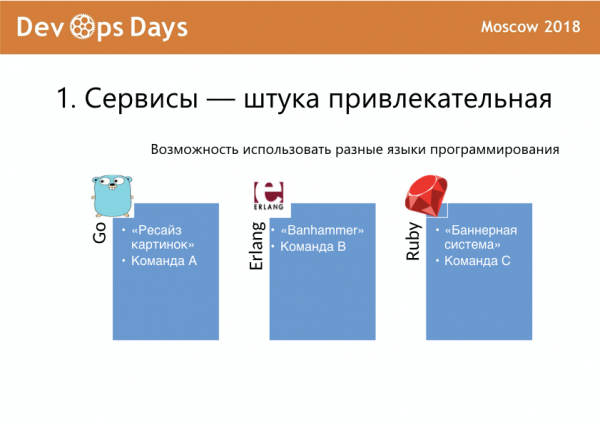
Tjänster ger möjlighet att använda olika programmeringsspråk, som är bättre anpassade för olika uppgifter. Någon tjänst på Go, någon på Erlang, någon på Ruby, något på PHP, något på Python. Generellt kan man verkligen bredda sig. Det finns också nyanser här.
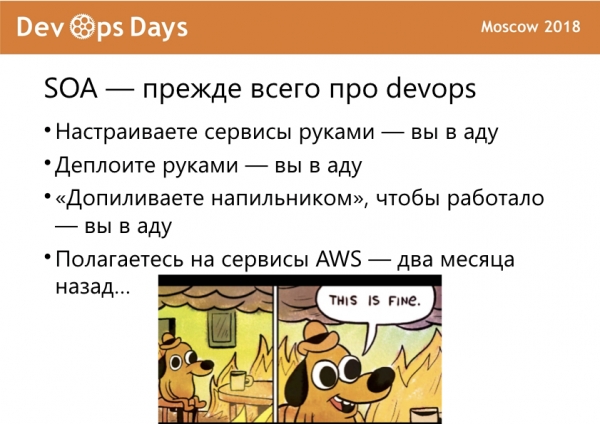
Tjänstebaserad arkitektur handlar framför allt om devops. Det vill säga om du inte har automatisering, inget deploymentsystem, om du konfigurerar manuellt, kan dina konfigurationer variera från instans till instans, och du måste gå åt dem för att göra något, då är du i helvetet.
Till exempel, om du har 20 tjänster och behöver deploya manuellt, har du 20 konsoler och trycker på "enter" samtidigt som en ninja. Det är inte optimalt.
Om du har en tjänst efter testning (om det finns testning förstås) och behöver fortfarande finjustera den så att den fungerar i produktion, har jag också dåliga nyheter för dig.
Om du är beroende av specifika tjänster från Amazon och samtidigt arbetar i Ryssland, hade du för två månader sedan också "Allt brinner, jag är okej, allt är toppen".
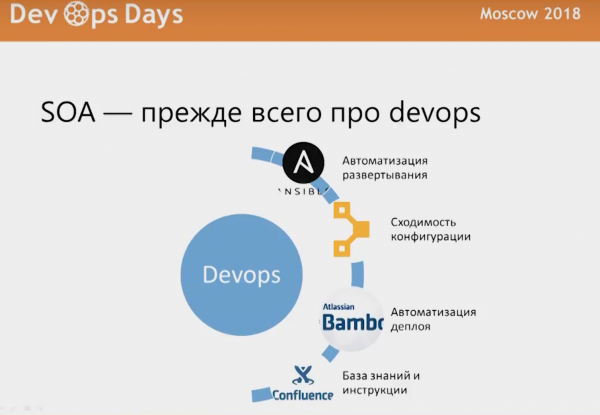
Vi använder Ansible för att automatisera deployment, Puppet för konvergens, Bamboo för att automatisera deployment, och Confluence för att dokumentera allt detta.
Jag kommer inte att gå in på detalj här, eftersom presentationen snarare handlar om interaktionspraxis än om teknisk implementation.
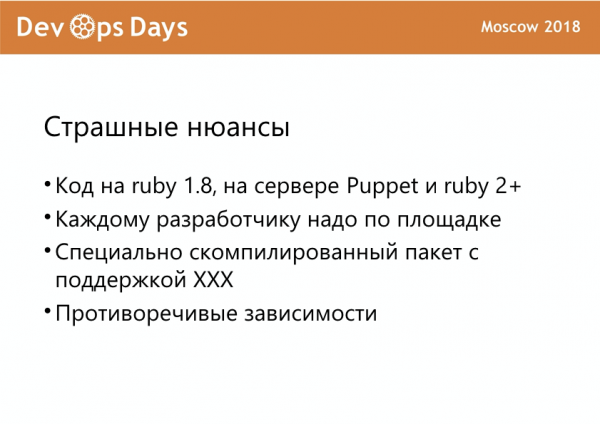
Vi har till exempel haft problem med att Puppet på servern kör med Ruby 2, medan en viss applikation är skriven för Ruby 1.8, och de fungerar inte tillsammans. Det uppstår något fel där. Och när du behöver hålla flera versioner av Ruby på samma maskin, uppstår vanligtvis problem.
Vi ger till exempel varje utvecklare en plattform där det finns nästan allt vi har, alla tjänster som kan utvecklas, så att de har en isolerad miljö, där de kan förstöra och bygga som de vill.
Ibland behövs ett specialkompilerat paket med stöd för något särskilt. Det är ganska strikt. Jag hörde en presentation där en Docker-image vägde 45 GB. I Linux är det förstås enklare, där är allt mindre, men ändå, det finns inget utrymme kvar.
Och det uppstår motstridiga beroenden, när en del av projektet är beroende av ett bibliotek av en version, medan en annan del är beroende av en annan version, och biblioteken kan överhuvudtaget inte installeras tillsammans.
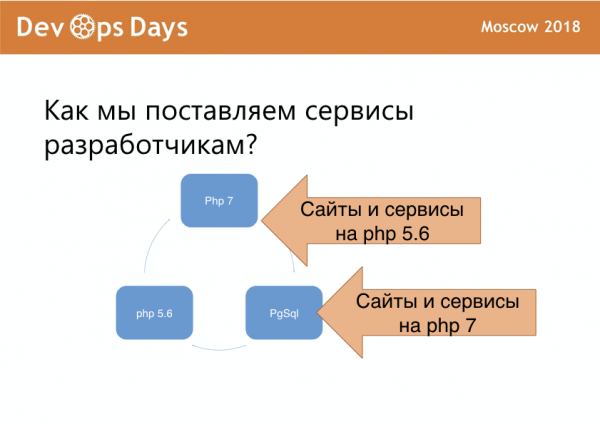
Vi har webbplatser och tjänster på PHP 5.6, vi skäms över dem, men vad gör man. Det är vår plattform. Det finns webbplatser och tjänster på PHP 7, de är fler, och vi skäms inte för dem. Varje utvecklare har sin egen databas där de gladeligen kan koda.
Om ni skriver på samma språk i företaget låter tre virtuella maskiner per utvecklare normalt. Om ni har olika programmeringsspråk blir situationen sämre.
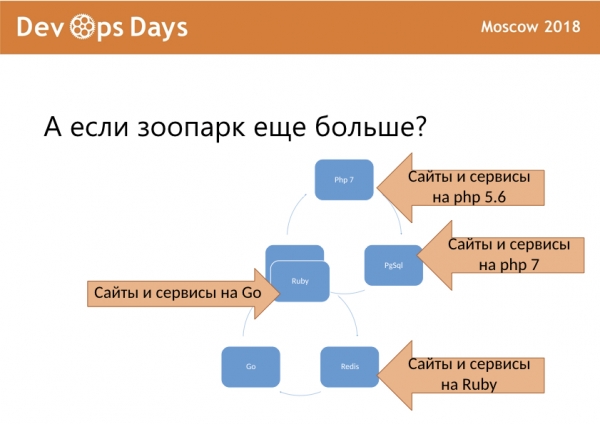
Du har webbplatser och tjänster här, här, och sedan en plattform för Go, en plattform för Ruby, och kanske någon Redis vid sidan av. Slutligen blir allt detta ett stort fält för support, och något av detta kan alltid gå sönder.
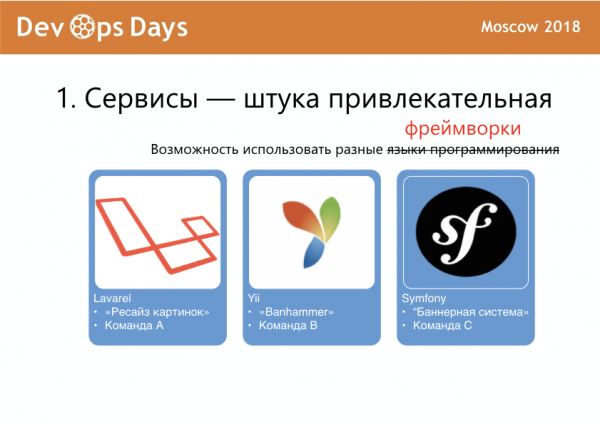
Därför har vi bytt ut programmeringsspråkets godbitar mot användning av olika ramverk, eftersom ramverken på PHP är tillräckligt olika, de har olika möjligheter, olika gemenskaper, och olika stöd. Man kan skriva tjänster så att man redan har något redo för dem.
Varje tjänst har sitt eget team
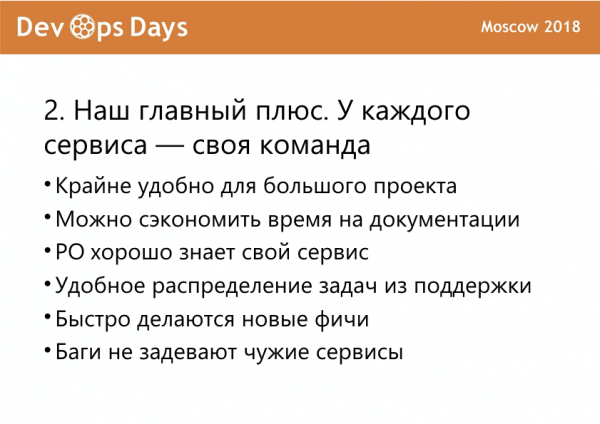
Vår största fördel, som har kristalliserats fram under flera år, är att varje tjänst har sitt eget team. Detta är praktiskt för ett stort projekt, man kan spara tid på dokumentation, cheferna känner väl sitt projekt.
Supportuppgifter kan enkelt överlåtas. Till exempel, om försäkringsservicen går sönder. Och genast går teamet som hanterar försäkringen för att laga den.
Nya funktioner skapas snabbt, eftersom när du har en viss atomär tjänst kan du snabbt implementera något nytt.
Och när du har gjort din tjänst trasig, vilket oundvikligen händer, påverkar det inte andras tjänster, och utvecklarna kommer inte rusande med klubbor från andra team och säger: 'Aj-aj, gör inte så'.
Som alltid finns det nyanser. Vi har stabila team, och teamens chefer är fast förankrade. Det finns tydliga dokument, och cheferna övervakar allt noggrant. Varje team har flera tjänster med sin chef, och det finns en specifik kompetenspunkt.
Om teamen är flytande (detta används också ibland hos oss), finns en bra metod som kallas 'stjärnkarta'.
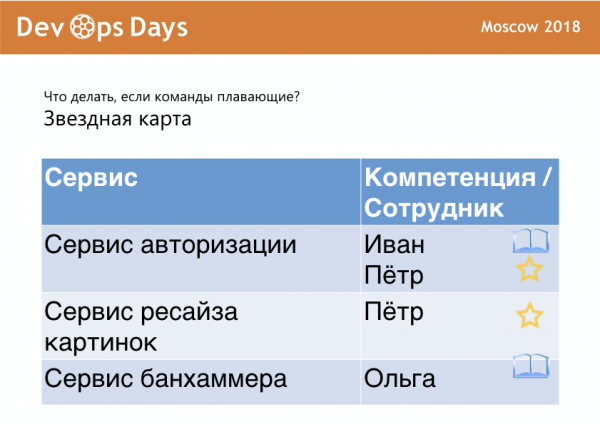
Du har en lista över tjänster och personer. En stjärna betyder att personen är expert på den tjänsten, en bok betyder att personen studerar denna tjänst. Målet för personen är att byta boken mot en stjärna. Och om det inte står något mot tjänsten, då börjar problemen som jag kommer att berätta mer om.
Hur uppstår föräldralösa tjänster?
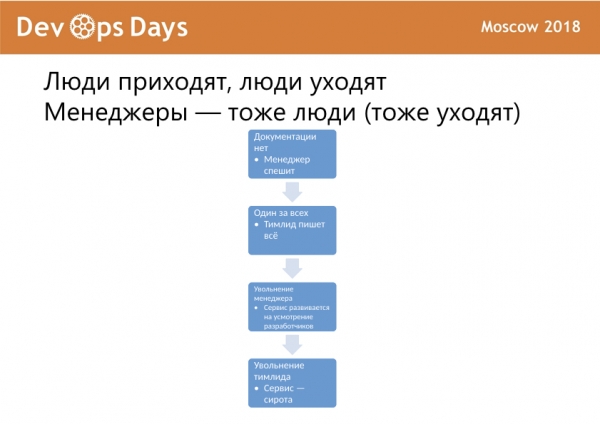
Det första problemet, den första metoden för att få en tjänst i din infrastruktur som blivit en föräldralös tjänst, är uppsägningar av personer. Har någon någonsin varit med om att det kommer tidsgränser från affärssidan innan man har utvärderat uppgifterna? Ibland finns det strikta tidsgränser och det finns helt enkelt inte tid för dokumentation. "Vi måste släppa tjänsten i produktion, så får vi skriva mer senare."
Om teamet är litet kan det hända att det bara finns en utvecklare som skriver allt, medan resten av teamet bara stöder. "Jag har skrivit den grundläggande arkitekturen, du kan lägga till gränssnitt." Sen, vid något tillfälle, till exempel när chefen slutar. Och under den perioden när chefen har slutat och ingen ny har utnämnts, bestämmer utvecklarna själva vart tjänsten är på väg och vad som sker. Och som vi vet (låt oss gå tillbaka några sidor) finns det i vissa team personer som är som snöflingor, ibland en snöflinge-teamledare. Sen slutar de, och vi har en föräldralös tjänst.
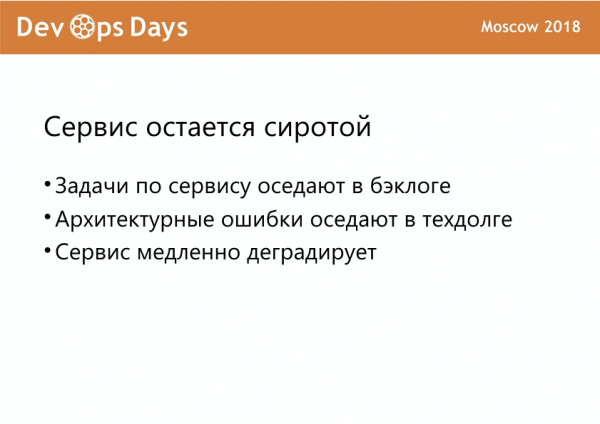
Samtidigt försvinner inte uppgifterna från supporten och affären, de samlas i backloggen. Om det fanns några arkitektoniska misstag vid utvecklingen av tjänsten, så kvarstår de också i backloggen. Tjänsten degraderas sakta.
Hur identifierar man en föräldralös tjänst?
Den här listan beskriver situationen ganska bra. Vem har känt igen något i sin infrastruktur?
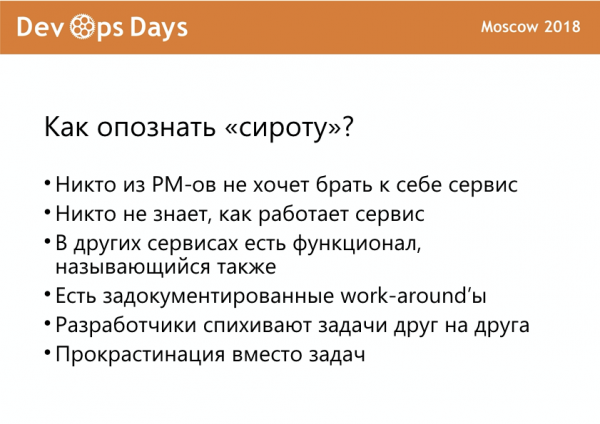
Om dokumenterade workarounds: det finns en tjänst och, i stort sett, fungerar den, den har en manual på två sidor om hur man arbetar med den, men hur den fungerar inuti, vet ingen.
Eller, till exempel, det finns någon form av länkförkortare. Just nu har vi tre olika länkförkortare för olika syften i olika tjänster. Det är följderna av detta.
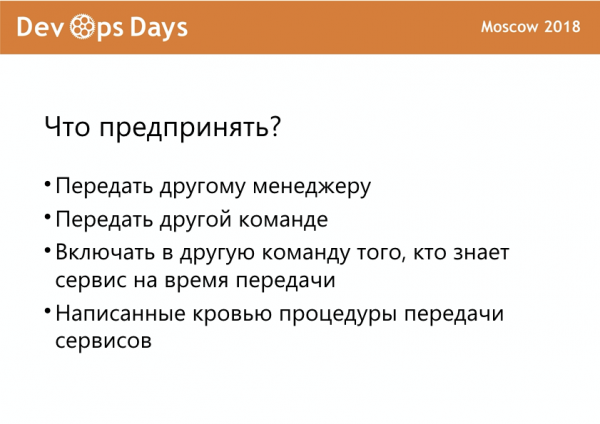
Nu ska jag vara kapten uppenbarhet. Vad behöver man göra? För det första måste tjänsten överlämnas till en annan chef, ett annat team. Om er teamledare inte har slutat ännu, bör ni inkludera någon i det andra teamet som åtminstone förstår något av tjänsten när ni inser att den börjar likna en föräldralös tjänst.
Den viktigaste saken: ni måste ha skrivna procedurer för överlämning. I vårt fall brukar jag hålla koll på detta, för jag vill att allt ska fungera. Cheferna vill att det ska överlämnas snabbt, och vad som händer sedan är inte så viktigt för dem.
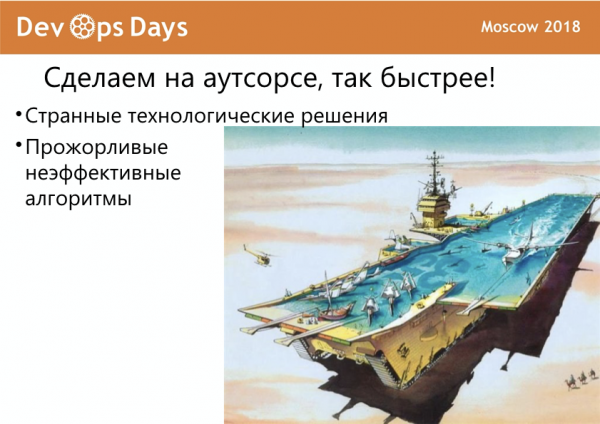
Ett annat sätt att skapa en "föräldralös" är att säga "Vi gör det på outsourcing, så går det snabbare, och sedan överlämnar vi det till teamet". Det är klart att alla har någon typ av planer i sitt team och kö. Ofta tror affärskunden att outsourcere gör det på samma sätt som teknikavdelningen i företaget. Men incitamenten för dem är olika. Det kan finnas märkliga tekniska lösningar och konstiga algoritmiska lösningar på outsourcing.
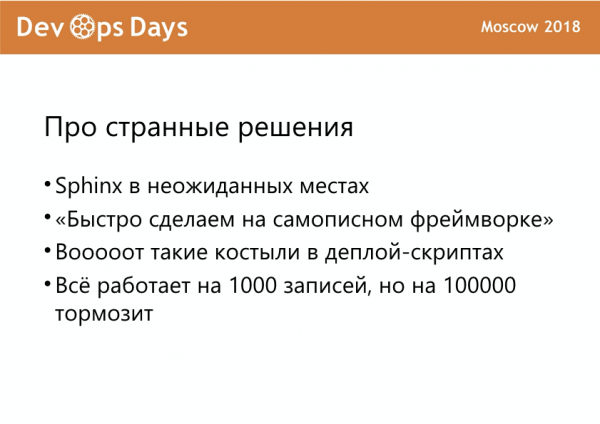
Till exempel hade vi en tjänst där Sphinx fanns på olika oväntade ställen. Jag berättar senare vad vi var tvungna att göra.
Outsourcere kan använda eget skrivna ramverk. Det är helt enkelt ren PHP med kopierat innehåll från ett tidigare projekt, där man kan hitta allt möjligt. Stora lösningar i deploy-skript, när man behöver använda komplicerade Bash-skript för att ändra några rader i någon fil, där dessa deploy-skript anropas av något tredje skript. I slutändan byter du ut systemet för distribution, och plötsligt fungerar inte din tjänst längre. För där behövde du även sätta 8 länkar mellan olika mappar. Eller så fungerar tusen poster, men hundratusen gör det inte.
Jag fortsätter att styra. Acceptans av tjänsten från outsourcing är en obligatorisk procedur. Har någon varit med om att en tjänst från outsourcing anländer men inte accepteras? Det är inte så populärt som en föräldralös tjänst, men det förekommer ändå.
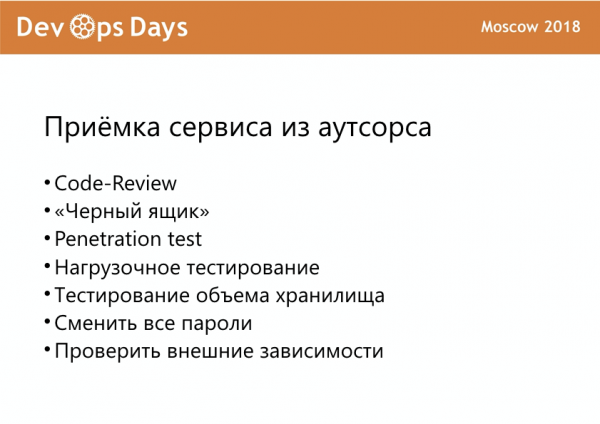
Tjänsten måste kontrolleras, tjänsten måste granskas, lösenord måste bytas. Vi hade ett fall där vi fick en tjänst, och där stod administratören "if login == 'admin' && password == 'admin'...", skrivet rakt i koden. Vi satt och undrade, skriver faktiskt folk så här 2018?
Test av lagringskapacitet är också viktigt. Det är nödvändigt att se vad som händer med hundratusentals poster innan du släpper tjänsten i produktion.
Att skicka tjänsten för vidareutveckling bör inte vara något att skämmas för. När du säger: "Vi kommer inte att acceptera den här tjänsten, vi har 20 uppgifter, gör dem så accepterar vi", är det okej. Du ska inte behöva ha dåligt samvete över att du sätter managern i en svår situation eller att affären spenderar pengar. Affären kommer att kosta mer senare.
Vi hade ett fall där vi bestämde oss för att göra ett pilotprojekt på outsourcing.
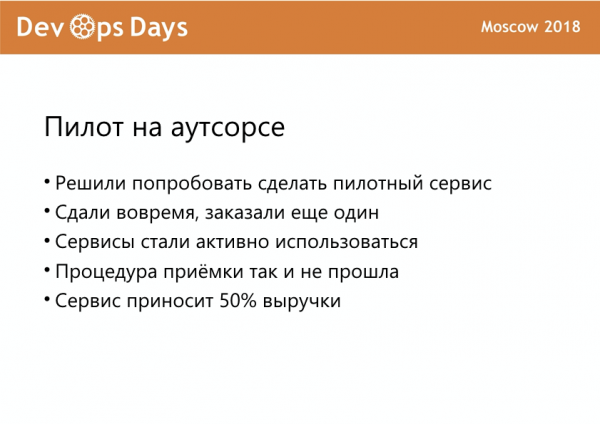
Det blev utlämnat i tid, och det var den enda kvalitetskriteriet. Därför gjorde vi ännu ett pilotprojekt, som inte ens var riktigt pilotprojekt. Dessa tjänster godkändes, genom administrativa medel sa de, här är er kod, här är ert team, här är er chef. Tjänsterna började verkligen generera vinst. Samtidigt förblev de i praktiken fortfarande föräldralösa, ingen förstår hur de fungerar, och cheferna skyller ifrån sig på deras uppgifter.
Det finns också ett utmärkt begrepp - guerillautveckling. När en avdelning, vanligtvis marknadsavdelningen, vill testa en hypotes och beställer en tjänst helt på outsourcing. Trafiken börjar strömma in, de stänger dokumenten, signerar handlingar med entreprenören, går i drift och säger: "Grabbar, vi har en tjänst, det finns redan trafik på den, den ger oss pengar, låt oss acceptera den." Vi säger: "Oj, hur blev det så?".
Och ännu ett sätt att få en föräldralös tjänst: när ett team plötsligt är överbelastat, säger ledningen: "Låt oss överföra tjänsten från detta team till ett annat team med mindre belastning." Och sedan överför vi det till ett tredje team, och byter chefen. Och i slutändan har vi återigen en föräldralös.
Vad är problemet med de föräldralösa?
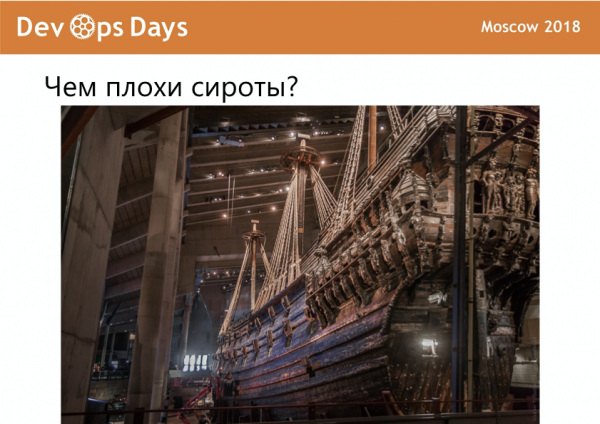
För den som inte vet, det handlar om det i Sverige upphöjda linjeskeppet Wasa, berömt för att det sjönk fem minuter efter sjösättningen. Och Sveriges kung, för övrigt, avrättade ingen för det. Det byggdes av två generationer ingenjörer som inte visste hur man byggde sådana fartyg. En logisk effekt.
Skeppet kunde för övrigt ha sjunkit mycket värre, till exempel när kungen redan hade åkt någonstans i en storm. Men så sjönk det direkt, enligt agilt tänkande är det bra – att misslyckas tidigt.
Om vi misslyckas tidigt brukar det sällan vara några problem. Till exempel, vid godkännande skickades det för förbättring. Men om vi redan har misslyckats i produktionen, när pengar har investerats, kan det bli problem. Konsekvenser, som man säger i affärer.
Vad är farorna med föräldralösa tjänster:
- Tjänsten kan plötsligt gå sönder.
- Tjänsten tar lång tid att laga eller lagas inte alls.
- Säkerhetsproblem.
- Problem med förbättringar och uppdateringar.
- Om en viktig tjänst går sönder, lider företagets rykte.
Vad ska man göra med föräldralösa tjänster?
Jag upprepar vad som ska göras. För det första måste det finnas dokumentation. 7 år på Banki.ru lärde mig att testare inte ska lita på utvecklare utan bevis, och att drift inte ska lita på någon. Man måste kontrollera.
För det andra behöver man skriva interaktionsscheman, eftersom det ibland visar sig att tjänster som antas inte är så bra innehåller beroenden som ingen har sagt något om. Till exempel, utvecklarna satte en tjänst på sin nyckel till Yandex.Mappar eller Dadata. Om din fria gräns tar slut, går allt sönder och du vet inte vad som har hänt överhuvudtaget. Alla sådana fall måste beskrivas: tjänsten använder Dadata, Sms, eller något annat.
För det tredje, arbete med teknisk skuld. När du gör några provisoriska lösningar eller accepterar en tjänst och säger att något måste göras, måste man se till att det görs. För senare kan det visa sig att en liten grop inte är så liten, och du kan falla ner i den.
Vi hade en historia med arkitekturuppgifter om Sphinx. I en av tjänsterna användes Sphinx för att mata in listor. Bara en lista med paginering, men den indexerades om varje natt. Den byggdes av två index: ett stort som indexerades varje natt, och ett litet index som kopplades till det. Varje dag, med 50% chans, antingen sprack det eller inte, vid publiceringen blev indexet trasigt och nyheterna slutade uppdateras på hemsidan. Till en början var det 5 minuter, medan indexet blev omindexerat, sedan växte indexet, och vid ett tillfälle började det ta 40 minuter att omindexera. När vi tog bort det andades vi ut lättat, för det blev klart att det skulle ta lite tid innan vårt index skulle behöva omindexeras hela arbetsdagen. Det skulle vara ett misslyckande för vår portal, åtta timmar utan nyheter — då står verksamheten stilla.
Arbetsplan för föräldralös tjänst
Faktum är att det är väldigt svårt att göra det, eftersom devops handlar om kommunikation. Man vill ha goda relationer med sina kollegor, och när du slår kollegor och chefer i huvudet med regler kan de ha blandade känslor för de som gör så.
Förutom alla dessa punkter finns det en viktig aspekt: för varje specifik tjänst, för varje del av distributionsprocessen, bör det finnas specifika personer som ansvarar. När det inte finns några personer och man tvingas involvera andra, som behöver sätta sig in i allt, blir det svårt.
Om allt detta inte har hjälpt och din tjänst fortfarande är en ensamstående tjänst, ingen vill ta hand om den, dokumentationen skrivs inte, teamet som rekryterades för tjänsten vägrar att göra något, finns det ett enkelt sätt — göra om allt.
Det vill säga, du tar kraven för tjänsten på nytt och skriver en ny tjänst, en bättre, på en bättre plattform, utan konstiga teknologiska lösningar. Och migrerar till den i drift.
Vi hade en situation där vi tog en tjänst på Yii 1 och insåg att vi inte kunde utveckla den vidare, eftersom vi inte hade några utvecklare kvar som kunde skriva bra på Yii 1. Alla utvecklare kan skriva bra på Symfony 3. Vad göra? Vi avsatte tid, bildade ett team, utsåg en projektledare, omskrev projektet och smidigt skiftade trafik till det.
Efter det kan den gamla tjänsten tas bort. Det är min favoritprocedur, när man i konfigurationshanteringssystemet får ta bort en tjänst och sedan kolla så att alla enheter i produktion är nedstängda, så att inga spår finns kvar för utvecklarna. Repositoriet i git förblir.
Det är allt jag ville berätta, jag är redo för diskussion, det här är ett kontroversiellt ämne, många har erfarenhet av det.
På bilderna nämndes att ni hade enat språken. Som exempel användes resizing av bilder. Är det verkligen nödvändigt att strikt hålla sig till ett språk? För resizing av bilder på PHP, ja, det kunde verkligen göras på Golang också.
I själva verket är det inte nödvändigt, precis som med alla metoder. I vissa fall kan det till och med vara oönskat. Men man måste förstå att om ni har 50 personer i er teknikavdelning, varav 45 är PHP-utvecklare, 3 är DevOps som kan Python, Ansible, Puppet och liknande, och bara en av dem skriver på något Go-program för att ändra storlek på bilder, så när han eller hon lämnar, försvinner expertisen med dem. Dessutom kommer ni att behöva leta efter en specifik utvecklare på marknaden som kan det språket, särskilt om det är sällsynt. Så med tanke på organisationen är detta problematiskt. Från DevOps-perspektiv kommer ni att behöva skriva nya playbooks istället för att bara klona ett färdigt uppsättning av dem som ni använder för att driftsätta tjänster.
Vi utvecklar just nu en tjänst på Node.js, och det kommer att bli en plattform för varje utvecklare med sitt eget språk. Men vi har övervägt om det är värt besväret. Så här handlar det om att tänka efter.
Hur övervakar ni era tjänster? Hur samlar ni in och spårar loggar?
Vi samlar loggar i Elasticsearch och lägger dem i Kibana, och beroende på om det är produktion eller testmiljöer används olika insamlare. På vissa ställen används Lumberjack, på andra ställen något annat, jag minns inte exakt. Det finns också vissa platser i specifika tjänster där vi installerar Telegraf och skickar loggar någon annanstans separat.
Hur lever ni med Puppet och Ansible i samma miljö?
I själva verket har vi just nu två miljöer, en med Puppet och den andra med Ansible. Vi arbetar på att hybridisera dem. Ansible är en bra miljö för initial konfiguration, medan Puppet är dålig för den initiala konfigurationen eftersom den kräver manuella insatser direkt på plattformen, och Puppet säkerställer konvergens i konfigurationen. Det betyder att plattformen upprätthåller sig själv i ett aktuellt tillstånd, medan en Ansible-konfigurerad maskin måste ha playbooks körande kontinuerligt för att hållas aktuell. Det är skillnaden.
Hur upprätthåller ni kompatibilitet? Har ni konfigurationer i både Ansible och Puppet?
Det är vår stora sorg, vi upprätthåller kompatibilitet manuellt och funderar på hur vi kan gå vidare från allt detta. Vi har det så att Puppet installerar paket och hanterar några länkar, medan Ansible till exempel installerar kod och anpassar uppdaterade konfigurationer för applikationer dit.
I presentationen talades det om olika versioner av Ruby. Vilken lösning finns?
Vi stötte på detta på ett ställe, och vi måste hela tiden ha det i åtanke. Vi stängde helt enkelt av den del som körde den version av Ruby som inte var kompatibel med applikationerna och höll den separat.
I år kommer konferensen att hållas den 7 december i "Technopolis". Vi tar emot anmälningar för föredrag fram till den 11 november. till oss om du vill tala.
Registreringen för deltagare är öppen, anslut er!
Källa: habr.com
