

Nätverkskapaciteten hos Amazon Web Services består av 69 zoner runt om i världen i 22 regioner: USA, Europa, Asien, Afrika och Australien. Varje zon rymmer upp till 8 datacenter — databehandlingscenter. I varje datacenter finns tusentals eller hundratusentals servrar. Nätverket är utformat så att alla osannolika driftstörningar beaktas. Till exempel är alla regioner isolerade från varandra, och tillgänglighetszonerna ligger på flera kilometers avstånd från varandra. Även om en kabel klipps kommer systemet att använda reservkanaler, och informationsförlusten kommer att vara några datapaket. Mer om de principer som nätverket är byggt på och hur det fungerar berättar Vasily Pantyukhin.
Vasilij Pantu Chin började som Unix-administratör på .ru-företag, arbetade i 6 år med stora maskiner från Sun Microsystems, och predikade i 11 år datacenterfokus i EMC. Som en naturlig utveckling övergick jag till privata moln och sedan till offentliga. Nu, som arkitekt på Amazon Web Services, ger jag tekniska råd för att hjälpa företag att växa och leva i AWS-molnet.
I den föregående delen av trilogin om AWS uppbyggnad fördjupade Vasily sig i uppbyggnaden av fysiska servrar och skalning av databaser. Nitro-kort, anpassad hypervisor baserad på KVM, databasen Amazon Aurora — allt detta finns i materialet "". Läs för att få en djupare förståelse av kontexten eller se presentationerna.
I den här delen handlar det om nätverkets skalning — en av de mest komplexa systemen inom AWS. Utvecklingen från ett platt nätverk till Virtual Private Cloud och dess uppbyggnad, interna tjänster som Blackfoot och HyperPlane, problemet med bullriga grannar, och slutligen — nätverksstorlekar, backbone och fysiska kablar. Allt detta finner du under läs mer.
Ansvarsfriskrivning: allt nedan är Vasily's personliga åsikt, och den kan skilja sig från Amazon Web Services ståndpunkter.
Nätverksskalning
AWS-molnet lanserades år 2006. Dess nätverk var ganska primitivt — med en platt struktur. Adressintervallet för privata adresser var gemensamt för alla hyresgäster i molnet. När en ny virtuell maskin startade fick du av en slump en tillgänglig IP-adress från detta intervall.
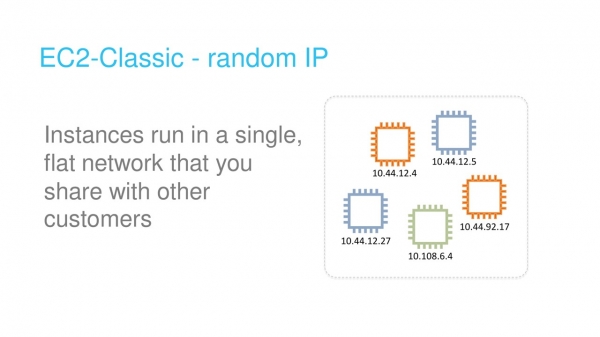
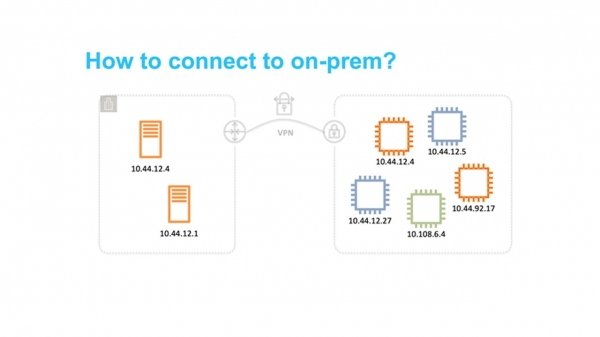
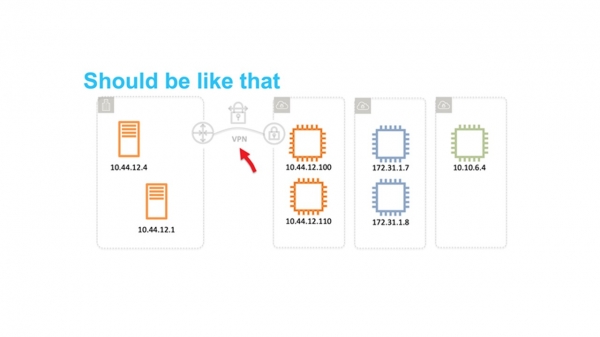
Detta tillvägagångssätt var enkelt att genomföra, men det begränsade grundläggande användningen av molnet. Speciellt var det ganska svårt att utveckla hybridlösningar som kombinerade privata nätverk på marken och i AWS. Det vanligaste problemet låg i överlappningen av IP-adressintervall.
Virtual Private Cloud
Molnet har blivit efterfrågat. Det är dags att tänka på skalbarheten och möjligheten att använda det av tiotals miljoner hyresgäster. Det platta nätverket har blivit det största hindret. Därför började vi tänka på hur vi kan isolera användare från varandra på nätverksnivå så att de själva kan välja IP-områden.
Vad kommer först i tankarna när du tänker på nätverksisolering? Självklart VLAN och VRF - Virtual Routing and Forwarding.
Tyvärr har det inte fungerat. VLAN-ID är endast 12 bitar, vilket ger oss bara 4096 isolerade segment. Även i de största switcharna kan högst 1-2 tusen VRF användas. Kombinationen av VRF och VLAN ger oss bara några miljoner delnät. Det är definitivt inte tillräckligt för tiotals miljoner hyresgäster, där varje hyresgäst måste ha möjlighet att använda flera delnät.
Dessutom kan vi helt enkelt inte ha råd att köpa det antal stora enheter som krävs, till exempel från Cisco eller Juniper. Det finns två skäl: det är fruktansvärt dyrt, och vi vill inte bli beroende av deras utvecklings- och patchpolitik.
Slutsatsen är klar - vi måste koka ihop vår egen lösning.
År 2009 tillkännagav vi VPC — Virtual Private Cloud. Namnet har slagit igenom och nu använder många molnleverantörer det också.
VPC är ett virtuellt nätverk SDN (Software Defined Network). Vi beslutade oss för att inte uppfinna egna protokoll på L2- och L3-nivåer. Nätverket fungerar på standard Ethernet och IP. För att överföra trafik från virtuella maskiner kapslas den in i omslaget av vårt eget protokoll. I det anges ID:t som tillhör VPC-hyresgästen.
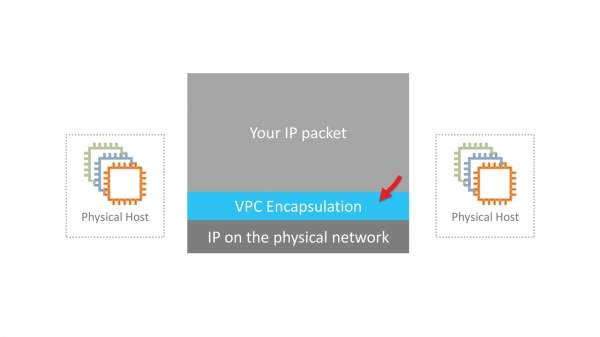
Det låter enkelt. Men det finns flera allvarliga tekniska utmaningar att lösa. Till exempel, var och hur ska vi lagra data om mappningen av virtuella MAC/IP-adresser, VPC-ID och motsvarande fysiska MAC/IP? I skalan av AWS är detta en enorm tabell som måste fungera med minimala fördröjningar vid åtkomst. Det ansvarar för mappningstjänsten, som är utspridd i ett tunt lager över hela nätverket.
I nästa generations maskiner utförs inkapslingen av Nitro-kort på hårdvarunivå. I äldre instanser är inkapsling och dekapsling programvarubaserade.
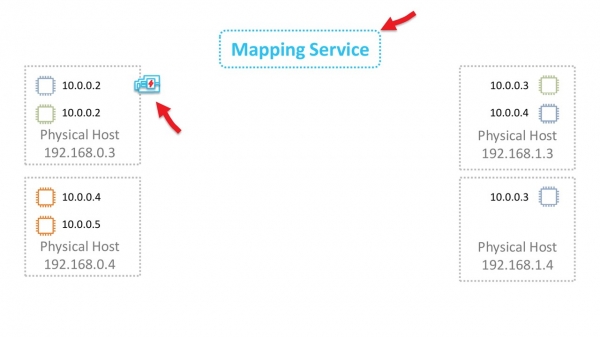
Låt oss förstå hur detta fungerar i stora drag. Vi börjar med nivå L2. Anta att vi har en virtuell maskin med IP 10.0.0.2 på en fysisk server 192.168.0.3. Den skickar data till den virtuella maskinen 10.0.0.3, som ligger på 192.168.1.4. En ARP-förfrågan bildas och hamnar på det nätverkskort som heter Nitro. För enkelhetens skull antar vi att båda virtuella maskinerna finns i samma "blå" VPC.
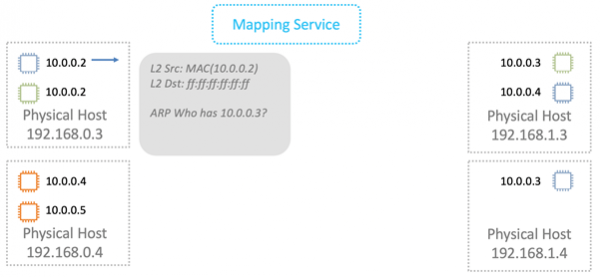
Kortet ersätter källadressen med sin egen och vidarebefordrar ARP-ramen till mappningstjänsten.
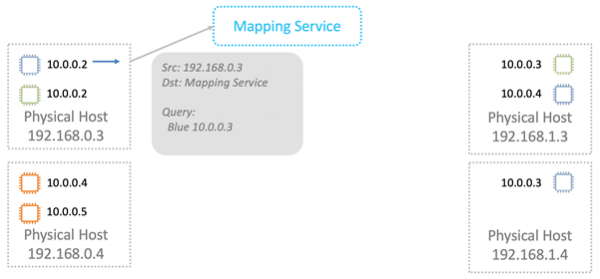
Mappningstjänsten returnerar information som behövs för att skicka över det fysiska L2-nätverket.
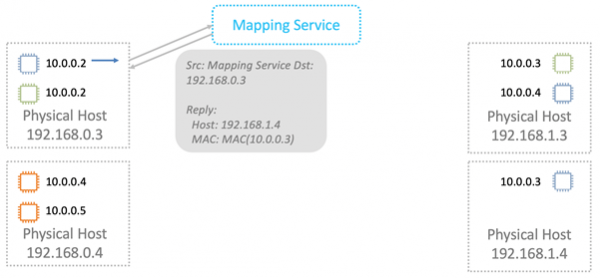
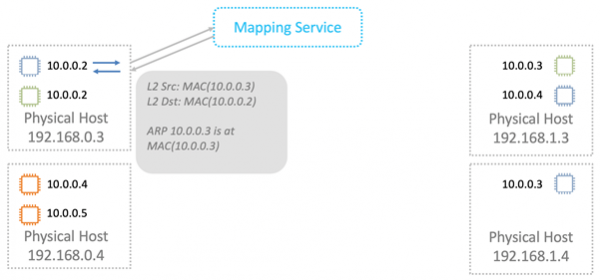
Nitro-kortet ersätter MAC-adressen i det fysiska nätverket med adressen i VPC i ARP-svaret.
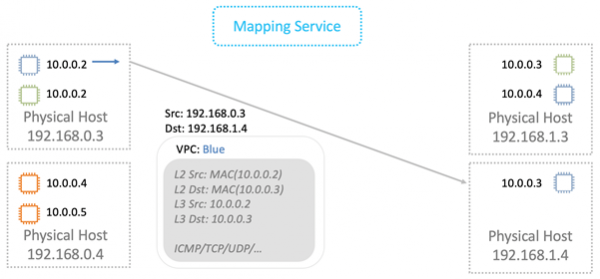
Vid datatransfer kapslar vi de logiska MAC- och IP-adresserna i en VPC-förpackning. Allt detta skickas över det fysiska nätverket med hjälp av motsvarande IP Nitro-kort i avsändning och mottagning.
Den fysiska maskinen som paketet är avsett för utför en kontroll. Detta görs för att förhindra adressförfalskning. Maskinen skickar en speciell förfrågan till mappningstjänsten och frågar: "Från den fysiska maskinen 192.168.0.3 har jag mottagit ett paket som är avsett för 10.0.0.3 i "blå" VPC. Är det legitimt?"
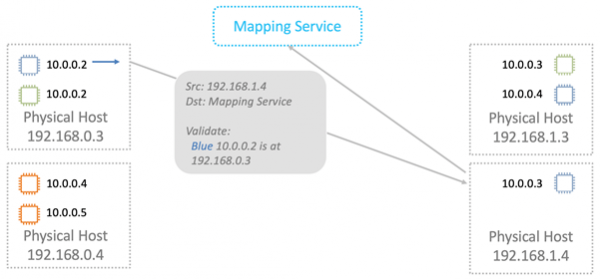
Mappningstjänsten kontrollerar sin resursallokeringstabell och tillåter eller förbjuder paketets passage. I alla nya instanser är det ytterligare validering inbyggd i Nitro-korten. Den kan inte omgås ens teoretiskt. Därför fungerar spoofing på resurser i en annan VPC inte.
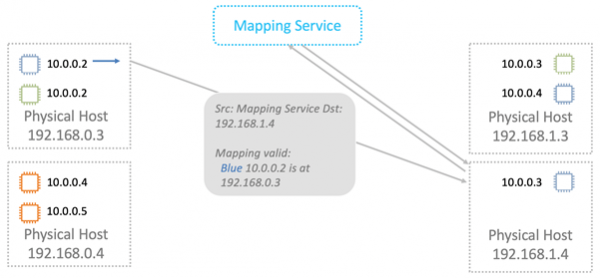
Därefter skickas data till den virtuella maskinen de är avsedda för.
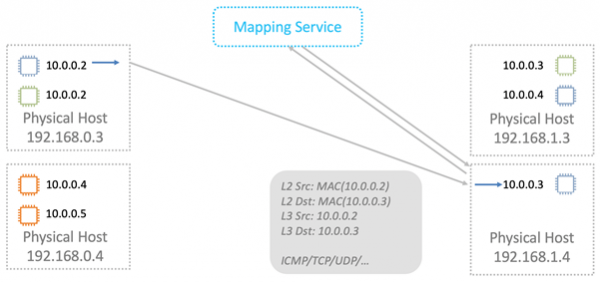
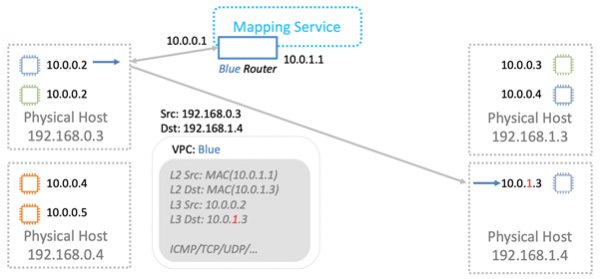
Mappningstjänsten fungerar också som en logisk router för dataöverföring mellan virtuella maskiner i olika delnät. Konceptuellt är det ganska enkelt, jag kommer inte att gå in på detaljer.
Det visar sig att vid överföring av varje paket vänder sig servrarna till mappningstjänsten. Hur ska vi hantera de oundvikliga fördröjningarna? Genom caching, självklart.
Det fina är att vi inte behöver cacha hela den enorma tabellen. På den fysiska servern finns virtuella maskiner från ett relativt litet antal VPC:er. Informationen som behöver cachas gäller endast dessa VPC:er. Överföring av data till andra VPC:er i "standardkonfigurationen" är ändå inte legitim. Om sådana funktioner som VPC-peering används, läggs ytterligare information om de motsvarande VPC:erna till i cachen.
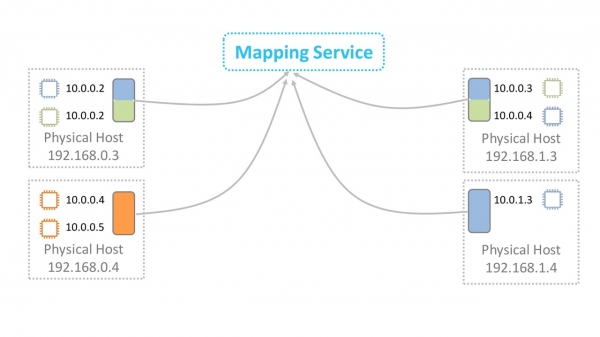
Vi har nu förstått hur dataöverföring i VPC fungerar.
Blackfoot
Hur hanterar man situationer där trafiken måste skickas utåt, till exempel till Internet eller via VPN till landet? Här är vi räddade av Blackfoot — den interna tjänsten AWS. Den har utvecklats av vårt sydafrikanska team. Därför kallas tjänsten efter pingvinen som lever i Sydafrika.
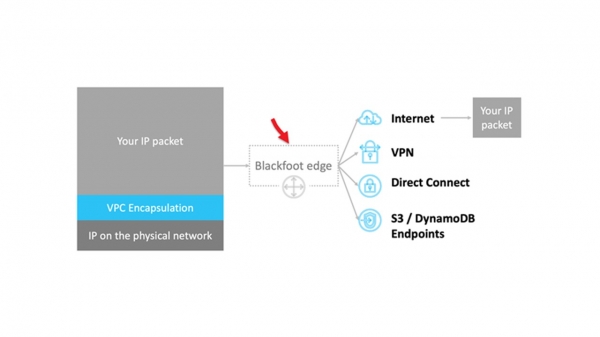
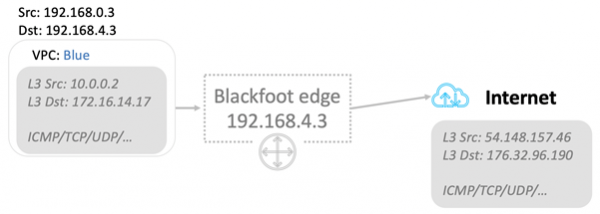
Blackfoot dekapslar trafiken och gör med den vad som behövs. Data skickas till Internet som det är.
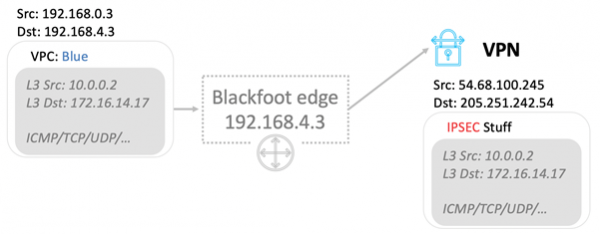
Data dekapslas och kapslas in i en IPsec-wrap vid användning av VPN.
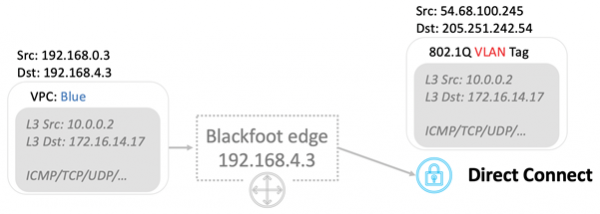
Vid användning av Direct Connect taggas trafiken och överförs till motsvarande VLAN.
HyperPlane
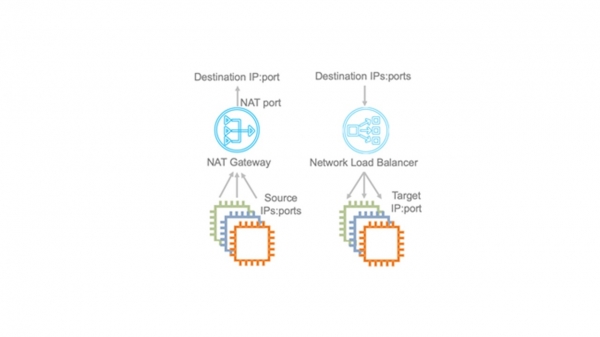
Detta är en intern flödeskontrolltjänst. Många nätverkstjänster kräver kontroll av statusen för datatrafiken. Till exempel, vid användning av NAT måste flödeskontrollen säkerställa att varje par "IP: destinationport" motsvarar en unik utgående port. Vid en balanslösare NLB — Nätverksbelastningsbalanserare, måste datatrafiken alltid styras till samma mål virtuella maskin. Security Groups är en brandvägg med statusbevarande. Den övervakar inkommande trafik och öppnar obemärkt portar för utgående datapaket.
I AWS-molnet är kraven på överföringsfördröjningar extremt höga. Därför HyperPlane är kritiska för hela nätverks funktionalitet.
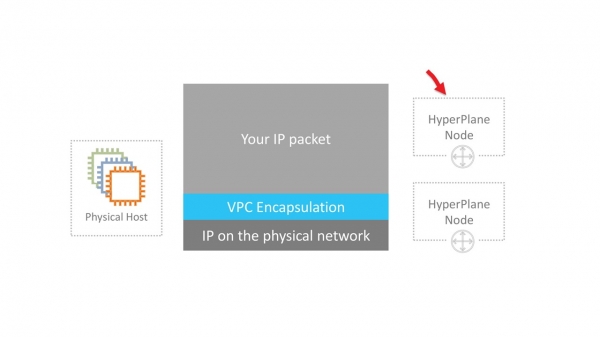
Hyperplane är byggd på EC2-maskiner. Här finns ingen magi, bara knep. Knepet är att det är virtuella maskiner med stor RAM. Transaktionerna är endast genomförda i minnet. Detta möjliggör fördröjningar på bara några tiotal mikrosekunder. Arbete med disk skulle krossa all prestanda.
Hyperplane är ett distribuerat system av enorma mängder sådana EC2-maskiner. Varje virtuell maskin har en bandbredd på 5 GB/s. På regional nätverksnivå ger detta galna terabitar av bandbredd och möjliggör hantering av miljoner anslutningar per sekund.
HyperPlane fungerar endast med strömmar. VPC-kapslar paket är helt transparenta för den. Potentiell sårbarhet i denna interna tjänst skulle ändå inte tillåta att bryta isoleringen av VPC. Säkerheten ansvarar för lagren nedanför.
Noisy neighbor
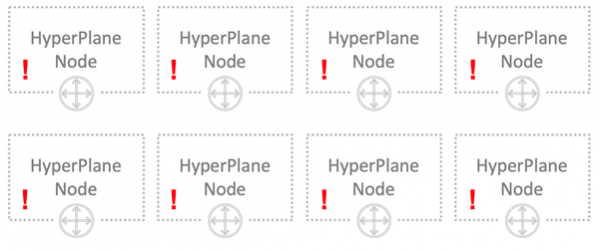
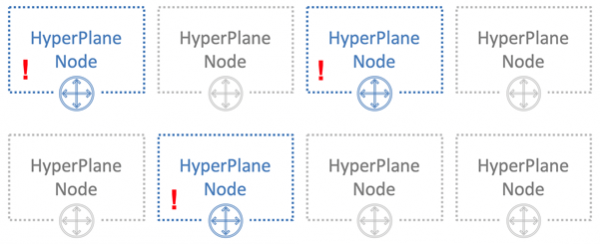
Det finns också ett problem med den bullriga grannen — noisy neighbor. Anta att vi har 8 noder. Dessa noder hanterar strömmar från alla användare i molnet. Allt verkar bra och belastningen borde spridas jämnt över alla noder. Noderna är mycket kraftfulla och det är svårt att överbelasta dem.
Men vi bygger vår arkitektur med tanke på även de osannolika scenarierna.
En låg sannolikhet betyder inte omöjlighet.
Vi kan föreställa oss en situation där en eller flera användare genererar en för stor belastning. Denna belastning involverar alla HyperPlane-noder, och andra användare kan potentiellt märka en viss minskning i prestanda. Detta bryter mot konceptet av molnet, där hyresgästerna inte har möjlighet att påverka varandra.
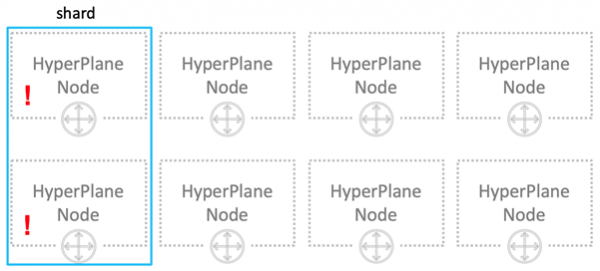
Hur löser vi problemet med den bullriga grannen? Det första som kommer att tänka på är sharding. Våra 8 noder delas logiskt upp i 4 shards med 2 noder i varje. Nu stör den bullriga grannen bara en fjärdedel av alla användare, men det stör kraftigt.
Låt oss göra på ett annat sätt. Vi ger varje användare bara 3 noder.
Tricket är att tilldela noder till olika användare slumpmässigt. I bilden nedan korsar den blå användaren noder med en av de två andra användarna — den gröna och den orangea.
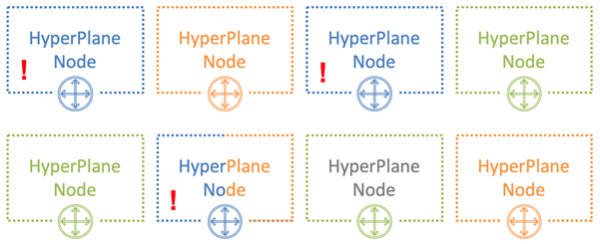
Med 8 noder och 3 användare är sannolikheten för att den bullriga grannen korsar en av användarna 54 %. Med en sådan sannolikhet kommer den blå användaren att påverka andra hyresgäster. Och detta endast med en del av sin belastning. I vårt exempel kommer denna påverkan att endast vara märkbar för en tredjedel av alla användare. Det är redan ett bra resultat.
Antal användare som korsar
Sannolikhet i procent
0
18%
1
54%
2
26%
3
2%
Låt oss närma oss situationen mer verklighetstroget - vi tar 100 noder och 5 användare på 5 noder. I detta fall korsar ingen av noderna varandra med en sannolikhet på 77 %.
Antal användare som korsar
Sannolikhet i procent
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
I en verklig situation, med ett stort antal HyperPlane-noder och användare, är den potentiella påverkan från den bullriga grannen på andra användare minimal. Denna metod kallas shuffle sharding — . Den minimerar den negativa effekten av att noder går ner.Många tjänster är byggda på HyperPlane: Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
Nätverksstorlekar
nätverksstorlek
Låt oss nu prata om storleken på nätverket. I oktober 2019 erbjuder AWS sina tjänster i 22 regioner, och ytterligare 9 är planerade.
- Varje region innehåller flera tillgänglighetszoner — Availability Zone. Totalt finns det 69 världen över.
- Varje AZ består av datacenter. Totalt finns det högst 8.
- Det finns ett enormt antal servrar i datacentren, i vissa fall upp till 300 000.
Nu ska vi jämföra allt detta, multiplicera och få fram en imponerande siffra som visar på skalan av Amazon-molnet..
Mellan tillgänglighetszonerna och datacentren finns det många optiska kanaler. I en av våra största regioner har vi bara för att kommunicera AZ med varandra och med kommunikationscentraler i andra regioner (Transit Centers) 388 kanaler. Totalt ger det galna 5000 Tbps..
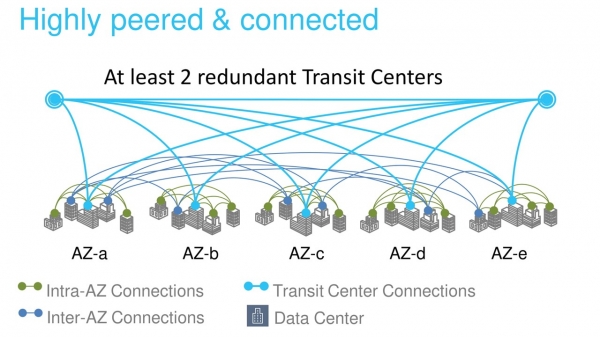
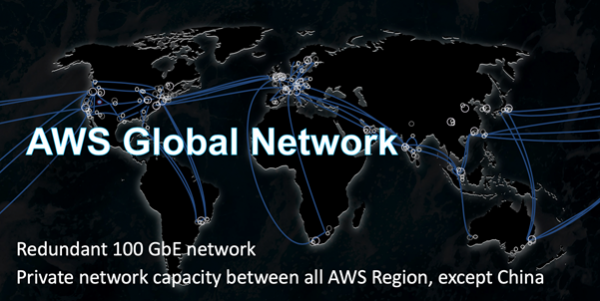
AWS:s backbone är byggd speciellt för molnet och är optimerad för att fungera med det. Vi bygger den på kanaler med 100 Gbps.. Vi kontrollerar dem helt, förutom i regionerna i Kina. Trafiken blandas inte med belastningen från andra företag.
Självklart är vi inte den enda molntjänstleverantören med ett privat backbone-nätverk. Fler och fler stora företag följer samma väg. Det bekräftas av oberoende forskare, som de från .
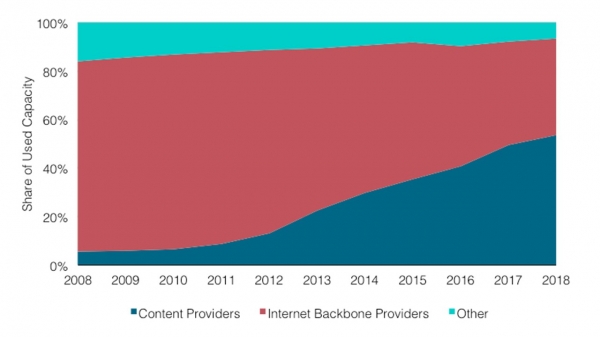
Grafen visar att andelen innehållsleverantörer och molnleverantörer ökar. På grund av detta minskar andelen Internet-trafik från backbone-leverantörer ständigt.
Jag ska förklara varför detta händer. Tidigare var de flesta webbtjänster tillgängliga och konsumerades direkt från Internet. Nu finns det allt fler servrar i molnet som är tillgängliga via CDN — Content Distribution Network.För att nå resursen går användaren genom Internet endast till närmaste CDN PoP — Point of Presence.Oftast ligger det någonstans nära. Därefter lämnar det den offentliga Internet och åker genom privat backbone, till exempel över Atlanten, och når direkt resursen.
Det är intressant att fundera på hur Internet kommer att se ut om 10 år om denna trend fortsätter.
Fysiska kanaler.
Forskare har än så länge inte kommit på hur man kan öka ljusets hastighet i universum, men har gjort stora framsteg inom metoder för att överföra det genom fiberoptik. Nu använder vi kablar med 6912 fiber. Detta hjälper till att avsevärt optimera kostnaden för deras installation.
I vissa regioner måste vi använda speciella kablar. Till exempel, i regionen Sydney använder vi kablar med ett speciellt skydd mot termiter.
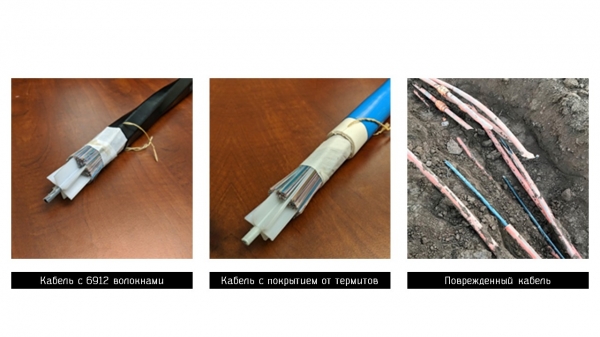
Ingen är immun mot olyckor, och ibland skadas våra kanaler. På bilden till höger ser vi optiska kablar i en av de amerikanska regionerna som skadades av byggarbetare. Som ett resultat av olyckan förlorades endast 13 datapaket, vilket är imponerande. Återigen – bara 13! Systemet växlade bokstavligen omedelbart till reservkanalerna – skalan fungerar.
Vi har hastigt gått igenom några av Amazon Cloud-tjänsterna och teknologierna. Jag hoppas att du har fått åtminstone en viss förståelse för de omfattande uppgifter våra ingenjörer måste lösa. Personligen tycker jag att det är mycket fascinerande.
Detta är den sista delen av trilogin av Vasily Pantiukhin om AWS-infrastrukturen. I delen beskrivs optimering av servrar och skalning av databaser, och i — serverless-funktioner och Firecracker.
På I november kommer Vasily Pantiukhin att dela med sig av nya detaljer om Amazons infrastruktur. Han kommer att diskutera orsakerna till driftstopp och design av distribuerade system på Amazon. Fram till den 24 oktober kan du fortfarande köpa en biljett till ett bra pris, och betala senare. Vi ser fram emot att träffa dig på HighLoad++, kom förbi – vi kan prata!
Källa: habr.com
