

För att börja, lite teori. Vad är ?
Enkelt uttryckt, det här är ett dokument som syftar till att förenkla utvecklingen av SaaS-applikationer. Det hjälper genom att informera utvecklare och DevOps-ingenjörer om de problem och bästa praxis som oftast förekommit i utvecklingen av moderna applikationer.
Dokumentet har skapats av utvecklarna på plattformen Heroku.
Tolvfaktormetodologin (The Twelve-Factor App) kan tillämpas på applikationer skrivna i vilket programmeringsspråk som helst och som använder alla möjliga kombinationer av externa tjänster (backing services) (databaser, meddelandeköer, cache-minnen, etc.).
Kort om de faktorer som denna metodologi bygger på:
- Kodbasis – En kodbas, spårad i versionskontrollsystem, – flera distributioner
- Beroenden – Deklarera och isolera beroenden tydligt
- Konfiguration – Spara konfigurationen i körmiljön
- Externa tjänster (Backing Services) – Betänk externa tjänster (backing services) som anslutna resurser
- Byggande, distribution, körning – Strikt åtskiljning av bygg- och körsteget
- Processer – Kör applikationen som en eller flera processer som är stateless
- Portbindning (Port binding) – Exportera tjänster via portbindning
- Parallellism – Skala applikationen med hjälp av processer
- Avyttring (Disposability) – Maximera tillförlitlighet genom snabb start och korrekt stängning
- Paritet mellan utveckling och produktion – Håll utvecklings-, staging- och produktionsmiljöerna så lika som möjligt
- Loggning (Logs) – Betänk loggen som en ström av händelser
- Administrationsuppgifter – Utför administrationshantering med hjälp av enstaka processer
Mer information om de 12 faktorerna kan du få från följande resurser:
- — ett måste att läsa
- — officiell översättning
- — en ny blick på 12 faktorer för att förbättra dem.
Vad är Blue-Green deployment?
Blue-Green deployment är ett sätt att leverera applikationen production på ett sätt som slutar användaren inte ser några förändringar från sin sida. Med andra ord, distributionen av applikationen med noll dödtid.
Den klassiska schemat för BG Deploy ser ut som på bilden nedan.

- I början finns det 2 fysiska servrar med exakt samma kod, applikation, projekt och det finns en router (lastbalanserare).
- Routern riktar ursprungligen alla förfrågningar till en av servrarna (grön).
- Vid den tidpunkten då en ny release behöver göras, uppdateras hela projektet på den andra servern (blå), som för närvarande inte behandlar några förfrågningar.
- Efter att koden på den blå servern är helt uppdaterad, får routern kommandot att växla från den gröna till blå server.
- Nu ser alla kunder resultatet av koden från den blå servern.
- Under en tid fungerar grön servern som en reserv på fall att distributionen på blå servern misslyckas och vid eventuella fel, växlar routern användarflödet tillbaka till grön servern med den gamla stabila versionen, medan den nya koden skickas för omarbete och testning.
- Slutligen uppdateras även grön servern. Och efter dess uppdatering växlar routern användarflödet tillbaka till grön server.
Det hela ser väldigt bra ut och vid första anblicken borde det inte vara några problem.
Men eftersom vi lever i en modern värld, så passar inte alternativet med fysisk växling som anges i den klassiska schemat oss. Håll denna information i åtanke, vi återkommer till den senare.
Dåliga och bra råd
Ansvarsfriskrivning: I exemplen nedan anges verktyg / metoder som jag använder, du kan använda absolut vilka alternativ som helst med liknande funktioner.
Större delen av exemplen kommer på ett eller annat sätt att överlappa med webbutveckling (överraskning), med PHP och Docker.
I punkterna nedan ges en enkel praktisk beskrivning av användning av faktorer med specifika exempel; om du vill ha mer teori om detta ämne, hänvisa till källorna ovan.
1. Kodbas
Använd FTP och FileZilla för att ladda upp filer till servrarna en i taget, lagra inte koden någon annanstans än på produktionsservern.
Projektet ska alltid ha en enhetlig kodbas, det vill säga, all kod kommer från en och samma Git repositories. Servrarna (production, staging, test1, test2 …) använder kod från grenar i ett gemensamt repository. På så sätt uppnår vi kodens konsekvens.
2. Berättelser
Ladda ner alla bibliotek i mappar direkt till rotmappen av projektet. Uppdateringar görs genom att helt enkelt flytta ny kod till mappen med den aktuella versionen av biblioteket. Installera alla nödvändiga verktyg direkt på värdservern där 20 andra tjänster redan körs.
Projektet bör alltid ha en tydlig och begriplig lista över beroenden (med beroenden menar jag även miljön). Alla beroenden måste vara tydligt definierade och isolerade.
Som exempel tar vi Composer och Docker.
Composer — en pakethanterare som gör det möjligt att installera PHP-bibliotek. Composer ger möjlighet att strikt eller mer avslappnat ange versioner och definiera dem tydligt. Det kan finnas 20 olika projekt på servern och varje projekt har sin egen lista över paket och bibliotek som inte påverkar varandra.
Docker — ett verktyg som möjliggör att definiera och isolera miljön där applikationen kommer att köras. På liknande sätt som med Composer, men mer grundligt, kan vi definiera vad applikationen arbetar med. Välja en specifik PHP-version, installera endast de paket som är nödvändiga för projektets arbete utan att lägga till något extra. Och viktigast av allt, inte korsa med paketen och miljön för värdmaskinen och andra projekt. Det vill säga, alla projekt på servern som körs via Docker, kan använda vilken uppsättning paket som helst och en helt annan miljö.
3. Konfiguration
Spara konfigurationerna som konstanter direkt i koden. Separata konstanter för testservern och separata för produktionen. Koppla ihop applikationens arbete med miljön direkt i affärslogiken i projektet med hjälp av if-else-konstruktioner.
Konfigurationer — är det enda som ska skilja mellan projektets distributioner (deployment). I idealfallet bör konfigurationer överföras via miljövariabler (env vars).
Det vill säga, även om du lagrar flera konfigurationsfiler .config.prod .config.local och byter namn på dem vid distribution till .config (huvudkonfigurationen som används av applikationen för att läsa data) — så är det fortfarande en felaktig metod, eftersom informationen från konfigurationerna då blir allmänt tillgänglig för alla utvecklare av applikationen och data från produktionsservern kommer att bli komprometterade. Alla konfigurationer ska lagras direkt i distributionssystemet (CI/CD) och genereras för olika miljöer med olika värden som krävs för en specifik miljö just vid distribution.
4. Tredjepartstjänster (Backing Services)
Bind dig hårt till miljön, använd olika anslutningar för samma tjänster i specifika miljöer.
Detta punkt överlappar mycket med punkten om konfigurationer, eftersom utan denna punkt är det omöjligt att skapa ordentliga konfigurationsdata, och möjlighet till konfiguration skulle helt försvinna.
Alla anslutningar till externa tjänster såsom kö-servrar, databaser och cache-tjänster bör vara enhetliga för både den lokala miljön och den externa/produktionsmiljön. Med andra ord, jag kan när som helst ändra anslutningssträngen för att byta från databas #1 till databas #2 utan att behöva ändra på applikationens kod. Som ett exempel, vid skalning av tjänsten behöver du inte ange en speciell anslutning för den extra cache-servern.
5. Bygg, release, körning
Ha endast den färdiga versionen av koden på servern, utan möjlighet att rulla tillbaka en release. Det handlar om att inte belasta lagringsutrymmet. Den som tror att de kan skicka kod till produktion med ett fel är en dålig programmerare!
Alla steg i distributionen bör vara separerade från varandra.
Ha möjlighet att rulla tillbaka. Gör releaser med snabba kopior av applikationen (redan byggda och klara för produktion) så att du kan återställa en gammal version om fel uppstår. Det finns alltså en mapp releases och en mapp current, och efter en lyckad distribution och byggning kopplas mappen current via en symbolisk länk till den nya releasen som ligger inuti releases med ett hypotetiskt versionsnummer.
Här påminner vi om Blue-Green deployment, som inte bara gör det möjligt att växla mellan kod, utan också mellan alla resurser och till och med miljöer med möjlighet att rulla tillbaka allt.
6. Processer
Spara tillståndsdata för applikationen direkt i själva applikationen. Använd sessioner i applikationens minne. Använd så många delade resurser mellan externa tjänster som möjligt. Bind dig vid att applikationen kan ha endast en process och tillåt inte skalning.
När det gäller sessioner, spara data endast i cache som kontrolleras av externa tjänster (memcached, redis), så att även om du har 20 applikationsprocesser igång, kan vilken som helst av dem, när den kontaktar cachen, fortsätta arbeta med klienten i samma tillstånd som användaren var i när denne arbetade med applikationen i en annan process. Med detta tillvägagångssätt fungerar det så att ju fler kopior av externa tjänster du använder, desto mer problemfritt kommer allt att fungera utan problem med datåtkomst.
7. Portbindning (Port binding)
Det är bara webbservern som ska veta hur man arbetar med externa tjänster. Det är ännu bättre att driva externa tjänster direkt inuti webbservern. Till exempel som en PHP-modul i Apache.
Alla dina tjänster bör vara tillgängliga för varandra genom att kontakta någon adress och port (localhost:5432, localhost:3000, nginx:80, php-fpm:9000), det vill säga från nginx kan jag få tillgång till både php-fpm och postgres, och från php-fpm till postgres och nginx, och i själva verket från varje tjänst kan jag få tillgång till en annan tjänst. På så sätt beror livskraften hos en tjänst inte på livskraften hos en annan.
8. Parallellism
Arbeta med en enda process, annars kanske flera processer inte kan samarbeta!
Lämna utrymme för skalning. Perfekt för detta är docker swarm.
Docker Swarm är ett verktyg för att skapa och hantera kluster av containrar både mellan olika maskiner och en mängd containrar på en och samma maskin.
Genom att använda swarm kan jag bestämma hur många resurser jag ska tilldela varje process och hur många processer av samma tjänst jag ska starta. Den interna lastbalanseraren tar emot data på den angivna porten och kommer automatiskt att proxy till processerna. Om jag ser att belastningen på servern har ökat kan jag lägga till fler processer för att därigenom minska belastningen på vissa processer.
9. Utslippbarhet (Disposability)
Använd inte köer för att hantera processer och data. Att avsluta en process ska påverka hela applikationen. Om en tjänst faller, faller allt.
Varje process och tjänst kan stängas av vilket ögonblick som helst utan att det påverkar andra tjänster (det handlar inte om att en tjänst blir otillgänglig för en annan tjänst, utan om att en annan tjänst inte ska stängas av ihop med denna). Alla processer bör avslutas mjukt, så att inga data skadas vid avslutningen och systemet fungerar korrekt vid nästa start. Även vid en nödstängning ska inga data skadas (detta åstadkommes med hjälp av transaktionsmekanismer, databasfrågor fungerar endast i grupper, och om någon fråga i gruppen misslyckas eller ger ett fel, ska ingen annan fråga i gruppen faktiskt köras).
10. Paritet mellan utveckling och drift av applikationen
Produktions-, staging- och lokalversionen av applikationen bör vara olika. I produktion använder vi Yii Lite-ramverket, medan vi lokalt använder Yii, för att det fungerar snabbare i produktion!
I verkligheten bör alla distributioner och kodhanteringar ske i nästan identiska miljöer (det handlar inte om fysisk hårdvara). Dessutom bör alla anställda inom utvecklingen kunna distribuera koden i produktion vid behov, inte en särskilt utbildad devops-avdelning som endast kan starta applikationen i produktion tack vare särskild kompetens.
Detta stöds också av Docker. Genom att följa alla föregående punkter kommer användningen av Docker att göra distributionsprocessen inom både produktion och lokal maskin så enkel som att köra ett par kommandon.
11. Loggning (Logs)
Vi skriver loggar i filer och databaser! Vi rensar inte filer och databaser från loggar. Vi köper bara en hårddisk på 9000 petabyte och det är bra.
Alla loggar bör ses som en ström av händelser. Själva applikationen ska inte hantera loggar. Loggar ska antingen skickas till stdout eller över ett protokoll som udp, så att hanteringen av loggar inte stör applikationen. Graylog är ett bra alternativ för detta. Graylog tar emot alla loggar via udp (för detta protokoll behövs inget svar på att paketet har tagits emot) och stör därmed inte applikationen, utan hanterar endast struktureringen och behandlingen av loggar. Applikationens logik förändras inte för att arbeta med sådana metoder.
12. Administrationsuppgifter
För att uppdatera data, databasen, etc. använd en separat skapad endpoint i API:t, vars körning två gånger i rad kan resultera i att allt dupliceras. Men ni är ju inte dumma och trycker inte två gånger, och vi behöver inga migrationer.
Alla administrationsuppgifter måste utföras i samma miljö som hela koden, på versionsnivå. Så om vi behöver ändra databassens struktur, ska vi inte göra det manuellt genom att ändra kolumnnamn och lägga till nya genom någon visuell databasverktyg. För sådana saker skapar vi separata skript — migrationer, som körs på alla miljöer med ett enhetligt och tydligt resultat. För alla andra uppgifter, som att fylla projektet med data, bör liknande metoder tillämpas.
Exempel på implementation med PHP, Laravel, Laradock, Docker-Compose
P.S. Alla exempel gjordes på MacOS. Största delen fungerar även för Linux. Användare av Windows, ber om ursäkt, men jag har inte arbetat med Windows på länge.
Låt oss föreställa oss en situation där vi inte har installerat någon version av PHP på vår dator och inte har något alls.
Vi installerar de senaste versionerna av docker och docker-compose. (detta kan hittas på internet)
docker -v &&
docker-compose -v
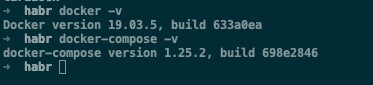
1. Vi installerar
git clone https://github.com/Laradock/laradock.git &&
ls
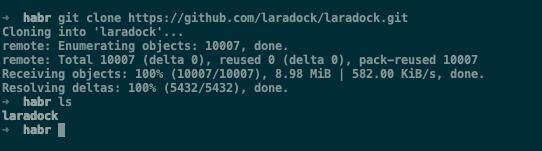
När det gäller Laradock kan jag säga att det är en riktigt bra grej som samlar många containrar och hjälpfunktioner. Men att använda Laradock utan modifieringar i produktion — skulle jag inte rekommendera på grund av dess överflödighet. Det är bättre att skapa egna containrar baserat på exemplen i Laradock, så kan man optimera, eftersom ingen behöver allt som finns där samtidigt.
2. Vi konfigurerar Laradock för att arbeta med vår applikation.
cd laradock &&
cp env-example .env
2.1. Öppna katalogen habr (föräldramappen där laradock har klonats) i en valfri editor. (I mitt fall PHPStorm)
I det här steget ger vi bara projektet ett namn.
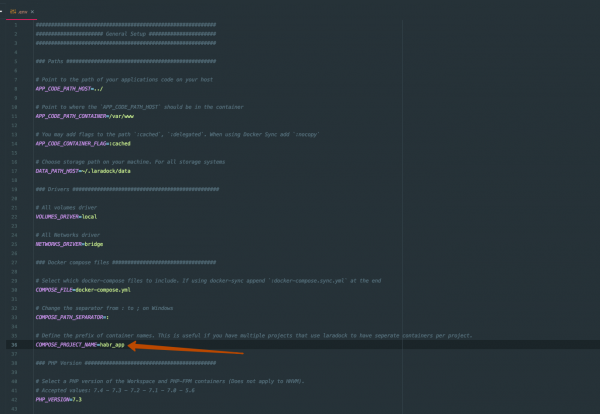
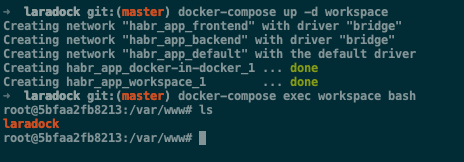
2.2. Starta bilden för workspace. (I ditt fall kommer bilderna att byggas under en tid)
Workspace är en särskilt förberedd bild för arbete med ramverket från utvecklarens sida.
Gå in i containern med hjälp av
docker-compose up -d workspace &&
docker-compose exec workspace bash
2.3. Installera Laravel
composer create-project --prefer-dist laravel/laravel application 
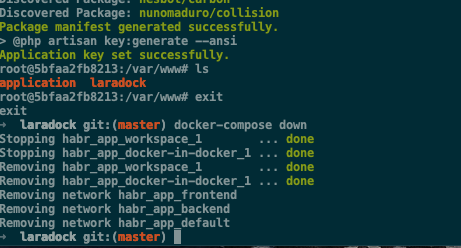
2.4. Efter installationen kontrollerar vi om katalogen med projektet har skapats, och tar ner compose.
ls
exit
docker-compose down
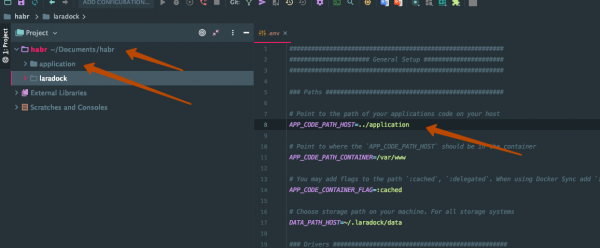
2.5. Återgå till PHPStorm och ange rätt sökväg till vår laravel-applikation i filen .env.
3. Låt oss lägga till hela koden i Git.
För detta ändamål skapar vi ett repository på Github (eller någon annanstans). Gå till katalogen habr i terminalen och kör följande kod.
echo "# habr-12factor" >> README.md
git init
git add README.md
git commit -m "första commit"
git remote add origin git@github.com:nzulfigarov/habr-12factor.git # här kommer länken till ditt repo
git push -u origin master
git status
Kontrollera att allt är i sin ordning.
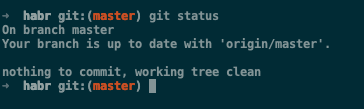
För bekvämlighetens skull rekommenderar jag att använda något visuellt gränssnitt för Git, i mitt fall är det . (här är en referralslänk)
4. Starta!
Innan du startar, se till att ingenting körs på port 80 och 443.
docker-compose up -d nginx php-fpm 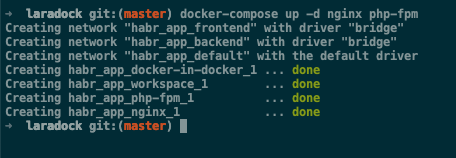
Därmed består vårt projekt av 3 separata tjänster:
- nginx — webserver
- php-fpm — php för att ta emot förfrågningar från webservern
- workspace — php för utvecklaren
För tillfället har vi uppnått det att vi har skapat en applikation motsvarande redan 4 punkter av 12, nämligen:
1. Kodbasis — All kod ligger i ett repository (en liten kommentar: det kan vara bättre att föra in docker i projektet laravel, men det är inte avgörande).
2. Beroenden — Alla våra beroenden är tydligt angivna i application/composer.json och i varje Dockerfile för varje container.
3. Externa tjänster (Backing Services) — Varje tjänst (php-fpm, nginx, workspace) lever sitt eget liv och är uppkopplad utifrån, och när man arbetar med en tjänst påverkas ingen annan.
4. Processer — varje tjänst är en process. Ingen av tjänsterna sparar ett internt tillstånd.
5. Portbindning (Port binding)
docker ps
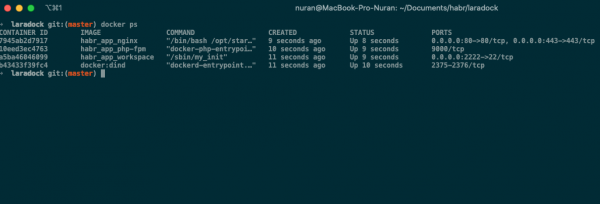
Som vi ser, varje tjänst körs på sin egen port och är tillgänglig för alla andra tjänster.
6. Parallellism
Docker tillåter oss att starta flera processer av samma tjänster med automatisk lastbalansering mellan dem.
Vi stoppar containrarna och startar dem med en flagga —scale
docker-compose down &&
docker-compose up -d --scale php-fpm=3 nginx php-fpm
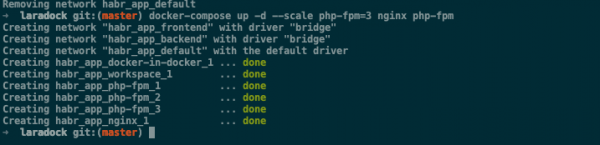
Som vi ser, har php-fpm-containern skapat kopior. Vi behöver inte ändra något i arbetet med denna container. Vi fortsätter också att kommunicera med den via port 9000, och Docker hanterar belastningen mellan containrarna åt oss.
7. Avyttring (Disposability) — varje container kan stoppas utan att påverka de andra. Stängning eller omstart av en container påverkar inte applikationens arbete vid framtida lanseringar. Varje container kan också startas när som helst.
8. Paritet mellan utveckling och produktion — alla våra miljöer är identiska. När du kör systemet på en server i produktion behöver du inte ändra något i dina kommandon. Allt kommer att baseras på Docker på exakt samma sätt.
9. Loggning (Logs) — alla loggar i dessa containrar strömmas och visas i Docker-konsolen. (i detta fall, i verkligheten, kan det vara annorlunda med andra anpassade containrar om du inte tar hand om det)
docker-compose logs -f 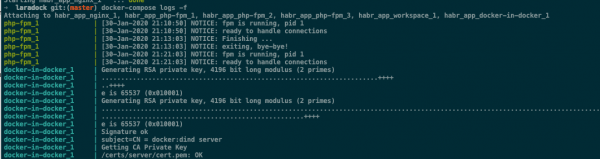
Men här finns det en hake: Standardvärdena i PHP och Nginx skriver också loggar i filen. För att uppfylla 12-faktorprinciperna är det nödvändigt stänga av att loggar skrivs till filer i konfigurationerna för varje container individuellt.
Docker erbjuder även möjligheten att rikta loggar inte bara till stdout, utan också till saker som graylog som jag nämnde ovan. Inom graylog kan vi hantera loggarna på valfritt sätt, och vår applikation kommer inte att märka något.
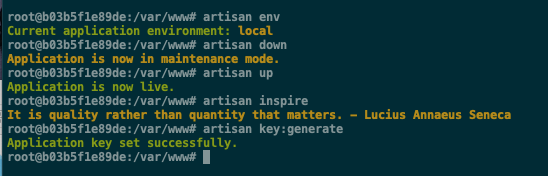
10. Administrationsuppgifter — alla administrationsuppgifter löses av laravel tack vare verktyget artisan precis som skaparna av 12-faktorapplikationen skulle vilja.
Som exempel visar jag hur några kommandon utförs.
Vi går in i containern.
docker-compose exec workspace bash
php artisan list

Nu kan vi använda vilket kommando vi vill. (Observera att vi inte har konfigurerat databasen och cachen, så hälften av kommandona kommer inte att fungera korrekt, eftersom de är avsedda för arbete med cache och databasen).
11. Konfigurationer och 12. Byggande, distribution, körning
Den här delen ville jag ägna åt Blue-Green Deployment, men det visade sig vara för omfattande för denna artikel. Jag kommer att skriva en separat artikel om detta.
I korthet bygger konceptet på CI/CD-system som Jenkins och Gitlab CI. I båda kan man ställa in miljövariabler kopplade till en specifik miljö. Därmed kommer punkt med Konfigurationer.
Och punkten om Byggande, distribution, körning löses av inbyggda funktioner i båda verktygen som kallas Pipeline.
Pipeline möjliggör att dela in deploymentsprocessen i flera steg, där bygg-, release- och körningsfaserna framhävs. I Pipeline kan du också skapa backup och faktiskt allt möjligt. Detta verktyg har en oändlig potential.
Kodbasen för applikationen ligger på .
Kom ihåg att initialisera submodulen när du klonar detta repository.
P.S.: Alla dessa tillvägagångssätt kan användas med andra verktyg och programmeringsspråk. Det viktigaste är att kärnan inte skiljer sig.
Källa: habr.com
