

Hej, Habr! Jag heter Artyom Karamyshev och är chef för systemadministrationsteamet . Under det senaste året har vi haft många lanseringar av nya produkter. Vi vill att API-tjänsterna ska vara lätta att skala, vara motståndskraftiga och redo för snabb ökning av användarbelastningen. Vår plattform är baserad på OpenStack, och jag vill berätta om vilka problem med komponenternas motståndskraft vi behövde lösa för att få en robust system. Jag tror att detta kommer att vara intressant för dem som också utvecklar produkter på OpenStack.
Den totala motståndskraften hos plattformen består av motståndskraften hos dess komponenter. Så vi kommer gradvis att gå igenom alla nivåer där vi har upptäckt risker och åtgärdat dem.
Videoversionen av denna historia, som har sitt ursprung i en presentation på konferensen Uptime Day 4, organiserad av , kan ses .
Motståndskraft hos den fysiska arkitekturen
Den offentliga delen av MCS-molnet är för närvarande baserad i två Tier III-datacenter, mellan dem finns egen mörk fiber som är reserverad på fysisk nivå med olika spår, med en kapacitet på 200 Gbit/s. Tier III-nivån ger den nödvändiga motståndskraften för den fysiska infrastrukturen.
Den mörka fibern är reserverad både på fysisk och logisk nivå. Processen för reservkanaler var iterativ, vi stötte på problem och vi förbättrar ständigt kommunikationen mellan datacentren.
Till exempel, för inte så länge sedan, under arbete i en brunn nära ett av datacentren, träffade en grävmaskin röret, och både huvud- och reserv optisk fiberkabel hamnade i denna rörledning. Vår motståndskraftiga kommunikationskanal med datacenter var sårbar vid en punkt, i brunnen. Därför förlorade vi en del av infrastrukturen. Vi drog slutsatser, vidtog en rad åtgärder, inklusive att vi lade en extra optisk fiber genom den närliggande brunnen.
I datacentren finns det punkter där leverantörer av kommunikation har närvaro, till vilka vi sänder våra prefix via BGP. För varje nätverksriktning väljs den bästa metrik, vilket gör att vi kan erbjuda olika kunder den bästa kvalitén på anslutningen. Om en förbindelse via en leverantör bryts, omkonfigurerar vi vår routing via tillgängliga leverantörer.
Vid ett leverantörsfel växlar vi automatiskt till nästa. Om ett av datacentren slutar fungera har vi en spegelkopi av våra tjänster i det andra datacentret, som tar hela belastningen.
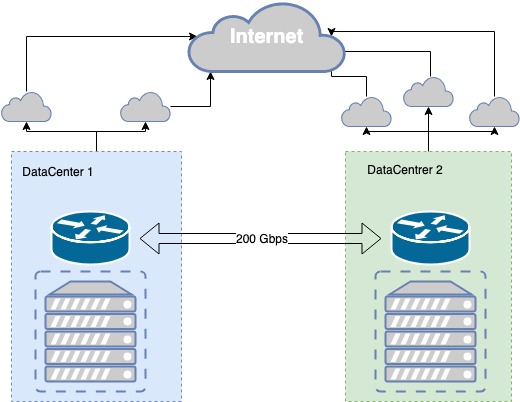
Felutställning av fysisk infrastruktur
Vad vi använder för felutställning på applikationsnivå
Vår tjänst är byggd på en rad öppna komponenter.
ExaBGP — en tjänst som implementerar en rad funktioner med hjälp av protokollet för dynamisk routing baserat på BGP. Vi använder den aktivt för att annonsera våra vita IP-adresser, genom vilka användare får tillgång till API:t.
HAProxy — en högbelastad balans- re är, som möjliggör mycket flexibla regler för trafikbalansering på olika nivåer av OSI-modellen. Vi använder den för att balansera framför alla tjänster: databaser, meddelandehanterare, API-tjänster, webb-tjänster, våra interna projekt — allt står bakom HAProxy.
API-applikation — en webbapplikation skriven i Python, med vilken användaren hanterar sin infrastruktur och sina tjänster.
Arbetarapplikation (härefter bara worker) — i OpenStack-tjänster är det en infrastrukturdemon som gör det möjligt att överföra API-kommandon till infrastrukturen. Till exempel sker skapandet av disk just i worker, medan begäran om skapande görs i API-applikationen.
Standardarkitektur för OpenStack-applikationer
De flesta tjänster som utvecklas för OpenStack försöker följa en enhetlig paradigm. Tjänsten består vanligtvis av två delar: API och arbetare (backend-executors). I allmänhet är API:et en WSGI-applikation i Python som antingen körs som en fristående process (demon) eller via en redan etablerad webbserver som Nginx eller Apache. API:et behandlar användarens förfrågan och vidarebefordrar instruktionerna till arbetarapplikationen för utförande. Överföringen sker med hjälp av en meddelandebroker, vanligtvis RabbitMQ, medan andra stöds dåligt. När meddelandena når brokern behandlas de av arbetarna och, om det behövs, returnerar de ett svar.
Denna paradiigm innebär isolerade gemensamma felpunkter: RabbitMQ och databasen. Men RabbitMQ är isolerat inom ramen för en tjänst och kan i teorin vara individuellt för varje tjänst. Så vi på MCS separerar dessa tjänster så mycket som möjligt, för varje separat projekt skapar vi en separat databas och en separat RabbitMQ. Denna metod har den fördelen att om det uppstår en nödsituation på något sårbart ställe, så bryts inte hela tjänsten utan bara en del av den.
Antalet arbetarapplikationer är oändligt, så API:et kan enkelt skalas horisontellt bakom belastningsbalanserare för att öka prestandan och redundansen.
I vissa tjänster krävs koordinering inom tjänsten — när komplexa sekventiella operationer uppstår mellan API och arbetare. I dessa fall används ett centralt koordinationssystem, en klusterlösning som Redis, Memcache, etcd, som tillåter en arbetare att informera en annan om att en uppgift är tilldelad honom ("Tack, ta inte den här"). Vi använder etcd. Arbetarna kommunicerar vanligtvis aktivt med databasen, skriver och läser information därifrån. Som databas använder vi MariaDB, som vi har i en multimaster-kluster.
Sådan en klassisk ensam tjänst är organiserad på ett allmänt accepterat sätt för OpenStack. Den kan betraktas som ett slutet system, för vilket skalnings- och redundantlösningarna är ganska uppenbara. Till exempel, för redundans är det tillräckligt att sätta en belastningsbalanserare framför API:et. Skalningen av arbetarna uppnås genom att öka deras antal.
En svaghet i hela systemet är RabbitMQ och MariaDB. Deras arkitektur förtjänar en egen artikel. I den här artikeln vill jag fokusera på API:ns felbeständighet.
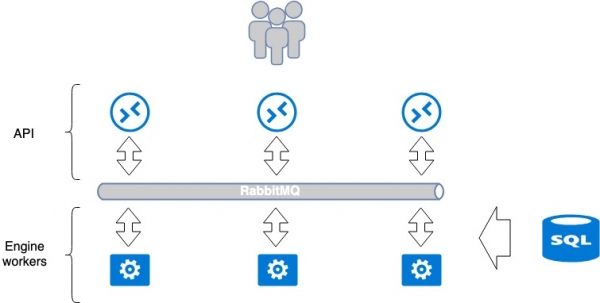
Arkitektur för OpenStack-applikationen. Belastningsbalansering och felbeständighet för molnplattformen.
Vi gör HAProxy-belastningsbalanseraren felbeständig med hjälp av ExaBGP.
För att våra API:er ska vara skalbara, snabba och felbeständiga installerade vi en belastningsbalanserare. Vi valde HAProxy. Enligt min åsikt har den alla nödvändiga egenskaper för vår uppgift: belastningsbalansering på flera OSI-nivåer, hanteringsgränssnitt, flexibilitet och skalbarhet, många belastningsbalanseringsmetoder och stöd för sessions-tabeller.
Det första problemet som måste lösas är felbeständigheten hos själva belastningsbalanseraren. Att bara installera en belastningsbalanserare skapar också en punktsvaghet: om belastningsbalanseraren går sönder, faller tjänsten. För att undvika detta använde vi HAProxy tillsammans med ExaBGP.
ExaBGP möjliggör implementering av en tjänstehälsokontroll. Vi använde denna mekanism för att kontrollera HAProxy:s funktionalitet och stänga av HAProxy-tjänsten från BGP vid problem.
Diagram över ExaBGP+HAProxy
- Vi installerar den nödvändiga programvaran, ExaBGP och HAProxy, på tre servrar.
- På varje server skapar vi en loopback-gränssnitt.
- Vi konfigurerar samma offentliga IP-adress på detta gränssnitt på alla tre servrar.
- Den offentliga IP-adressen annonseras på internet via ExaBGP.
Felbeständighet uppnås genom att annonsera samma IP-adress från alla tre servrar. Från nätverkets synvinkel är samma adress tillgänglig från tre olika nästa hopp. Routern ser tre identiska rutter, väljer den mest prioriterade baserat på sin egen metric (detta är oftast samma alternativ), och trafiken går endast till en av servrarna.
Vid problem med HAProxy eller en server som går ner slutar ExaBGP annonsera rutten, och trafiken växlar smidigt till en annan server.
På så sätt har vi uppnått felbeständighet för belastningsbalanseraren.
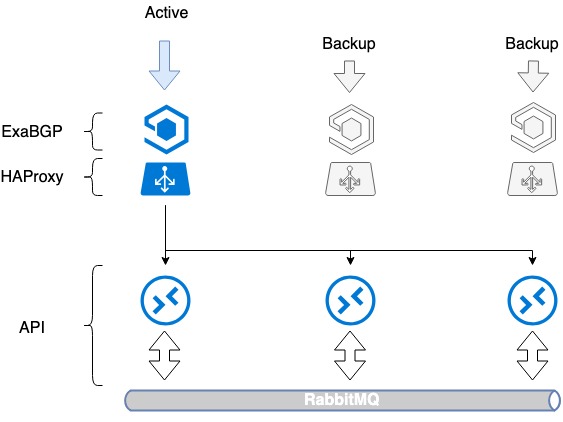
Felbeständighet för HAProxy-belastningsbalanserare.
Schemat är inte perfekt: vi har lärt oss att reservera HAProxy, men vi har inte lärt oss att fördela belastningen inom tjänsterna. Därför har vi utökat denna plan: vi har övergått till belastningsbalansering mellan flera offentliga IP-adresser.
DNS-baserad balansering plus BGP
Frågan om lastbalansering med våra HAProxy är fortfarande olöst. Ändå kan det lösas ganska enkelt, precis som vi har gjort med oss själva.
För att balansera tre servrar behövs 3 offentliga IP-adresser och den gamla hederliga DNS. Varje av dessa adresser definieras på loopback-gränssnittet för varje HAProxy och annonseras på internet.
I OpenStack används en tjänstkatalog för att hantera resurser, där API-endpointen för olika tjänster anges. I denna katalog skriver vi in domännamnet – public.infra.mail.ru, som resolveras via DNS till tre olika IP-adresser. Resultatet blir att vi får lastbalansering mellan tre adresser via DNS.
Men eftersom vi vid annonseringen av offentliga IP-adresser inte hanterar prioriteter för serverval, är detta fortfarande inte lastbalansering. Vanligtvis väljs endast en server baserat på IP-adressens rang, medan de två andra blir inaktiva, eftersom inga metrikvärden anges i BGP.
Vi började annonsera rutter via ExaBGP med olika metrikvärden. Varje lastbalanserare annonserar alla tre offentliga IP-adresser, men en av dem, den primära för den aktuella lastbalanseraren, annonseras med lägsta metrik. Så länge alla tre lastbalanserare är aktiva, går begärningar till den första IP-adressen till den första lastbalanseraren, begärningar till den andra till den andra, och till den tredje till den tredje.
Vad händer i det ögonblicket när en av lastbalanserarna faller? Vid fel på någon lastbalanserare annonseras dess grundläggande adress fortfarande av de två andra, och trafiken omfördelas mellan dem. Således ger vi användaren flera IP-adresser via DNS. Genom DNS-balansering och olika metrikvärden får vi en jämn fördelning av belastningen på alla tre lastbalanserarna. Och vi förlorar inte heller redundansen.
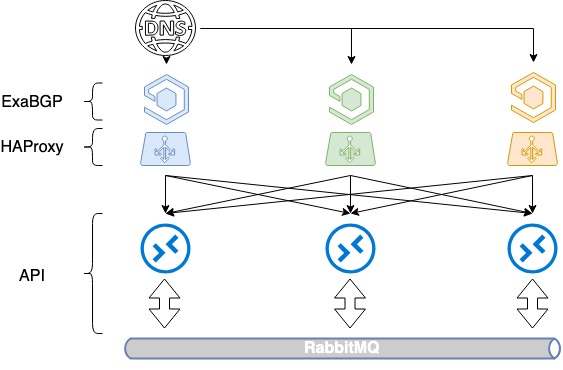
HAProxy-lastbalansering baserad på DNS + BGP
Interaktion mellan ExaBGP och HAProxy
Så, vi har implementerat redundans för serveravbrott baserat på att annonseringen av rutter upphör. Men HAProxy kan också stängas av av andra skäl än serverns fel: administrationsfel, inre tjänstfel. Vi vill undanröja en trasig lastbalanserare från belastningen även i dessa fall, och därför behövs en annan mekanism.
Därför implementerade vi heartbeat mellan ExaBGP och HAProxy genom att bygga på den tidigare schemat. Det här är en mjukvaruimplementation av interaktionen mellan ExaBGP och HAProxy, där ExaBGP använder skräddarsydda skript för att kontrollera applikationernas status.
För detta behöver man konfigurera en hälsokontrollare i ExaBGP som kan kontrollera HAProxy:s status. I vårt fall konfigurerade vi en health backend i HAProxy, och från ExaBGP gör vi en enkel GET-förfrågan. Om annonseringen slutar ske, är det troligt att HAProxy inte fungerar, och vi behöver inte annonsera det.
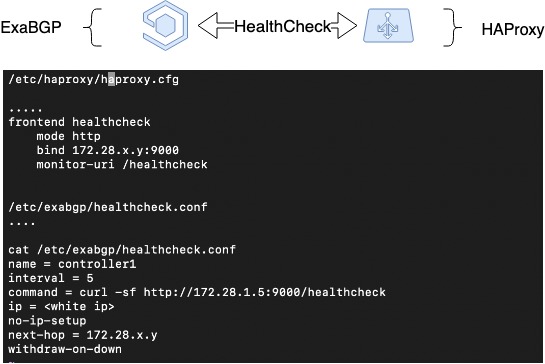
HAProxy Hälsokontroll
HAProxy Peers: session synkronisering
Nästa steg var att synkronisera sessionerna. Vid arbete genom distribuerade lastbalanserare är det svårt att bevara information om kundsessioner. Men HAProxy är en av de få lastbalanserarna som kan göra detta tack vare funktionaliteten Peers - möjligheten att överföra sessionstabeller mellan olika HAProxy-processer.
Det finns olika metoder för lastbalansering: enkla, som , och avancerade, där kundens session sparas, och han alltid hamnar på samma server som tidigare. Vi ville implementera det andra alternativet.
I HAProxy används stick-tables för att spara kundsessioner. De lagrar den ursprungliga IP-adressen för kunden, den valda måladressen (backend) och viss metadata. Vanligtvis används stick-tabeller för att spara paret source-IP + destination-IP, vilket är särskilt användbart för applikationer som inte kan överföra användarsessionens kontext när de växlar till en annan lastbalanserare, till exempel i RoundRobin-läget.
Om stick-tabellen lär sig att flytta mellan olika HAProxy-processer (mellan vilka lastbalansering sker) kan våra lastbalanserare arbeta med en gemensam uppsättning stick-tabeller. Detta kommer att möjliggöra sömlös nätverksväxling för kunden vid nedgång av en av lastbalanserarna, och arbetet med kundsessionerna kan fortsätta på de samma backends som valdes tidigare.
För att det ska fungera korrekt måste problemet med source IP-adressen för lastbalanseraren, från vilken sessionen skapades, lösas. I vårt fall är detta en dynamisk adress på loopback-gränssnittet.
Korrekt arbete med peers uppnås endast under vissa förutsättningar. Det vill säga att TCP-tidsgränserna måste vara tillräckligt stora eller att omkopplingen måste ske tillräckligt snabbt för att TCP-sessionen inte ska avbrytas. Ändå möjliggör detta sömlös omkoppling.
Vi har en tjänst inom IaaS som är byggd med samma teknologi. Det är , som heter Octavia. Den är baserad på två processer av HAProxy, och stöd för peers inbyggs från början. I den här tjänsten har de visat sig fungera mycket bra.
På bilden visas schematiskt hur peers-tabeller flyttas mellan tre instanser av HAProxy, med en konfiguration som visar hur detta kan ställas in:
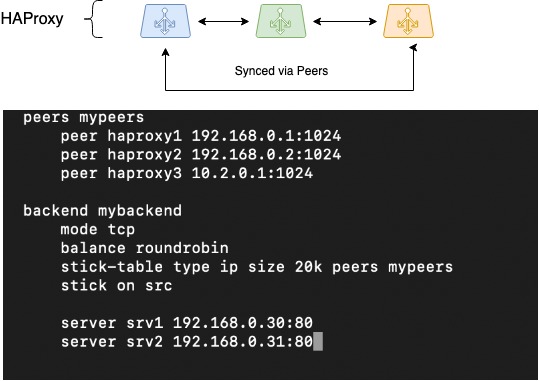
HAProxy Peers (session synkronisering)
Om du ska implementera en liknande lösning, bör dess funktion testas noggrant. Det är inte säkert att det fungerar på samma sätt i 100 % av fallen. Men åtminstone kommer du inte att förlora stick-tabeller när du behöver komma ihåg käll-IP för klienten.
Begränsning av antalet samtidiga förfrågningar från samma klient
Alla tjänster som är offentligt tillgängliga, inklusive våra API:er, kan utsättas för stormar av förfrågningar. Orsakerna till detta kan vara helt olika, från användarfel till avsiktliga attacker. Vi blir periodvis DDoSat via IP-adresser. Kunder gör ofta misstag i sina skript och orsakar mini-DDoS attacker.
På ett eller annat sätt är det nödvändigt att förutse ytterligare skydd. En uppenbar lösning är att begränsa antalet förfrågningar till API:et och inte slösa processortid på att hantera skadliga förfrågningar.
För att implementera sådana begränsningar använder vi rate limits, organiserade på basen av HAProxy, med hjälp av samma stick-tabeller. Gränserna ställs in ganska enkelt och gör det möjligt att begränsa användaren vad gäller antalet förfrågningar till API:et. Algoritmen kommer ihåg käll-IP:n som gör förfrågningarna och begränsar antalet samtidiga förfrågningar från en användare. Naturligtvis har vi beräknat det genomsnittliga belastningsprofilen för API:et hos varje tjänst och satt gränsen till cirka 10 gånger detta värde. Vi fortsätter att noggrant övervaka situationen och håller ett öga på läget.
Hur ser det ut i praktiken? Vi har kunder som ständigt använder våra API:er för automatisk skalning. De skapar ungefär två till tre hundra virtuella maskiner på morgonen och tar bort dem på kvällen. För att skapa en virtuell maskin i OpenStack, även med PaaS-tjänster, krävs minst 1000 API-anrop, eftersom interaktionen mellan tjänsterna också sker via API.
Dessa överflyttningar av uppgifter medför en ganska stor belastning. Vi har uppskattat denna belastning, samlat in dagliga toppar, ökat dem tio gånger, och det blev vår rate-limit. Vi håller ett öga på situationen. Vi ser ofta botar och skannrar som försöker ta reda på om vi har några CGA-skript som kan köras, och vi tar aktivt bort dem.
Hur man uppdaterar kodbasen utan att användarna märker något
Vi implementerar också redundans på nivån för kodutplaceringens processer. Vid utplaceringar sker det ibland fel, men deras påverkan på tjänsternas tillgänglighet kan minimeras.
Vi uppdaterar ständigt våra tjänster och måste säkerställa att processen för att uppdatera kodbasen sker utan att påverka användarna. Vi lyckades lösa denna uppgift genom att använda möjligheterna för HAProxy-hantering och implementering av Graceful Shutdown i våra tjänster.
För att lösa denna uppgift behövs det att säkerställa hantering av belastningsbalanseraren och "korrekt" avstängning av tjänster:
- I fallet med HAProxy sker hanteringen genom en statsfil, som i huvudsak är en socket och definieras i HAProxy-konfigurationen. Kommandon kan skickas till den via stdio. Men vårt huvudsakliga verktyg för konfigurationskontroll är Ansible, så det finns en inbyggd modul för att hantera HAProxy, som vi använder aktivt.
- Största delen av våra API- och Engine-tjänster stödjer tekniken för graceful shutdown: vid avstängning väntar de tills den aktuella uppgiften är helt slutförd, oavsett om det handlar om en http-förfrågan eller någon annan tjänstrelaterad uppgift. Detsamma gäller för arbetaren. Han känner till alla uppgifter han hanterar och avslutas när allt är avslutat framgångsrikt.
Tack vare dessa två punkter ser vår säkra algoritm för utplacering ut som följer.
- Utvecklaren samlar ihop ett nytt kodpaket (för oss är det RPM), testar det i dev-miljön, testar i stage och lämnar det i stage-repositoriet.
- Utvecklaren sätter en uppgift för distribution med en så detaljerad beskrivning av "artefakterna" som möjligt: version av det nya paketet, beskrivning av den nya funktionaliteten och andra detaljer om distributionen vid behov.
- Systemadministratören påbörjar uppdateringen. Hen startar Ansible-spelboken som i sin tur gör följande:
- Hämtar paketet från stage-arkivet och uppdaterar paketversionen i produktarkivet.
- Kommer att sammanställa en lista över backend-tjänster som ska uppdateras.
- Stänger av den första uppdaterade tjänsten i HAProxy och väntar på att dess processer ska avslutas. Tack vare en smidig avstängning är vi säkra på att alla pågående kundförfrågningar slutförs framgångsrikt.
- Efter att API:et, arbetarna och HAProxy har stängts av, uppdateras koden.
- Ansible startar tjänsterna.
- För varje tjänst aktiverar den specifika "knappar" som utför enhetstestning baserat på ett antal förutbestämda nyckeltester. En grundläggande kontroll av den nya koden utförs.
- Om inga fel upptäcktes i det föregående steget aktiveras backend-tjänsten.
- Går vidare till nästa backend.
- Efter att alla backend-tjänster har uppdaterats startas funktionella tester. Om dessa inte räcker, granskar utvecklaren all ny funktionalitet som hen har implementerat.
Därmed avslutas distributionen.
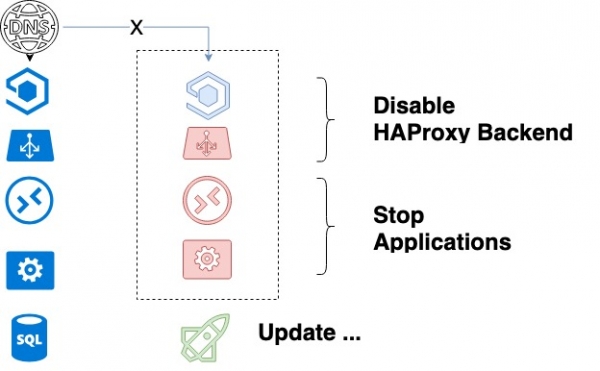
Cykeln för uppdatering av tjänsten
Detta schema skulle inte fungera om vi inte hade en regler. Vi stödjer samtidigt den gamla och den nya versionen i produktion. Redan i mjukvaruutvecklingsfasen planeras det att även om det sker förändringar i databasstrukturen för tjänsten, så ska de inte bryta den tidigare koden. Resultatet blir en gradvis uppdatering av kodbasen.
Slutsats
När jag delar mina egna tankar om hög tillgänglighet i webbarkitektur vill jag ännu en gång betona dess nyckelpunkter:
- fysisk redundans;
- nätverksredundans (lastbalanserare, BGP);
- redundans hos den använda och utvecklade mjukvaran.
Önskar alla stabil driftstid!
Källa: habr.com
