

Felaktighetstolerans och hög tillgänglighet är stora ämnen, så vi kommer att ägna RabbitMQ och Kafka separata artiklar. Denna artikel handlar om RabbitMQ, och nästa kommer att handla om Kafka, i jämförelse med RabbitMQ. Artikeln är lång, så gör dig bekväm.
Vi kommer att titta på strategier för felaktighetstolerans, konsistens och hög tillgänglighet (HA), samt de kompromisser som måste göras i varje strategi. RabbitMQ kan fungera på en kluster av noder – och klassificeras då som ett distribuerat system. När vi pratar om distribuerade system handlar det ofta om konsistens och tillgänglighet.
Dessa begrepp beskriver hur systemet beter sig vid fel. Fel i nätverksanslutning, serverfel, hårddiskfel, temporär otillgänglighet av servern på grund av skräphantering, paketförlust eller nätverksfördröjning. Allt detta kan leda till dataförlust eller konflikter. Det visar sig vara praktiskt taget omöjligt att upprätta ett system som är både helt konsistent (utan dataförlust, utan datakonflikter) och tillgängligt (som kommer att ta emot läs- och skrivoperationer) för alla typer av fel.
Vi kommer att se att konsistens och tillgänglighet finns i olika ändar av spektrumet, och du måste välja vilket håll du vill optimera mot. Den goda nyheten är att med RabbitMQ är detta val möjligt. Du har sådana "nördiga" reglage för att flytta balansen mot större konsistens eller större tillgänglighet.
Vi kommer särskilt att fokusera på vilka konfigurationer som leder till dataförlust på grund av bekräftade poster. Det finns en ansvarskedja mellan publicerare, mäklare och konsumenter. När ett meddelande har överförts till mäklaren är det hans jobb att inte förlora meddelandet. När mäklaren bekräftar mottagandet av meddelandet till publiceraren förväntar vi oss inte att det ska förloras. Men vi kommer att se att detta faktiskt kan hända beroende på din mäklares och publicerares konfiguration.
Enkelnodens motståndskraftiga primitiva
Motståndskraftiga köer/routing
I RabbitMQ finns det två typer av köer: beständiga (durable) och icke-beständiga (non-durable). Alla köer lagras i Mnesia-databasen. Beständiga köer deklareras på nytt vid start av noden och överlever därmed omstart, systemfel eller serverkrascher (så länge data lagras). Detta innebär att så länge du deklarerar routingen (exchange) och köer som beständiga, återgår kö-/routinginfrastrukturen till drift.
Icke-beständiga köer och routing tas bort vid omstart av noden.
Beständiga meddelanden
Att en kö är beständig innebär inte att alla dess meddelanden överlever omstart av noden. Endast de meddelanden som publicerats som beständiga (persistent) kommer att återställas. Beständiga meddelanden skapar verkligen en extra belastning på mäklaren, men om förlusten av ett meddelande är oacceptabel, finns det inget alternativ.
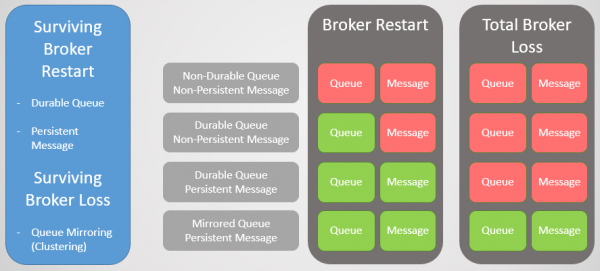
Fig. 1. Beständighetsmatris
Klustering med speglade köer
För att överleva förlusten av mäklaren behöver vi redundans. Vi kan gruppera flera RabbitMQ-noder i ett kluster och därefter öka redundansen genom att replikera köer mellan flera noder. Således, om en nod kraschar, förlorar vi inte data och förblir tillgängliga.
Speglad kö:
- en huvudkö (master) som tar emot alla skriv- och läskommandon
- en eller flera speglar som tar emot alla meddelanden och metadata från huvudköen. Dessa speglar finns inte för att skala utan uteslutande för redundans.
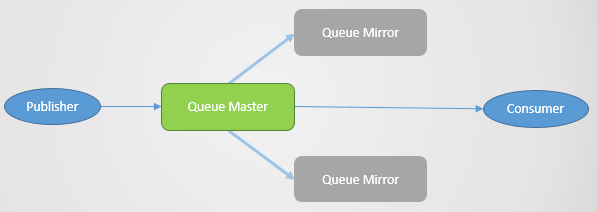
Fig. 2. Spegling av kö
Speglingen ställs in med en lämplig politik. Här kan man välja replikationsfaktorn och till och med noderna där kön ska placeras. Exempel:
ha-mode: allha-mode: exactly, ha-params: 2(en master och en spegel)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Bekräftelse till publiceraren
För att uppnå en konsekvent registrering krävs bekräftelser från publicisten (Publisher Confirms). Utan dessa finns det en risk för att meddelanden går förlorade. Bekräftelsen skickas till publicisten efter att meddelandet har skrivits till disken. RabbitMQ skriver meddelanden till disken inte vid mottagning, utan periodiskt, omkring flera hundra millisekunder. När kön speglas skickas bekräftelsen endast efter att alla speglar också har skrivit sin kopia av meddelandet till disken. Detta innebär att användning av bekräftelser lägger till en fördröjning, men om dataskydd är viktigt är de nödvändiga.
Fel tålig kö
När mäklaren avslutas eller kraschar, tappar alla ledande köer (master) på denna nod kopplingen med honom. Klustret väljer då den äldsta spegeln av varje master och befordrar den till ny master.
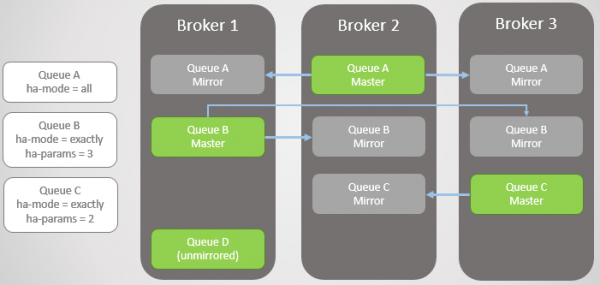
Fig. 3. Flera speglade köer och deras policyer
Mäklare 3 kraschar. Observera att spegeln för Kö C på Mäklare 2 befordras till master. Observera också att en ny spegel för Kö C skapas på Mäklare 1. RabbitMQ försöker alltid upprätthålla den angivna replikationsgraden i dina policyer.
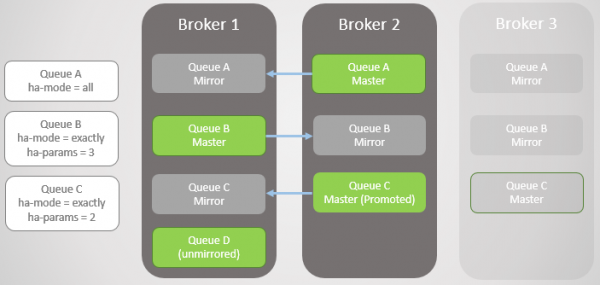
Fig. 4. Mäklare 3 kraschar, vilket orsakar en kö C-fel
Den nästa Mäklare 1 kraschar! Vi har bara en mäklare kvar. Spegeln för Kö B befordras till master.
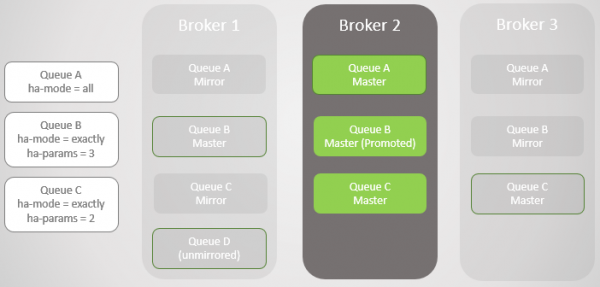
Fig. 5
Vi har återfått Mäklare 1. Oavsett hur framgångsrikt data överlevde förlusten och återställningen av mäklaren, kastas alla speglade meddelanden i kön vid omstart. Det är viktigt att notera, eftersom det kommer att få konsekvenser. Vi kommer snart att titta på dessa konsekvenser. Således är Mäklare 1 nu återigen medlem av klustret, och klustret försöker upprätthålla policyerna och skapar därför speglar på Mäklare 1.
I detta fall var förlusten av Mäklare 1 fullständig, liksom data, så den ospeglande Kö B är helt förlorad.
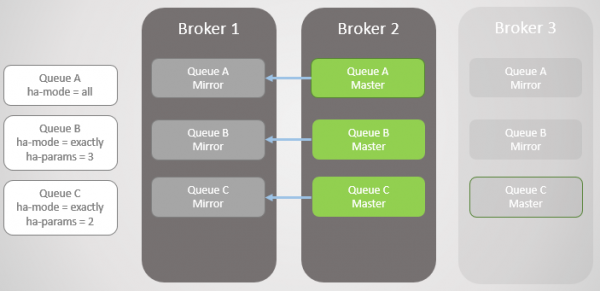
Fig. 6. Mäklare 1 återkommer till tjänst
Broker 3 är tillbaka i drift, så köerna A och B får tillbaka sina skapade spegelkopior för att uppfylla sina HA-policys. Men nu är alla huvudköer på en och samma nod! Det är inte idealiskt, en jämnare fördelning mellan noderna skulle vara bättre. Tyvärr finns det inga speciella alternativ för att ombalansera mästarna här. Vi kommer tillbaka till det problemet senare, först måste vi titta på kö-synkroniseringen.
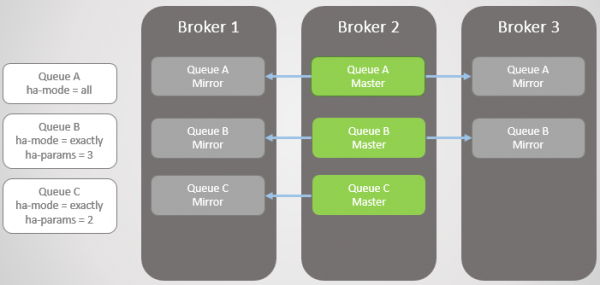
Fig. 7. Broker 3 återgår till drift. Alla huvudköer på en nod!
Så nu borde du ha en uppfattning om hur spegelkopior skapar redundans och felöverlevnad. Detta garanterar tillgänglighet vid en nodfel och skyddar mot dataförlust. Men vi är inte klara än, eftersom det faktiskt är mycket mer komplicerat.
Synkronisering
När en ny spegel skapas kommer alla nya meddelanden alltid att replikerats till denna spegel och eventuella andra. När det gäller befintliga data i huvudköen kan vi replikera dem till den nya spegeln, vilket gör den till en fullständig kopia av mästaren. Vi kan också välja att inte replikera befintliga meddelanden och låta huvudköen och den nya spegeln konvergera över tid, när nya meddelanden anländer i slutet och befintliga meddelanden raderas från början av huvudköen.
Sådan synkronisering görs automatiskt eller manuellt och styrs av köpolicyn. Låt oss ta ett exempel.
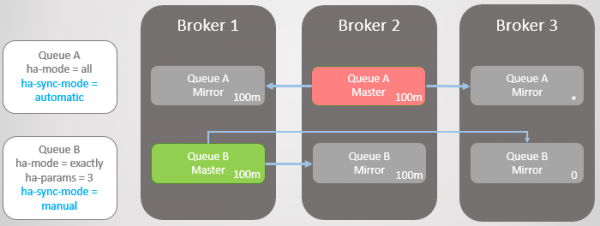
Vi har två speglade köer. Kö A synkroniseras automatiskt, medan Kö B gör det manuellt. Båda köerna har tio meddelanden.
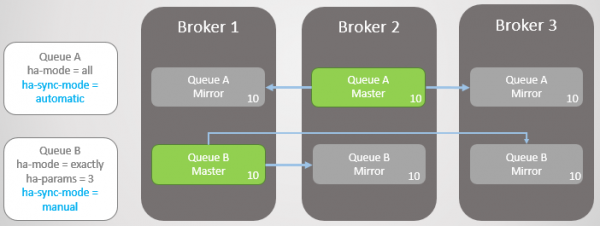
Fig. 8. Två köer med olika synkroniseringslägen
Nu förlorar vi Broker 3.
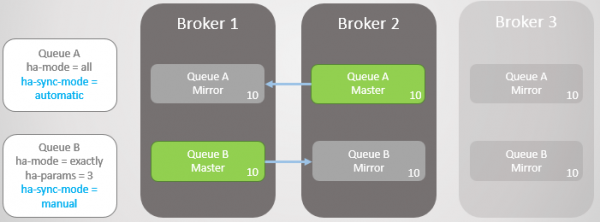
Fig. 9. Broker 3 har kraschat
Broker 3 är tillbaka i drift. Klustret skapar en spegel för varje kö på en ny nod och synkroniserar automatiskt den nya Kö A med mästaren. Men spegeln för den nya Kö B förblir tom. Således har vi full redundans för Kö A och endast en spegel för befintliga meddelanden i Kö B.
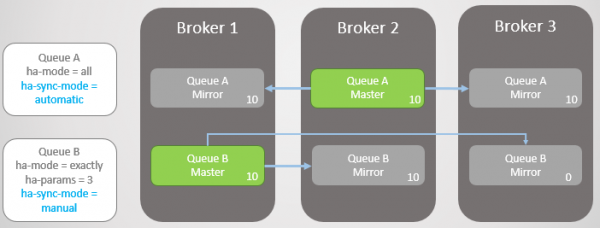
Fig. 10. Den nya spegeln av Kö A får alla befintliga meddelanden, medan den nya spegeln av Kö B inte får några.
Det kommer ytterligare tio meddelanden till båda köerna. Därefter kraschar Broker 2 och Kö A rullar tillbaka till den äldsta spegeln som finns på Broker 1. Vid ett fel sker ingen dataförlust. I Kö B finns tjugo meddelanden i mästaren och endast tio i spegeln, eftersom denna kö aldrig replikerade de ursprungliga tio meddelandena.
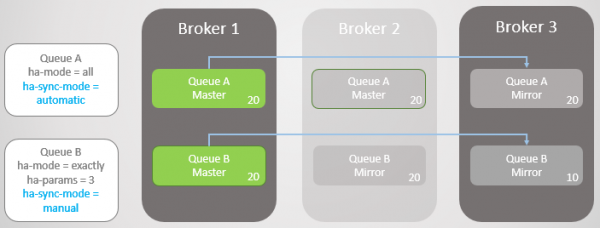
Fig. 11. Kö A rullar tillbaka på Broker 1 utan meddelandeförlust
Det kommer ytterligare tio meddelanden till båda köerna. Nu kraschar Broker 1. Kö A växlar utan problem till spegeln utan meddelandeförlust. Dock uppstår problem för Kö B. Vid detta skede kan vi optimera antingen tillgängligheten eller konsistensen.
Om vi vill optimera tillgängligheten, bör policyn ha-promote-on-failure ställas in på always. Detta är standardvärdet, så vi kan helt enkelt välja att inte ange policyn överhuvudtaget. I så fall tillåter vi i praktiken fel i osynkroniserade speglar. Detta skulle leda till meddelandeförlust, men kön förblir tillgänglig för läsning och skrivning.
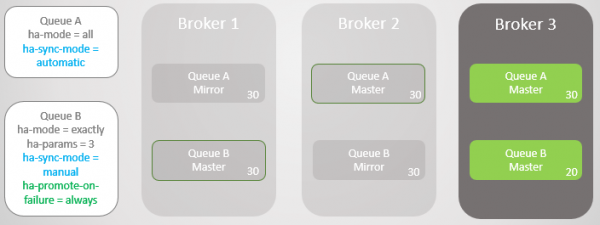
Fig. 12. Kö A rullar tillbaka på Broker 3 utan meddelandeförlust. Kö B rullar tillbaka på Broker 3 med förlust av tio meddelanden
Vi kan också ställa in ha-promote-on-failure till värdet when-synced. I detta fall kommer kön att vänta tills Broker 1 med sina data återgår till drift istället för att rulla tillbaka till spegeln. När den kommer tillbaka, hamnar huvudköen återigen på Broker 1 utan dataförlust. Tillgängligheten offras för dataskyddet. Men detta är ett riskabelt läge som kan leda till fullständig dataförlust, vilket vi kommer att titta på snart.
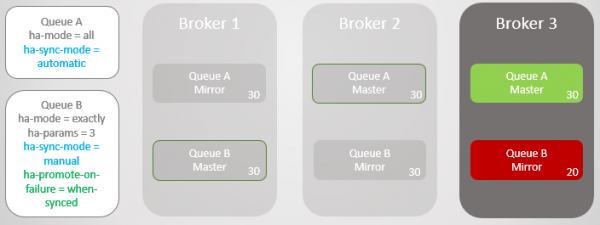
Fig. 13. Kö B förblir otillgänglig efter att Broker 1 har förlorats
Du kanske undrar: "Är det kanske bättre att aldrig använda automatisk synkronisering?". Svaret är att synkronisering är en blockerande operation. Under synkroniseringen kan huvudköen inte utföra några läs- eller skrivoperationer!
Låt oss titta på ett exempel. Just nu har vi väldigt stora köer. Hur kan de växa till så stora storlekar? Av flera anledningar:
- Köerna används inte aktivt
- Detta är högpresterande köer, och just nu arbetar konsumenterna långsamt
- Detta är högpresterande köer, det har inträffat ett fel, och konsumenterna hinner ikapp
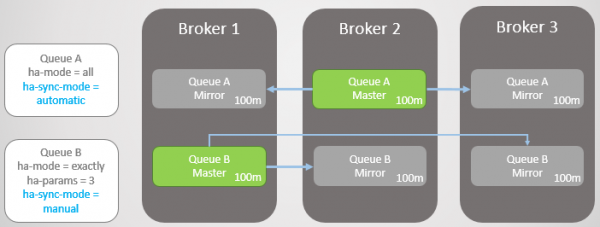
Figur 14. Två stora köer med olika synkroniseringslägen
Nu faller Broker 3.
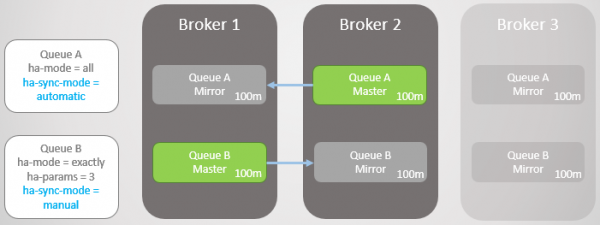
Figur 15. Broker 3 faller, vilket lämnar en master och en spegel i varje kö
Broker 3 återkommer i drift, och nya speglar skapas. Huvudkö A börjar replikera befintliga meddelanden till den nya spegeln, och under denna tid är kön otillgänglig. Datoreplikering tar två timmar, vilket leder till två timmars stillestånd för denna kö!
Men kö B förblir tillgänglig under hela perioden. Den gav upp viss redundans för att säkerställa tillgänglighet.
Figur 16. Kön förblir otillgänglig under synkroniseringen
Efter två timmar blir kö A också tillgänglig och kan åter igen börja ta emot läs- och skrivoperationer.
Uppdateringar
Det blockerande beteendet under synkronisering gör det svårt att uppdatera kluster med mycket stora köer. Vid en viss punkt måste knuten med masterstartas om, vilket betyder antingen ett byte till en spegel eller att stänga av kön under serveruppdateringen. Om vi väljer byte, förlorar vi meddelanden om speglarna inte är synkroniserade. Som standard utförs inget byte till en icke-synkroniserad spegel när broker stängs av. Det betyder att så snart broker återkommer, förlorar vi inga meddelanden; den enda skadan var stilleståndet för kön. Reglerna för beteende vid avstängning av broker bestäms av policyn ha-promote-on-shutdown. Du kan ställa in ett av två värden:
always= aktivera byte till icke-synkroniserade speglarwhen-synced= byte endast till en synkroniserad spegel, annars blir kön otillgänglig för läsning och skrivning. Kön återkommer i drift så snart broker återkommer
Oavsett, med stora köer måste man välja mellan dataloss och otillgänglighet.
När tillgänglighet ökar datasäkerheten
Innan vi fattar beslutet måste vi beakta ytterligare en komplikation. Även om automatisk synkronisering är bättre för redundans, hur påverkar den datasäkerheten? Självklart, tack vare bättre redundans, är RabbitMQ mindre benägen att förlora existerande meddelanden, men vad händer med nya meddelanden från publicerarna?
Här måste vi beakta följande:
- Kan en publicerare bara returnera ett fel, så att den överordnade tjänsten eller användaren kan försöka igen senare?
- Kan en publicerare spara meddelandet lokalt eller i databasen för att försöka igen senare?
Om publiceraren endast kan avvisa meddelandet, förbättrar ökad tillgänglighet faktiskt också dataskyddet.
Det är därför viktigt att hitta en balans, och lösningen beror på den specifika situationen.
Problem med ha-promote-on-failure=when-synced
Tanken ha-promote-on-failure= when-synced ligger i att vi förhindrar växling till en osynkroniserad spegel och därmed undviker datarförlust. Koordinaten förblir otillgänglig för läsning eller skrivning. Istället försöker vi återfå den kraschade mäklaren med intakta data så att den kan återuppta sin roll som master utan datarförlust.
Men (och detta är ett stort men) om mäklaren har förlorat sina data, har vi ett stort problem: kön är förlorad! Alla data är borta! Även om du har speglar som vanligtvis följer huvudkön, avvisas dessa speglar också.
För att lägga till noden med samma namn igen säger vi till klustret att glömma den förlorade noden (med kommandot rabbitmqctl forget_cluster_node) och startar en ny mäklare med samma värdnamn. Medan klustret kommer ihåg den förlorade noden, kommer det ihåg den gamla kön och de osynkroniserade speglarna. När klustret beordras att glömma den förlorade noden, glöms också denna kö. Den måste nu deklareras på nytt. Vi har förlorat alla data, trots att vi hade speglar med delvis datamängd. Det hade varit bättre att växla till en osynkroniserad spegel!
Således är manuell synkronisering (och att inte utföra synkronisering) i kombination med ha-promote-on-failure=when-synced, enligt min åsikt, ganska riskabelt. Dokumenten säger att detta alternativ finns för dataskydd, men det är ett tveeggat svärd.
Omfördelning av masters
Som lovat kommer vi tillbaka till problemet med ansamling av alla masters på en eller flera noder. Detta kan inträffa även som ett resultat av en "rullande" uppdatering av klustret. I ett kluster med tre noder kommer alla huvudköer att ansamlas på en eller två noder.
Omfördelning av masters kan visa sig problematisk av två skäl:
- Det finns inga bra verktyg för att utföra omfördelning
- Synkronisering av köer
Det finns en tredjepartslösning för ombalansering , som inte stöds officiellt. Gällande tredjepartsplugins i RabbitMQ-guiden : «Pluginet erbjuder vissa extra justerings- och rapporteringsverktyg, men stöds inte och har inte testats av RabbitMQ-teamet. Använd på egen risk».
Det finns ytterligare ett trick för att flytta huvud kön via HA-policyn. Guiden nämner detta. Det fungerar på följande sätt:
- Tar bort alla speglar med en temporär policy med en högre prioritet än den befintliga HA-policyn.
- Ändrar den temporära HA-policyn för att använda "nodes"-läget och specificerar noden som huvud kön ska flyttas till.
- Synkroniserar kön för att påtvinga migreringen.
- När migreringen är färdig tas den temporära policyn bort. Den ursprungliga HA-policyn träder i kraft och önskat antal speglar skapas.
Nackdelen är att denna metod kanske inte fungerar om du har stora köer eller strikta redundanskrav.
Nu ska vi titta på hur RabbitMQ-kluster hanterar nätverkspartitioner.
Brott mot sammanhållning
Noder i ett distribuerat system kopplas samman via nätverksförbindelser, och nätverksförbindelser kan och kommer att brytas. Frekvensen av avbrott beror på den lokala infrastrukturen eller pålitligheten av det valda molnet. I vilket fall som helst måste distribuerade system kunna hantera dem. Återigen har vi valet mellan tillgänglighet och konsistens, och återigen är den goda nyheten att RabbitMQ erbjuder båda alternativen (bara inte samtidigt).
Med RabbitMQ har vi två huvudsakliga alternativ:
- Tillåta logisk uppdelning (split-brain). Detta säkerställer tillgänglighet, men kan orsaka dataförlust.
- Förbjuda logisk uppdelning. Detta kan leda till kortsiktig förlust av tillgänglighet beroende på hur klienterna kopplar upp sig mot klustret. Det kan också leda till fullständig otillgänglighet i ett kluster med två noder.
Men vad är logisk uppdelning? Det är när klustret delas i två på grund av förlorade nätverksförbindelser. På varje sida höjs speglar till master, så att det i slutändan finns flera masters för varje kö.
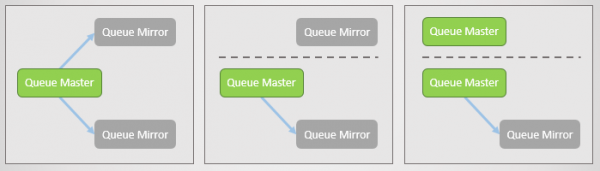
Fig. 17. Huvudkö och två speglar, var och en på en separat nod. Därefter uppstår ett nätverksfel, och en spegel separeras. Den separerade noden ser att de två andra har kopplats bort och främjar sina speglar till master. Nu har vi två huvudköer, och båda tillåter skrivning och läsning.
Om publicerare skickar data till båda masters, får vi två avvikande kopior av kön.
Olika lägen i RabbitMQ säkerställer antingen tillgänglighet eller konsistens.
Läget Ignorera (standard)
Detta läge säkerställer tillgänglighet. Efter förlust av anslutning sker en logisk separation. När anslutning har återställts måste administratören avgöra vilket avsnitt som ska prioriteras. Den förlorande sidan kommer att startas om, och all ackumulerad data från denna sida går förlorad.
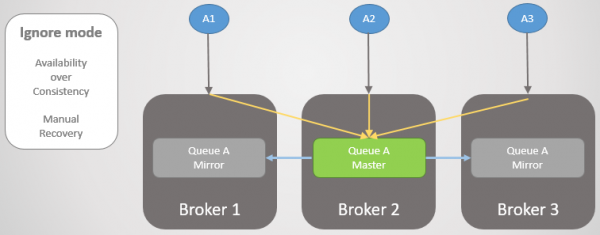
Fig. 18. Tre publicerare är kopplade till tre mäklare. Internt dirigerar klustret alla förfrågningar till huvudkö på Mäklare 2.
Nu förlorar vi Mäklare 3. Den ser att de andra mäklarna har kopplats bort och främjar sin spegel till master. Så sker en logisk separation.
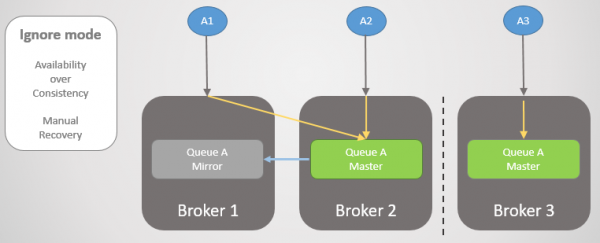
Fig. 19. Logisk separation (split-brain). Inmatningar görs i två huvudköer, och två kopior avviker.
Anslutning återställs, men logisk separation kvarstår. Administratören måste manuellt välja den förlorande sidan. I det angivna fallet startar administratören om Mäklare 3. Alla meddelanden som inte hann överföras går förlorade.
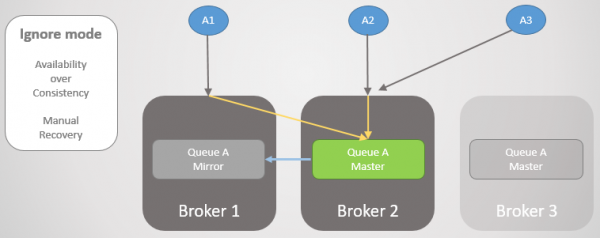
Fig. 20. Administratören stänger av Mäklare 3.
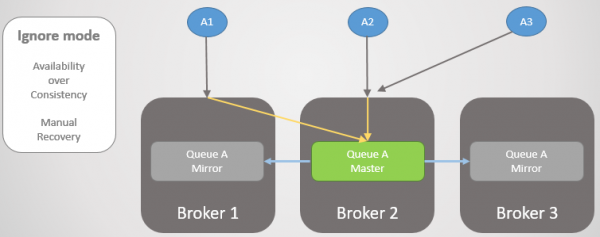
Fig. 21. Administratören startar Mäklare 3, och den går med i klustret, förlorar alla meddelanden som fanns kvar där.
Under förlust av anslutning och efter dess återställning var klustret och denna kö tillgängliga för läsning och skrivning.
Läget Autoheal
Fungerar liknande som läget Ignorera, förutom att klustret automatiskt väljer den förlorande sidan efter separation och återställande av anslutning. Den förlorande sidan återvänder till klustret tom, och kön förlorar alla meddelanden som skickades endast till den sidan.
Läget Pausa Minoritet
Om vi inte vill tillåta logiskt avskiljande är vårt enda alternativ att avstå från att läsa och skriva på den mindre sidan efter klusteravsnittet. När en mäklare ser att den är på den mindre sidan pausar den driften, vilket innebär att den stänger alla befintliga anslutningar och avvisar alla nya. En gång per sekund kontrollerar den återställningen av anslutningen. Så snart anslutningen har återställts, återupptar den driften och återansluter till klustret.
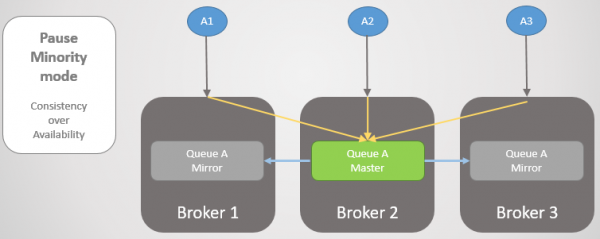
Fig. 22. Tre publicerare är kopplade till tre mäklare. Klustret dirigerar alla förfrågningar till huvudköen på Mäklare 2.
Därefter separeras Mäklare 1 och 2 från Mäklare 3. Istället för att uppgradera sitt spegel till master pausar Mäklare 3 driften och blir otillgänglig.
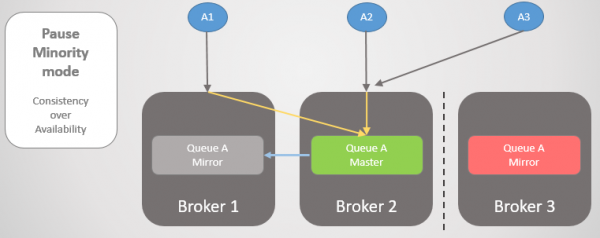
Fig. 23. Mäklare 3 pausar driften, kopplar bort alla klienter och avvisar anslutningsförfrågningar.
Så snart anslutningen har återställts, kommer den tillbaka till klustret.
Låt oss titta på ett annat exempel där huvudköen ligger på Mäklare 3.
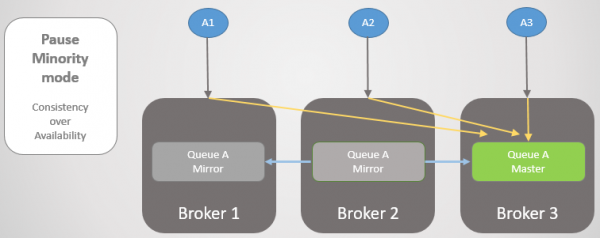
Fig. 24. Huvudköen ligger på Mäklare 3.
Därefter inträffar samma förlust av anslutning. Mäklare 3 pausas eftersom den är på den mindre sidan. På den andra sidan ser noderna att Mäklare 3 har tappat anslutningen, så den äldre spegeln från Mäklare 1 och 2 uppgraderas till master.
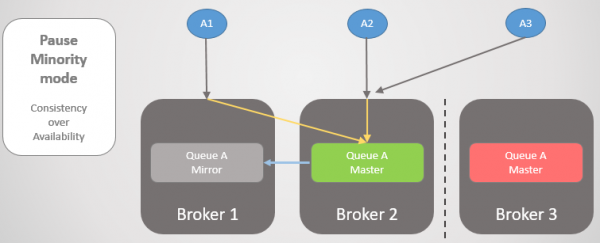
Fig. 25. Övergång till Mäklare 2 vid otillgänglighet av Mäklare 3.
När anslutningen har återställts kommer Mäklare 3 att ansluta till klustret.

Fig. 26. Klustret har återgått till normal drift.
Här är det viktigt att förstå att vi får konsistens, men vi kan också få tillgång. om vi framgångsrikt omdirigerar klienterna till den större delen av avsnittet. För de flesta situationer skulle jag personligen välja läget Pause Minority, men detta beror verkligen på det specifika fallet.
För att säkerställa tillgång är det viktigt att se till att klienterna framgångsrikt ansluter till noden. Låt oss överväga våra alternativ.
Säkerställande av klientanslutning
Vi har flera alternativ för att dirigera kunder till huvudklustret eller till fungerande noder efter en avbrott. Låt oss först påminna oss om att en specifik kö placeras på en viss nod, men routing och policys replikeras på alla noder. Kunder kan ansluta till valfri nod, och den interna routingen dirigerar dem dit de behöver gå. Men när en nod stoppas avvisar den anslutningar, så kunderna måste ansluta till en annan nod. Om noden avbryts kan den egentligen inte göra mycket.
Våra alternativ:
- Åtkomst till klustret görs via en lastbalanserare som helt enkelt roterar mellan noderna, medan kunderna gör om försök till anslutning tills det lyckas. Om en nod inte fungerar eller är stoppad, kommer anslutningsförsök till den noden att misslyckas, men efterföljande försök går till andra servrar (i cyklisk ordning). Detta passar för kortvariga avbrott eller en server som har kraschat och snabbt kommer att startas igen.
- Åtkomst till klustret via en lastbalanserare och borttagning av stoppade/kraschat noder från listan så snart de upptäckts. Om detta görs snabbt, och om kunderna kan göra om försök till anslutning, får vi kontinuerlig tillgänglighet.
- Ge varje kund en lista över alla noder, så väljer kunden slumpmässigt en av dem vid anslutning. Om de får ett fel vid anslutningsförsöket går de vidare till nästa nod i listan tills de ansluter.
- Ta bort trafik från en avstängd/stoppad nod med hjälp av DNS. Detta görs med en låg TTL.
Slutsatser
RabbitMQ-klustring har sina fördelar och nackdelar. De mest betydande nackdelarna är att:
- noderna avfärdar sina data när de ansluter till klustret;
- blockerande synkronisering leder till att kön blir otillgänglig.
Alla svåra beslut kommer från dessa två arkitekturdrag. Om RabbitMQ kunde spara data vid återkoppling av klustret, skulle synkroniseringen gå snabbare. Om det var kapabelt till icke-blockerande synkronisering skulle det bättre stödja stora köer. Att åtgärda dessa två problem skulle allvarligt förbättra RabbitMQ:s prestanda som en fel-tolerant och hög- tillgänglig meddelandehanteringsteknologi. Jag skulle inte våga rekommendera RabbitMQ med klustring i följande situationer:
- Opålitligt nätverk.
- Opålitlig lagring.
- Mycket stora köer.
När det gäller inställningar för hög tillgänglighet bör följande övervägas:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(ellerautoheal)- beständiga meddelanden
- se till att klienterna ansluter till den aktiva noden när någon nod går ner
För konsekvens (datasäkerhet) bör följande inställningar övervägas:
- Publisher Confirms och Manual Acknowledgements på konsumentsidan
ha-promote-on-failure=when-synced, om utgivarna kan försöka igen senare och om du har en mycket pålitlig lagring! Annars använd=always.ha-sync-mode=automatic(men för stora inaktiva köer kan manuellt läge krävas, dessutom, överväg om otillgänglighet kan leda till meddelandeförlust)- Pause Minority-läge
- beständiga meddelanden
Vi har inte täckt alla frågor kring fel-tolerans och hög tillgänglighet; till exempel, hur man säkert utför administrativa procedurer (såsom smyguppdateringar). Det behöver också pratas om federation och Shovel-plugin.
Om jag har missat något, vänligen låt mig veta.
Se även min , där jag genomför en genomgång av RabbitMQ-klustret med hjälp av Docker och Blockade för att testa vissa scenarier för meddelandeförlust som beskrivs i denna artikel.
Tidigare artiklar i serien:
Nr 1 —
Nr 2 —
Nr 3 —
Källa: habr.com
