

Jag vill dela med mig av min första framgångsrika erfarenhet av att återställa den fullständiga funktionaliteten i en Postgres-databas. Jag lärde känna Postgres-databashanteraren för ett halvår sedan, och innan dess hade jag ingen erfarenhet av databasadministration.
Jag arbetar som delvis DevOps-ingenjör på ett stort IT-företag. Vårt företag utvecklar mjukvara för högbelastade tjänster, och jag ansvarar för drift, underhåll och distribution. Jag fick en standarduppgift: att uppdatera en applikation på en server. Applikationen är skriven i Django, och under uppdateringen genomförs migrationer (ändringar i databasstrukturen). Innan denna process tar vi en fullständig databasdump med hjälp av det vanliga programmet pg_dump, bara för säkerhets skull.
Under dumpningen uppstod ett oförutsett fel (Postgres-version – 9.5):
pg_dump: Att dumpa innehållet i tabellen “ws_log_smevlog” misslyckades: PQgetResult() misslyckades.
pg_dump: Felmeddelande från servern: FEL: ogiltig sida i block 4123007 i relationen base/16490/21396989
pg_dump: Kommandot var: COPY public.ws_log_smevlog [...]
pg_dunp: [parallell arkivering] en arbetare process avbröts oväntat.
Fel «ogiltig sida i block» indikerar problem på filsystemsnivå, vilket är mycket otrevligt. På olika forum föreslogs att göra FULL VACUUM med alternativet zero_damaged_pages för att lösa detta problem. Vad ska vi göra, låt oss prova ...
Förberedelse för återställning
VARNING! Se till att du gör en säkerhetskopia av Postgres innan du gör något försök att återställa databasen. Om du har en virtuell maskin, stoppa databasen och ta en snapshot. Om det inte går att ta en snapshot, stäng av databasen och kopiera innehållet i Postgres-katalogen (inklusive wal-filer) till en säker plats. Det viktigaste i vårt fall är att inte förvärra situationen. Läs igenom .
Eftersom i allmänhet databasen fungerade för mig, begränsade jag mig till den vanliga databasdumpen men uteslöt tabellen med skadad data (alternativ -T, —exclude-table=TABLE i pg_dump).
Servern var fysisk, det var omöjligt att ta en snapshot. Backupen är tagen, vi går vidare.
Kontroll av filsystemet
Innan du försöker återställa databasen måste du säkerställa att vårt filsystem är i gott skick. Och om det finns fel, åtgärda dem, annars kan situationen förvärras.
I mitt fall var filsystemet med databasen monterat i «/srv» och typen var ext4.
Stoppa databasen: systemctl stop postgresql@9.5-main.service och kontrollerar att filsystemet inte används av någon och att det kan monteras av med kommandot lsof:
lsof +D /srv
Jag var tvungen att stoppa redis-databasen också, eftersom den också användes «/srv». Därefter monterade jag av /srv (umount).
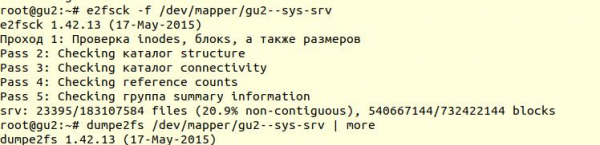
Kontroller av filsystemet genomfördes med hjälp av verktyget e2fsck med nyckeln -f (Tvinga kontroll även om filsystemet är märkt som rent):
Därefter med hjälp av verktyget dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) kan man vara säker på att kontrollen verkligen har genomförts:
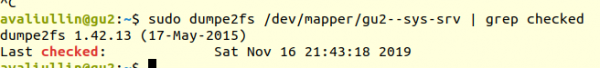
e2fsck säger att inga problem på filsystemsnivå ext4 har hittats, vilket betyder att vi kan fortsätta försöken att återställa databasen, eller snarare återvända till vacuum full (naturligtvis måste man montera filsystemet tillbaka och starta databasen).
Om du har en fysisk server, se till att kontrollera skivornas tillstånd (via smartctl -a /dev/XXX) eller RAID-kontrollern för att säkerställa att problemet inte är hårdvarunivå. I mitt fall visade sig RAID vara "järnigt", så jag bad den lokala administratören att kontrollera RAID-status (servern var flera hundra kilometer bort). Han sa att det inte fanns några fel, vilket betyder att vi verkligen kan påbörja återställningen.
Försök 1: zero_damaged_pages
Vi ansluter till databasen via psql med ett konto som har superanvändarrättigheter. Vi behöver verkligen en superanvändare, eftersom alternativet zero_damaged_pages kan bara ändras av honom. I mitt fall är det postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Alternativ zero_damaged_pages behövs för att ignorera läsfel (från postgrespro-sidan):
Vid identifiering av en skadad sidrubrik rapporterar Postgres Pro vanligtvis ett fel och avbryter den aktuella transaktionen. Om parametern zero_damaged_pages är aktiverad, ger systemet istället ett varningsmeddelande, nollställer den skadade sidan i minnet och fortsätter behandlingen. Detta beteende förstör data, nämligen alla rader i den skadade sidan.
Vi slår på alternativet och försöker göra full vacuum på tabellen:
VACUUM FULL VERBOSE 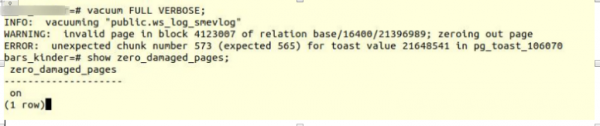
Tyvärr, det misslyckades.
Vi stöter på ett liknande fel:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– lagringsmekanismen för "långa data" i Postgres, om de inte får plats på en sida (standard är 8kB).
Försök 2: reindex
Det första rådet från Google hjälpte inte. Efter några minuters sökning hittade jag det andra rådet – att göra reindex av den korrupta tabellen. Jag har stött på detta råd på många ställen, men det inspirerade inte förtroende. Låt oss göra reindex:
reindex table ws_log_smevlog 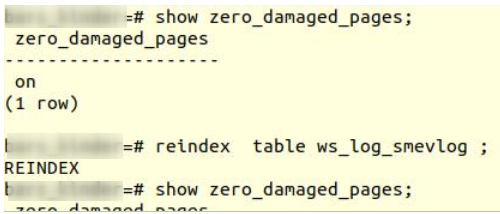
reindex slutfördes utan problem.
Men det hjälpte inte, VACUUM FULL avbröts med ett liknande fel. Eftersom jag var van vid motgångar började jag leta efter råd på internet och stötte på en ganska intressant .
Försök 3: SELECT, LIMIT, OFFSET
I artikeln ovan föreslogs det att titta på tabellen rad för rad och ta bort problematiska data. Först behövde jag gå igenom alla rader:
for ((i=0; i /dev/null || echo $i; doneI mitt fall innehöll tabellen 1 628 991 rader! I själva verket borde man ha tagit hand om , men det är ett ämne för en separat diskussion. Det var lördag, jag körde just detta kommando i tmux och gick och la mig:
for ((i=0; i /dev/null || echo $i; donePå morgonen beslutade jag mig för att kolla hur det gick. Till min förvåning upptäckte jag att endast 2% av data hade genomsökts under 20 timmar! Jag ville inte vänta i 50 dagar. Ännu ett totalt misslyckande.
Men jag tänkte inte ge upp. Jag blev nyfiken på varför genomsökningen tog så lång tid. Från dokumentationen (återigen på postgrespro) fick jag veta:
OFFSET anger hur många rader som ska hoppas över innan systemet börjar ge ut rader.
Om både OFFSET och LIMIT anges, hoppar systemet först över OFFSET rader, och börjar sedan räkna rader för att begränsa LIMIT.När man använder LIMIT är det viktigt att också använda ORDER BY, så att resultatet returneras i en viss ordning. Annars kommer oförutsägbara delmängder av rader att returneras.
Det är uppenbart att den ovanstående kommandon var felaktig: för det första fanns det ingen order by, resultatet kunde bli felaktigt. För det andra måste Postgres först genomsöka och hoppa över OFFSET-rader, och med ökad OFFSET minskade prestanda ytterligare.
Försök 4: ta en dump i textformat
Därefter kom jag på en, vid första anblicken, genial idé: ta en dump i textformat och analysera den senaste registrerade raden.
Men först, låt oss se på tabellstrukturen ws_log_smevlog:
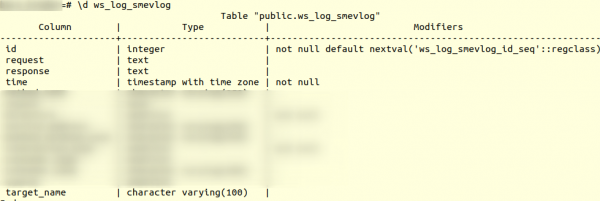
I vårt fall har vi en kolumn "id", som innehöll ett unikt identifieringsnummer (räknare) för raden. Planen var följande:
- Vi börjar ta dumpen i textformat (i form av sql-kommandon)
- Vid en viss tidpunkt skulle dumpningen avbrytas på grund av ett fel, men textfilen skulle ändå ha sparats på disken.
- Vi kollar slutet av textfilen, och därmed hittar vi identifieraren (id) för den sista rad som lyckades dumpas.
Jag började dumpa i textformat:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpDumpningen avbröts, som förväntat, med samma fel:
pg_dump: Felmeddelande från servern: ERROR: invalid page in block 4123007 of relation base/16490/21396989 Därefter, genom tail tittade jag på slutet av dumpen (tail -5 ./my_dump.dump) och upptäckte att dumpningen avbröts på raden med id 186 525. "Så problemet ligger i raden med id 186 526, den är korrupt, den måste tas bort!" – tänkte jag. Men när jag gjorde en fråga i databasen:
«select * from ws_log_smevlog where id=186529visade det sig att den här raden var helt okej... Raderna med index 186 530 – 186 540 fungerade också utan problem. Det nästa "geniala" idé föll platt. Senare insåg jag varför detta hände: när man tar bort/ändrar data i tabellen tas de inte bort fysiskt utan markeras som "döda tuple", därefter kommer autovacuum och markerar dessa rader som borttagna och tillåter att dessa rader används igen. För att förstå, om data i tabellen ändras och autovacuum är aktiverat, lagras de inte i ordning.
Försök 5: SELECT, FROM, WHERE id=
Motgångar gör oss starkare. Man ska aldrig ge upp, man måste gå till slutet och tro på sig själv och sina möjligheter. Därför bestämde jag mig för att prova en annan metod: bara kolla igenom alla poster i databasen en i taget. Med vetskap om strukturen i min tabell (se ovan), har vi ett fält id, som är unikt (primärnyckel). I tabellen har vi 1 628 991 rader och id de är i ordning, vilket innebär att vi enkelt kan gå igenom dem en i taget:
for ((i=1; i/dev/null || echo $i; doneOm någon inte förstår fungerar kommandot på följande sätt: det går igenom tabellen rad för rad och skickar stdout till /dev/null, men om SELECT-kommandot misslyckas skrivs felmeddelandet ut (stderr skickas till konsolen) och raden som innehåller felet skrivs ut (tack vare ||, vilket indikerar att select fick problem (returvärdet för kommandot är inte 0)).
Jag hade tur, jag hade skapat index på fältet id:
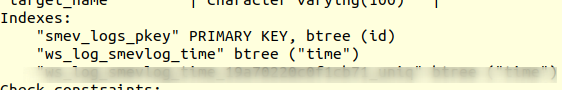
Och det betyder att hitta raden med det nödvändiga id:t inte borde ta lång tid. I teorin borde det fungera. Så, vi kör kommandot. tmux och vi går till sängs.
På morgonen upptäckte jag att cirka 90 000 poster hade granskats, vilket är lite mer än 5 %. Ett utmärkt resultat, jämfört med den tidigare metoden (2 %)! Men jag ville inte vänta i 20 dagar...
Försök 6: SELECT, FROM, WHERE id >= and id <
För kunden var en utmärkt server avsatt för databasen: dubbelprocessor Intel Xeon E5-2697 v2, i vår konfiguration hade vi hela 48 trådar! Belastningen på servern var genomsnittlig, vi kunde utan några större problem hämta ungefär 20 trådar. Det fanns också tillräckligt med arbetsminne: så många som 384 gigabyte!
Så kommandot behövde parallelliseras:
for ((i=1; i/dev/null || echo $i; doneHär kunde man ha skrivit ett snyggt och elegant skript, men jag valde den snabbaste metoden för parallellisering: att manuellt dela intervallet 0-1628991 i segment om 100 000 poster och köra 16 kommandon av typen:
for ((i=N; i/dev/null || echo $i; doneMen det är inte allt. Egentligen tar anslutningen till databasen också tid och systemresurser. Att ansluta 1 628 991 var inte så klokt, eller hur? Så låt oss vid en anslutning hämta 1000 rader istället för en. I slutändan blev kommandot så här:
for ((i=N; i=$i and id/dev/null || echo $i; doneÖppnar 16 fönster i en tmux-session och kör kommandona:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Dagen efter fick jag de första resultaten! Nämligen (värdena XXX och ZZZ har redan inte sparats):
ERROR: missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
Detta betyder att tre rader innehåller ett fel. id för den första och andra problematiska posten låg mellan 829 000 och 830 000, id för den tredje – mellan 146 000 och 147 000. Därefter måste vi helt enkelt hitta det exakta värdet id för de problematiska posterna. För detta granskar vi vårt intervall med problematiska poster steg för steg och identifierar id:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Ett lyckligt slut
Vi har hittat problematiska rader. Vi går in i databasen via psql och försöker ta bort dem:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Till min förvåning raderades posterna utan några problem även utan alternativet zero_damaged_pages.
Sedan anslöt jag till databasen, utförde VACUUM FULL (jag tror att det var onödigt), och till sist lyckades jag ta en backup med hjälp av pg_dump. Dumpen gjordes utan några fel! Problemet löstes på detta simpla sätt. Det fanns ingen gräns för glädjen, efter så många misslyckanden lyckades jag hitta en lösning!
Tack och slutsats
Så här blev min första erfarenhet av att återställa en verklig Postgres-databas. Denna erfarenhet kommer jag att minnas länge.
Och till sist skulle jag vilja tacka PostgresPro för den översatta dokumentationen till ryska och för , som verkligen hjälpte mycket under analysen av problemet.
Källa: habr.com
