

För ett par år sedan diskuterades Kubernetes i den officiella GitHub-bloggen. Sedan dess har det blivit en standardteknologi för driftsättning av tjänster. Nu hanterar Kubernetes en stor del av både interna och offentliga tjänster. Eftersom våra kluster har vuxit och prestandakraven har blivit strängare, har vi börjat märka att vissa tjänster på Kubernetes sporadiskt får fördröjningar som inte kan förklaras av belastningen på själva applikationen.
I praktiken upplever applikationerna något som liknar en slumpmässig nätverksfördröjning på upp till 100 ms eller mer, vilket leder till tidsavbrott eller omförsök. Det förväntades att tjänsterna skulle kunna svara på förfrågningar betydligt snabbare än 100 ms. Men det är omöjligt om själva anslutningen tar så mycket tid. Separat har vi observerat mycket snabba MySQL-förfrågningar som borde ta millisekunder, och MySQL klarade verkligen av det på millisekunder, men för den begärande appliceringen tog svaret 100 ms eller mer.
Det blev genast klart att problemet endast uppstod vid anslutningar till en Kubernetes-nod, även om anropet kom från utanför Kubernetes. Det enklaste sättet att återskapa problemet är i ett test , som körs från valfri intern värd, testar Kubernetes-tjänsten på en specifik port, och sporadiskt registrerar stor försening. I denna artikel kommer vi att titta på hur vi kunde spåra orsaken till detta problem.
Vi eliminerar överflödig komplexitet i felkedjan
Genom att återskapa samma exempel ville vi inskränka problemet och ta bort överflödiga lager av komplexitet. Ursprungligen fanns det för många element i flödet mellan Vegeta och poddar på Kubernetes. För att identifiera en djupare nätverksfråga behövde vi utesluta några av dem.
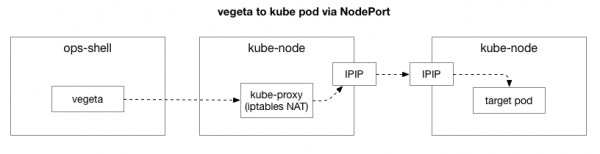
Klienten (Vegeta) skapar en TCP-anslutning till en valfri nod i klustret. Kubernetes fungerar som ett översiktsnätverk (ovanpå det befintliga datacenter-nätverket) som använder , vilket innebär att den kapslar in IP-paket från översiktsnätverket inom IP-paket från datacentret. Vid anslutning till den första noden sker en nätverksadressöversättning (NAT) med tillståndsövervakning för att omvandla IP-adressen och porten för Kubernetes-noden till en IP-adress och port i det överliggande nätverket (specifikt för podden med applikationen). För inkommande paket utförs en omvänd sekvens av åtgärder. Detta är ett komplext system med många tillstånd och ett stort antal element som ständigt uppdateras och ändras i takt med att tjänsterna distribueras och flyttas.
Verktyg Fungerar libdns korrekt? => Kör i Vegeta-testet ger en fördröjning under TCP-handshake (mellan SYN och SYN-ACK). För att ta bort denna överflödiga komplexitet kan man använda hping3 för enkla "ping" med SYN-paket. Vi kontrollerar om det finns en fördröjning i svaret och sedan återställer vi anslutningen. Vi kan filtrera data genom att endast inkludera paket med mer än 100 ms och få ett enklare reproduktion av problemet än ett fullständigt test på nätverksnivå 7 i Vegeta. Här är "pingar" från Kubernetes-noden med hjälp av TCP SYN/SYN-ACK på "nodens port" för tjänsten (30927) med en intervall på 10 ms, filtrerade efter de längsta svaren:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Vi kan omedelbart göra en första observation. Utifrån sekvenstal och tidpunkter är det tydligt att detta inte är sporadiska flaskhalsar. Fördröjningen ackumuleras ofta, och så småningom hanteras den.
Vidare vill vi ta reda på vilka komponenter som kan vara ansvariga för att flaskhalsen uppstår. Kanske är det några av de hundratals iptables-reglerna i NAT? Eller uppstår det problem med IPIP-tunneling i nätverket? Ett sätt att kontrollera detta är att granska varje steg i systemet och utesluta det. Vad händer om vi tar bort NAT och brandvägglogiken, och lämnar bara IPIP-delen:
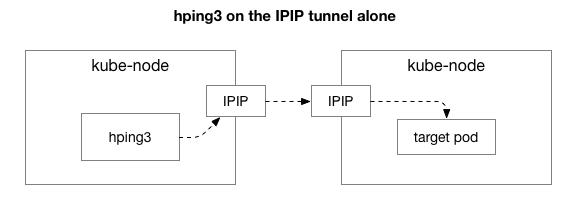
Som tur är tillåter Linux oss enkelt att direkt adressera det överliggande IP-lagret om maskinen befinner sig i samma nätverk:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.’
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Baserat på resultaten kvarstår problemet fortfarande! Detta utesluter iptables och NAT. Så problemet ligger i TCP? Låt oss se hur en vanlig ICMP-ping går:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Resultaten visar att problemet inte har försvunnit. Kan det vara en IPIP-tunnel? Låt oss förenkla testet ytterligare:
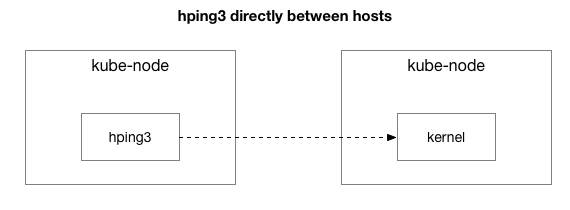
Skickas alla paket mellan dessa två värdar?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Vi har förenklat situationen till två Kubernetes-noder som skickar vilket paket som helst till varandra, även ICMP-ping. De ser fortfarande fördröjningar om den mål värden är "dålig" (vissa är sämre än andra).
Nu den sista frågan: varför uppstår fördröjningen endast på kube-node-servrar? Och förekommer den när kube-node är avsändare eller mottagare? Lyckligtvis är det också ganska enkelt att ta reda på genom att skicka paket från en värd utanför Kubernetes, men till samma "kända dåliga" mottagare. Som vi ser har problemet inte försvunnit:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Låt oss sedan göra samma förfrågningar från den tidigare avsändande kube-node till den externa värden (vilket utesluter den ursprungliga värden eftersom ping inkluderar både RX och TX som komponent):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping-statistik ---
 22352 paket skickade, 22350 paket mottagna, 1% paketförlust
 tur-och-retur min/medel/max = 0.2/7.6/1010.6 ms
Genom att studera paketfördröjningar har vi fått viss ytterligare information. Specifikt att avsändaren (nedan) ser denna tidsgräns, medan mottagaren (ovan) inte ser den — se kolumnen Delta (i sekunder):
Dessutom, om vi ser på skillnaden i ordningen av TCP- och ICMP-paket (efter sekvensnummer) från mottagarens sida, så anländer ICMP-paketen alltid i samma ordning som de skickades, men med varierande timing. Samtidigt växlar TCP-paketen ibland, och en del av dem fastnar. Specifikt, om vi studerar portarna för SYN-paket, så kommer de i ordning från avsändarens sida, men inte från mottagarens.
Det finns en subtil skillnad i hur moderna servrar (som i vårt datacenter) hanterar paket som innehåller TCP eller ICMP. När ett paket anländer "hashar" nätverksadaptern det baserat på anslutningen, vilket innebär att den försöker dela upp anslutningarna i köer och skicka varje kö till en separat processor. För TCP inkluderar denna hash både avsändar- och mottagarens IP-adress och port. Med andra ord, varje anslutning hashas (potentiellt) på olika sätt. För ICMP hashas endast IP-adresser, eftersom det inte finns några portar.
En annan ny observation: under denna period ser vi ICMP-fördröjningar i all kommunikation mellan de två värdarna, medan det inte finns några för TCP. Detta indikerar att orsaken sannolikt är relaterad till hashningen av RX-köerna: det är nästan säkert att köproblem uppstår i bearbetningen av RX-paket, snarare än i sändningen av svar.
Detta utesluter paketutskick från listan över möjliga orsaker. Nu vet vi att problemet med paketbearbetningen ligger på mottagarsidan på vissa kube-node-servrar.
Vi undersöker paketbearbetning i Linux-kärnan
För att förstå varför problemet uppstår för mottagare på vissa kube-node-servrar, låt oss titta på hur Linux-kärnan hanterar paket.
Tillbaka till den enklaste traditionella implementeringen, så tar nätverkskortet emot ett paket och skickar till Linux-kärnan, vilket indikerar att det finns ett paket som ska behandlas. Kärnan stoppar annat arbete, växlar kontext till avbrottshanteraren, hanterar paketet och återgår sedan till sina nuvarande uppgifter.
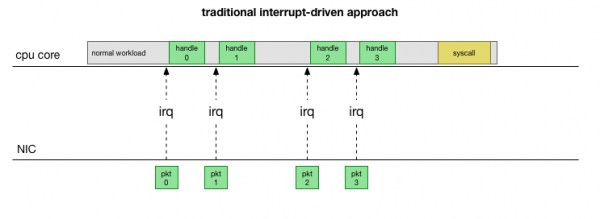
Denna kontextväxling sker långsamt: kanske var fördröjningen osynlig på 10-mbps nätverkskort under 90-talet, men på moderna 10G-kort med en maximal kapacitet av 15 miljoner paket per sekund kan varje kärna i en liten åttakärnig server avbrytas miljoner gånger per sekund.
För att undvika att ständigt hantera avbrott, lades det för många år sedan till i Linux : ett nätverks-API som används av alla moderna drivrutiner för att öka prestandan vid höga hastigheter. Vid låga hastigheter tar kärnan fortfarande emot avbrott från nätverkskortet på det gamla sättet. Så snart ett tillräckligt antal paket som överstiger tröskeln anländer, stänger kärnan av avbrotten och börjar istället fråga nätverksadapter och hämta paket i portioner. Behandlingen utförs i softirq, det vill säga i efter systemanrop och hårdvaruavbrott, när kärnan (till skillnad från användarutrymmet) redan har startats.
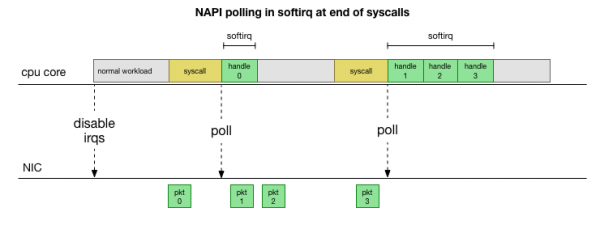
Detta är mycket snabbare, men leder till ett annat problem. Om det kommer för många paket går all tid åt till att behandla paket från nätverkskortet, och processer i användarutrymmet hinner inte faktiskt tömma dessa köer (läsa från TCP-anslutningar osv.). I slutändan fylls köerna, och vi börjar kassera paket. För att försöka hitta en balans sätter kärnan en budget för det maximala antalet paket som får behandlas i softirq-kontakt. Så snart denna budget överskrids väcks en separat tråd ksoftirqd (du kommer att se en av dem i ps för varje kärna), som hanterar dessa softirq utanför den vanliga syscall-/avbrottsvägen. Denna tråd schemaläggs med hjälp av den vanliga process-schemaläggaren som försöker fördela resurser rättvist.
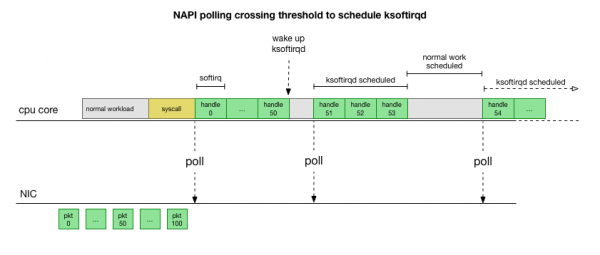
Genom att studera hur kärnan behandlar paket kan man notera att det finns en viss sannolikhet för att det uppstår köer. Om softirq-anropen kommer mer sällan måste paketen vänta en stund på behandling i RX-kön på nätverkskortet. Detta kan bero på någon uppgift som blockerar kärnprocessorn, eller något annat som hindrar kärnan från att köra softirq.
Vi begränsar behandlingen till kärnan eller metoden
Softirq-fördröjningar är fortfarande bara en hypotes. Men det är ett rimligt antagande, och vi vet att vi upplever något väldigt liknande. Så nästa steg är att bekräfta denna teori. Om den bekräftas, måste vi hitta orsaken till fördröjningarna.
Låt oss återgå till våra långsamma paket:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Som diskuterats tidigare, dessa ICMP-paket hashas till en kö för NIC RX och behandlas av en enda CPU-kärna. Om vi vill förstå hur Linux fungerar, är det bra att veta var (vilken CPU-kärna) och hur (softirq, ksoftirqd) dessa paket behandlas, för att kunna spåra processen.
Det är nu dags att använda verktyg som gör det möjligt att spåra Linux-kärnans drift i realtid. Här använde vi . Denna uppsättning verktyg låter oss skriva små program i C som fångar upp godtyckliga funktioner i kärnan och buffrar händelser i ett Python-användarutrymmeprogram, som kan bearbeta dem och ge oss resultat. Hookar för godtyckliga funktioner i kärnan är komplicerat, men verktyget är designat för maximal säkerhet och är avsett för att spåra sådana produktionsproblem som är svåra att reproducera i en test- eller utvecklingsmiljö.
Planen här är enkel: Vi vet att kärnan hanterar dessa ICMP-pingar, så vi sätter en hook på kärnfunktionen , som tar emot den inkommande ICMP-paketet "echo request" och initierar sändningen av ICMP-svaret "echo response". Vi kan identifiera paketet genom att se på ökning av numret icmp_seq, som visar hping3 högre.
Kod ser komplicerat ut, men det är inte så skrämmande som det verkar. Funktionen icmp_echo rapporterar struct sk_buff *skb: är paketet med "echo request"-förfrågan. Vi kan spåra det, ta ut sekvensen echo.sequence (som matchar med icmp_seq från hping3 metoden.), och skicka den till användarutrymmet. Det är också praktiskt att fånga det aktuella processnamnet/id. Nedan visas resultaten som vi ser direkt under paketbehandlingen av kärnan:
TGID    PID     PROCESS NAME    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Det bör påpekas att i detta sammanhang softirq processer som har gjort systemanrop kommer att visas som "processer", även om kärnan faktiskt hanterar paket i kärnans kontext.
Med detta verktyg kan vi etablera en koppling mellan specifika processer och specifika paket som visar förseningar i hping3. Vi gör en enkel grep analys av denna fångst för vissa värden icmp_seq. Paketen som överensstämmer med ovanstående värden av icmp_seq har märkts tillsammans med deras RTT, som vi observerade ovan (de förväntade värdena för RTT för paketen som vi filtrerade på grund av RTT-värden mindre än 50 ms anges i parentes):
TGID    PID     PROCESS NAME    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Resultaten talar om flera saker. För det första hanteras alla dessa paket av kontexten ksoftirqd/11. Detta innebär att för denna specifika maskinpar hashades ICMP-paketen till kärna 11 på mottagarsidan. Vi ser också att det vid varje stopp finns paket som hanteras i kontexten av systemanropet cadvisor. Sedan ksoftirqd tar sig an uppgiften och behandlar den ackumulerade kön: den mängd paket som har samlats efter cadvisor.
Det faktum att det alltid finns verksamhet precis innan detta cadvisor, tyder på dess involvering i problemet. Ironiskt nog är syftet med att "analysera resursanvändning och prestandakarakteristika för startade containrar", snarare än att orsaka detta prestandaproblem.
Likt med andra aspekter av containerarbete, är detta ett ytterst avancerat verktyg som mycket väl kan ge upphov till prestandaproblem under vissa oförutsedda omständigheter.
Vad är det cadvisor gör som bromsar paketkön?
Nu har vi en ganska bra förståelse för hur felet inträffar, vilken process som orsakar det och på vilken CPU. Vi ser att på grund av hård blockering hinner Linux-kärnan inte schemalägga i tid. ksoftirqdOch vi ser att paketen bearbetas i kontexten. cadvisor. Det är logiskt att anta att cadvisor driver en långsam syscall, efter vilket alla paket som har samlats under tiden bearbetas:
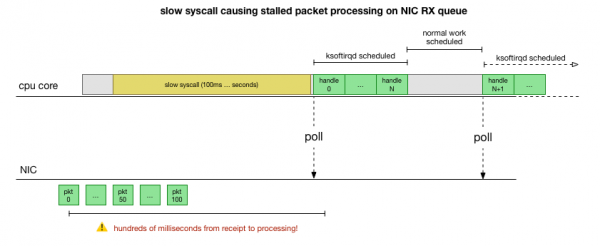
Detta är teorin, men hur kan vi bekräfta den? Vad vi kan göra är att följa CPU-kärnans arbete genom hela denna process, hitta punkten där budgetöverskridandet för antalet paket inträffar och ksoftirqd anropas, och sedan titta lite tidigare – vad som arbetade på CPU:n precis innan detta ögonblick. Det är som en röntgen av CPU:n var några millisekund.
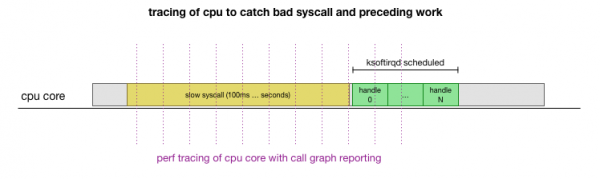
Det är praktiskt att allt detta kan göras med befintliga verktyg. Till exempel, kontrollerar med angiven frekvens den specificerade CPU-kärnan och kan generera en anropsgraf för det fungerande systemet, inklusive både användarutrymme och Linux-kärnan. Vi kan ta denna inspelning och bearbeta den med hjälp av en liten fork av programmet från Brendan Gregg, som bevarar ordningen på stackspåren. Vi kan spara enstreckiga stackspår var 1 ms och sedan extrahera och spara ett prov för 100 millisekunder innan det kommer in i spåret. ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Här är resultaten:
(hundratals spår som ser likadana ut)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Det finns mycket här, men det viktigaste är att vi hittar mönstret "cadvisor före ksoftirqd" som vi tidigare sett i ICMP-tracern. Vad betyder detta?
Varje rad är en CPU-tracering vid en viss tidpunkt. Varje nedåtgående anrop i stacken på raden separeras med ett semikolon. I mitten av raderna ser vi det anrop som görs: read(): .... ;do_syscall_64;sys_read; .... Således spenderar cadvisor mycket tid på systemanropet read(), relaterat till funktionerna mem_cgroup_* (den övre delen av anropsstacken/slutet av raden).
I anropstraceringen är det svårt att se vad som faktiskt läses, så vi kommer att köra för att kontrollera paketöverföringen åt båda håll och se vad cadvisor gör och hitta systemanrop som tar mer än 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Som förväntat ser vi långsamma anrop här read(). Innehållet i läsoperationer och kontext mem_cgroup det är tydligt att dessa anrop read() hör till filen memory.stat, som visar minnesanvändning och begränsningar för cgroup (resursisoleringsteknologi i Docker). Verktyget cadvisor frågar denna fil för att få information om resursanvändning för containrar. Låt oss kontrollera om det är kärnan eller cadvisor som gör något oväntat:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
verklig 0m0.153s
användare 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Nu kan vi återskapa buggen och förstår att Linux-kärnan stöter på en patologi.
Varför är läsoperationen så långsam?
Vid det här laget är det mycket enklare att hitta meddelanden från andra användare om liknande problem. Som det visade sig, rapporterades denna bugg i cadvisor-tracker som en , det var bara ingen som upptäckte att fördröjningen även slumpmässigt påverkar nätverksstacken. Det märktes verkligen att cadvisor förbrukade mer CPU-tid än förväntat, men detta togs inte på allvar, eftersom våra servrar har mycket CPU-resurser, så problemet studerades inte noggrant.
Problemet är att kontrollgrupper (cgroups) tar hänsyn till minnesanvändning inom namnutrymmet (containern). När alla processer i denna cgroup avslutas frigör Docker minneskontrollgruppen. Men 'minne' är inte bara processminne. Även om processens minne inte längre används, visar det sig att kärnan fortfarande tilldelar cacheinnehåll, såsom dentries och inodes (metadata för kataloger och filer), som cachas i memory cgroup. Från problembeskrivningen:
cgroups-zombier: kontrollgrupper utan processer som har tagits bort, men för vilka minne fortfarande allokeras (i mitt fall, från dentry-cache, men det kan även allokeras från sidcache eller tmpfs).
Kärnans kontroll av alla sidor i cachen vid frigörandet av cgroup kan vara mycket långsam, så en lat process valdes: vänta tills dessa sidor begärs igen, och först när minnet verkligen behövs, till slut rensa cgroup. Fram till dess beaktas cgroup fortfarande vid insamling av statistik.
Ur prestandas synpunkt har de offrat minnet för prestanda: snabbare initial rensning genom att kvarlämna lite cacheminne. Det är okej. När kärnan använder den sista delen av det cacheminnet, rensas cgroup till slut, så det kan inte kallas en "läcka". Tyvärr gör den specifika implementeringen av sökmekanismen memory.stat i denna version av kärnan (4.9), i kombination med den stora mängden minne på våra servrar, att det tar mycket längre tid att återställa de senaste cachade data och rensa cgroup-zombier.
Det visade sig att på vissa av våra noder fanns så många cgroup-zombier att läsning och fördröjning översteg en sekund.
Ett sätt att kringgå problemet med cadvisor är att omedelbart frigöra cacharna för dentries/inodes över hela systemet, vilket omedelbart eliminerar läsfördröjningen, såväl som nätverksfördröjningen på värden, eftersom borttagning av cache inkluderar de cachade sidorna av cgroup-zombier, som också frigörs. Detta är ingen lösning, men bekräftar orsaken till problemet.
Det visade sig att i de nyare versionerna av kärnan (4.19+) har prestandan för anrop förbättrats memory.stat, så att uppgradering till denna kärna löste problemet. Samtidigt hade vi verktyg för att upptäcka problematiska noder i Kubernetes-kluster, elegant stänga av dem och starta om dem. Vi genomsökte alla kluster, hittade noder med tillräckligt hög fördröjning och startade om dem. Detta gav oss tid att uppdatera OS på resten av servrarna.
Sammanfattningsvis
Eftersom denna bugg stoppade hanteringen av NIC RX-köer i hundratals millisekunder, orsakade den samtidigt både stor fördröjning i korta anslutningar och fördröjning i mitten av anslutningen, till exempel mellan MySQL-frågor och svarspaket.
Förståelse och stöd för prestanda hos de mest fundamentala systemen, såsom Kubernetes, är avgörande för tillförlitligheten och hastigheten hos alla tjänster som är baserade på dem. Alla körda system drar nytta av Kubernetes prestandaförbättringar.
Källa: habr.com
