

I Vi har pratat om prognoser för tidsserier. En logisk fortsättning skulle vara en artikel om att upptäcka avvikelser.
Tillämpning
Avvikelseupptäckning används inom områden som:
1) Förutsägelse av maskinfel
Till exempel, 2010 attackerades iranska centrifuger av viruset Stuxnet, vilket ställde in utrustningen på en suboptimal drift och orsakade att en del av utrustningen skadades på grund av ökat slitage.
Om man hade använt algoritmer för avvikelseupptäckning på utrustningen, skulle sådana driftstopp ha kunnat undvikas.
Avvikelseupptäckning i maskinvård används inte bara inom kärnkraftindustrin, utan även inom metallurgi och drift av flygmotorer. Och inom andra områden där användning av prediktiv diagnos är billigare än potentiella förluster vid oförutsedda fel.
2) Förutsägelse av bedrägliga handlingar
Om pengar tas från ett kort som du använder i Podolsk, i Albanien, kan det vara bra att dubbelkolla transaktionerna.
3) Upptäckte avvikande kundmönster
Om en del av kunderna visar avvikande beteende kan det finnas ett problem som du inte känner till.
4) Upptäckte avvikande efterfrågan och belastning
Om försäljningen i din FMCG-butik sjunker under det förutsagda konfidensintervallet, är det värt att söka efter orsaken.
Metoder för att upptäcka avvikelser
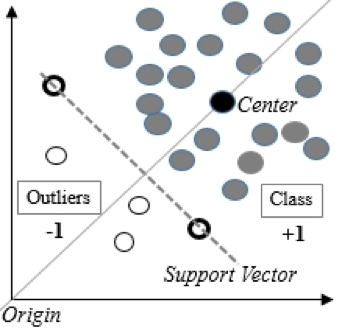
1) Stödvektormetoden med en klass One-Class SVM
Denna metod passar när träningsdatamängden följer en normalfördelning och testdatamängden innehåller avvikelser.
One-Class SVM bygger en icke-linjär yta runt origo. En tröskel kan sättas för att avgöra vilka data som ska betraktas som avvikande.
Enligt erfarenheten från vårt team DATA4 är One-Class SVM den mest använda algoritmen för att lösa avvikelseupptäckningsproblem.
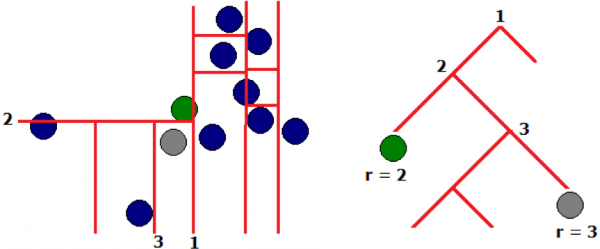
2) Isolerande skog – isolate forest
Vid "slumptäckning" av träd kommer avvikelser att hamna i blad på tidiga stadier (med en liten träddjup), dvs. avvikelser är lättare att "isolera". Identifikation av avvikande värden sker tidigt i algoritmens iterationer.
3) Elliptisk kuvert och statistiska metoder
Används när data är normalt fördelade. Ju närmare mätningen ligger svansen av fördelningarna, desto mer avvikande är värdet.
Denna klass kan även inkludera andra statistiska metoder.
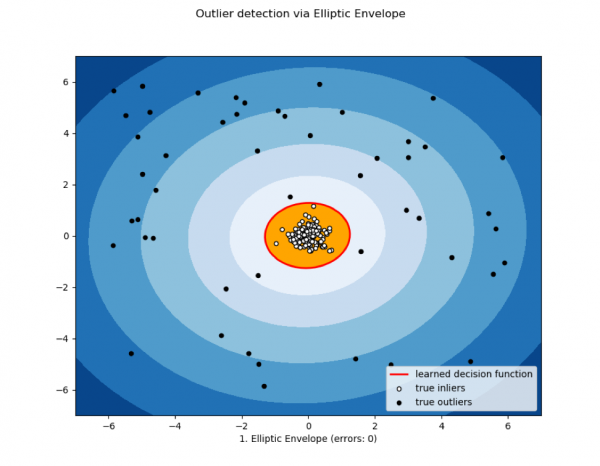
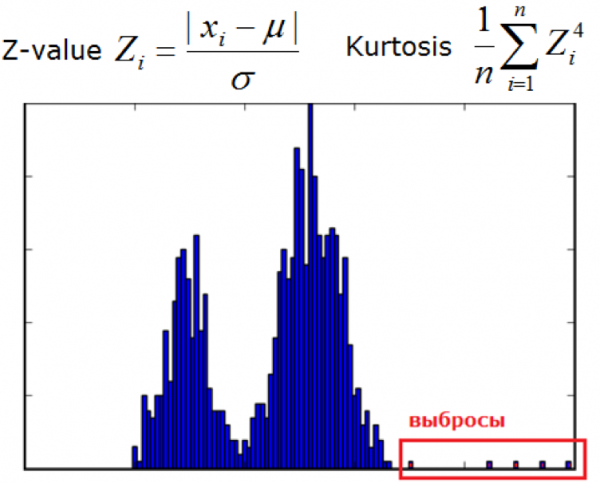
Bild från dyakonov.org
4) Metriska metoder
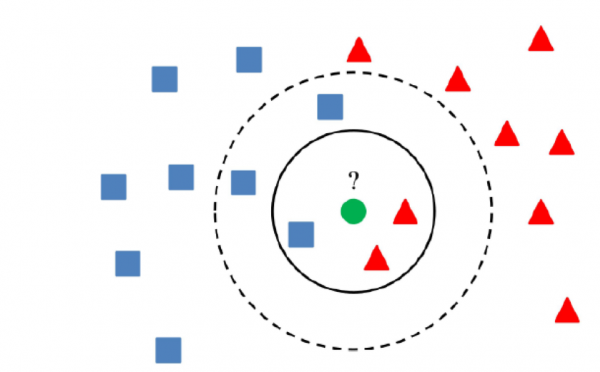
Bland metoderna finns algoritmer som k närmaste grannar, k närmaste granne, ABOD (angle-based outlier detection) eller LOF (local outlier factor).
Dessa är lämpliga om avståndet mellan värden i funktionerna är likvärdigt eller normalt (för att inte mäta pytonormar i papegujor).
Algoritmen k närmaste grannar antar att normala värden är placerade inom ett visst område i mångdimensionellt rum, och att avståndet till avvikelserna kommer att vara större än till den separerande hyperplanen.
5) Kluster metoder
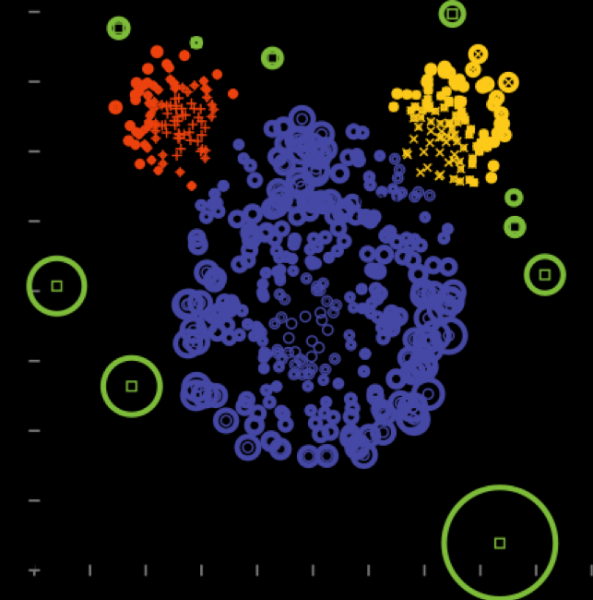
Kärnan i kluster metoder är att om ett värde är mer än ett visst avstånd från klustrets centrum, så kan värdet betraktas som en avvikelse.
Det viktigaste är att använda en algoritm som korrekt klustrar datan, vilket beror på den specifika uppgiften.
6) Huvudkomponentmetoden
Lämplig där riktningar för största förändring av varians framhävs.
7) Algoritmer baserade på tidsserieförutsägelser
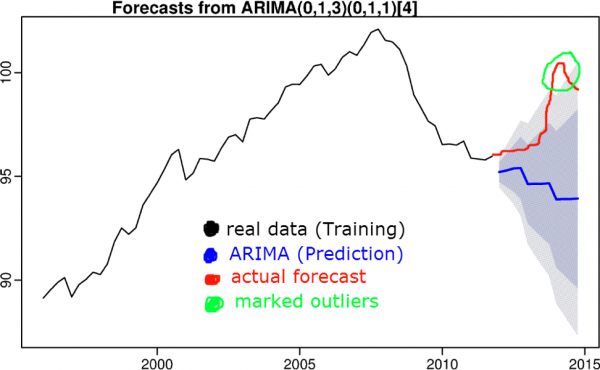
Idén är att om ett värde avviker från förtroendeintervallet för prognosen, betraktas värdet som en avvikelse. För tidsserieprognoser används algoritmer som tredubbel utjämning, S(ARIMA), boosting, osv.
Om algoritmer för tidsserieprognoser har nämnts i den föregående artikeln.
8) Lärande med övervakning (regression, klassificering)
Om datan tillåter använder vi algoritmer från linjär regression till återkommande nätverk. Vi mäter skillnaden mellan prognosen och det faktiska värdet, och drar slutsatsen om hur mycket datan avviker från normen. Det är viktigt att algoritmen har tillräcklig generaliseringsförmåga och att träningssetet inte innehåller avvikande värden.
9) Modelltester
Vi närmar oss uppgiften att hitta avvikelser som en uppgift att hitta rekommendationer. Vi faktorisera vår funktionsmatris med hjälp av SVD eller faktoriseringmaskiner, och värden i den nya matrisen som avviker avsevärt från originalet betraktas som avvikande.
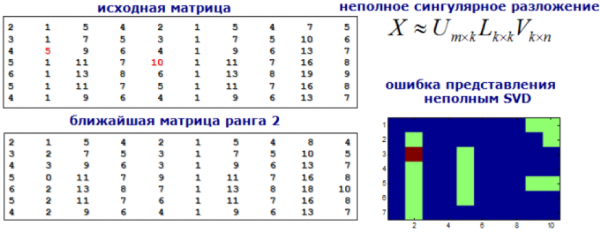
Bild från dyakonov.org
Slutsats
I den här artikeln har vi granskat de grundläggande metoderna för avvikelsedetektering.
Att identifiera anomalier kan till stor del beskrivas som en konst. Det finns ingen perfekt algoritm eller metod som löser alla problem. Oftare används en kombination av metoder för att lösa specifika fall. Anomalidetektion utförs med hjälp av enklassmetoder för stödvektorer, isolerade skogar, metrisk och klustermetoder, samt genom användning av huvudkomponenter och tidsserieförutsägelser.
Om du känner till andra metoder, skriv gärna om dem i kommentarerna till artikeln.
Källa: habr.com
