

I yrkesverksamhet stöter man ibland på situationer när utvecklaren skriver en fråga och tänker "databasen är smart, den klarar allt själv!"«
I vissa fall (delvis på grund av okunskap om databasens möjligheter, delvis på grund av för tidiga optimeringar) leder den här metoden till att "frankensteiner" uppstår.
Först ska jag ge ett exempel på en sådan fråga:
-- för varje nyckelpar hittar vi relaterade värden för fälten
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- hittar min/max värden för varje första nyckel
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- kopplar nyckelpar och min/max-värden efter första nyckeln
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
För att konkret bedöma kvaliteten på frågan, låt oss skapa en viss godtycklig uppsättning data:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
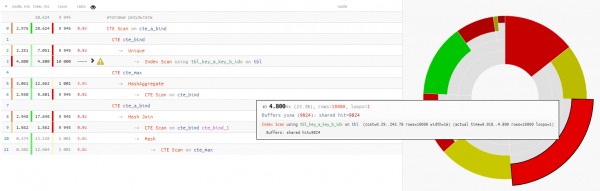
Det visar sig att själva läsningen av data tog mindre än en fjärdedel av den totala tiden för frågeexekveringen:
Analyserar noggrant
Låt oss ta en noggrann titt på frågan och fundera:
- Varför finns det WITH RECURSIVE här om det inte finns några rekursiva CTE:er?
- Varför gruppera min/max-värden i en separat CTE om de ändå kopplas till den ursprungliga urvalet?
+25% tid - Varför använda en ny inläsning från föregående CTE i slutet med en obetingad ‘SELECT * FROM’?
+14% tid
I det här fallet hade vi tur att en Hash Join valdes för att förena och inte en Nested Loop, annars skulle vi få mer än en enda genomgång av CTE Scan, utan vi skulle fått 10K!
litet om CTE ScanHär bör man komma ihåg att CTE Scan är motsvarigheten till Seq Scan — det vill säga ingen indexering, utan bara en total genomgång, vilket skulle kräva 10K x 0.3ms = 3000ms vid cykler över cte_max eller 1K x 1.5ms = 1500ms vid cykler över cte_bind!
Egentligen, vad ville vi åstadkomma som resultat? Aha, vanligtvis kommer just den frågan upp efter ungefär femte minuten av att analysera "tre våningar"-frågor.
Vi ville få ut min/max för varje unik nyckelpar grupperat efter key_a.
Så låt oss använda :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 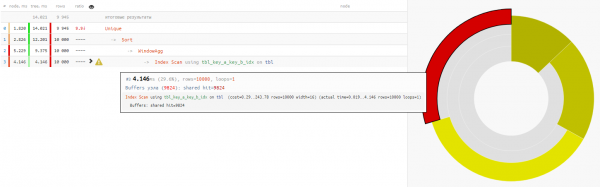
Eftersom dataläsning i båda fallen tar ungefär 4-5 ms, så är hela vår tidsvinst -32% — det är helt och hållet belastning borttagen från basens CPU, om en sådan förfrågan görs tillräckligt ofta.
Generellt sett bör man inte tvinga databasen att "bära runt cirkulärt och rulla runt kvadratiskt".
Källa: habr.com
