

Den här artikeln är den andra i serien om snabb datakompression. I den första artikeln beskrevs en kompressor som arbetar med en hastighet av 10 GB/s per processor kärna (minimalt komprimering, RTT-Min).
Denna kompressor har redan implementerats i utrustning för kriminaltekniska dubbletter för snabb komprimering av dumpningar av informationsbärare och för att öka motståndskraften hos kryptografi. Den kan även användas för komprimering av bilder av virtuella maskiner och svappfiler i RAM-minnet när de lagras på högpresterande SSD-enheter.
I den första artikeln tillkännagavs också utvecklingen av en komprimeringsalgoritm för att komprimera säkerhetskopior av HDD- och SSD-enheter (medelkomprimering, RTT-Mid) med avsevärt förbättrade komprimeringsparametrar. För närvarande är denna kompressor helt färdig och denna artikel handlar just om den.
Kompressorn som implementerar algoritmen RTT-Mid ger en komprimeringsgrad som är jämförbar med standardarkivator som WinRar och 7-Zip, som arbetar i snabbhetsläge. Samtidigt är dess arbets hastighet minst en ordning högre.
Hastigheten för packning/uppackning av data är en kritisk parameter som avgör användningsområdet för kompressionsteknologier. Det är osannolikt att någon skulle komma på tanken att komprimera en terabyte data med en hastighet av 10-15 Megabyte per sekund (det är just denna hastighet hos arkivator i standard komprimeringsläge), eftersom det skulle ta nästan tjugo timmar med full processorladdning...
Å andra sidan kan samma terabyte kopieras med hastigheter på cirka 2-3 Gigabyte per sekund på tio minuter.
Därför är komprimering av stora volymer information relevant om det utförs med en hastighet som inte är lägre än den verkliga in- och utmatningshastigheten. För moderna system är detta inte mindre än 100 Megabyte per sekund.
Sådana hastigheter kan moderna kompressorer endast nå i "fast"-läge. Det är i detta aktuella läge vi kommer att göra en jämförelse av algoritmen RTT-Mid med traditionella kompressorer.
Jämförande testning av den nya komprimeringsalgoritmen
Kompressorn RTT-Mid fungerade som en del av ett testprogram. I en verklig "arbets"-applikation arbetar den betydligt snabbare, där används multithreading effektivt och en "normal" kompilator, inte C#.
Eftersom de kompressorer som användes i det jämförande testet baseras på olika principer och olika typer av data komprimeras på olika sätt, användes metoden att mäta 'den genomsnittliga temperaturen på sjukhuset' för att säkerställa objektivitet i testet…
En fil med sektordump av den logiska disken med operativsystemet Windows 10 skapades, vilket utgör en naturlig blandning av olika datastrukturer som faktiskt finns på varje dator. Komprimering av denna fil möjliggör en jämförelse av hastighet och kompressionsgrad för den nya algoritmen med de mest avancerade kompressorerna som används i moderna arkiverare.
Här är dumpfilen:
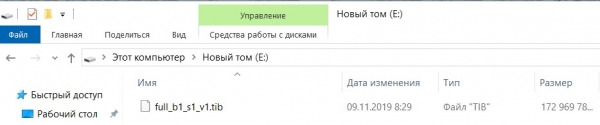
Dumpfilen komprimerades av kompressorerna RTT-Mid, 7-zip, WinRar. Kompressorerna WinRar och 7-zip ställdes in på maximal arbetskapacitet.
Kompressorn arbetar 7-zip:
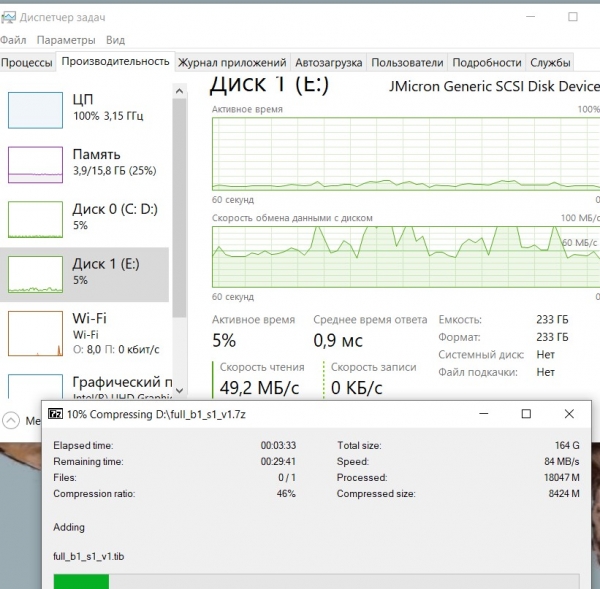
Den belastar processorn till 100%, med en genomsnittlig läshastighet av den ursprungliga dumpen på cirka 60 Megabyte/s.
Kompressorn arbetar WinRar:
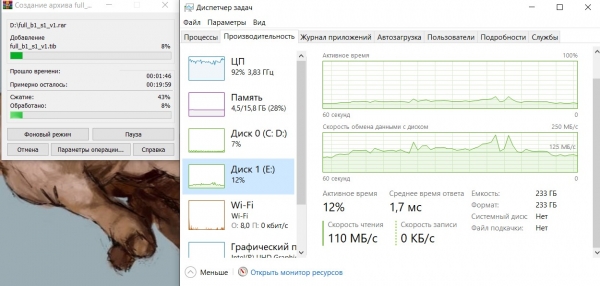
Situationen är liknande, processorbelastningen är nästan 100%, med en genomsnittlig läshastighet av dumpen på cirka 125 Megabyte/s.
Som i det föregående fallet begränsas arkiverarens hastighet av processorens kapacitet.
Nu körs testprogrammet för kompressorn RTT-Mid:
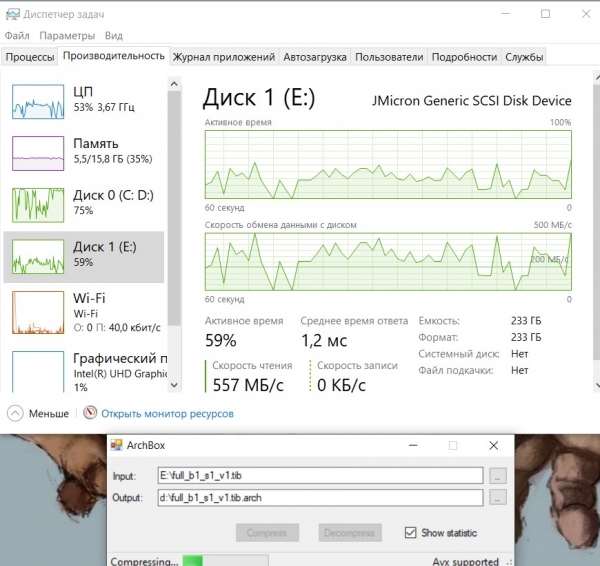
Skärmdumpen visar att processorn är belastad till 50% och är inaktiv resten av tiden, eftersom det inte finns något ställe att skriva ut de komprimerade data. Utdataklusteret (Disk 0) är nästan helt fullt. Hastigheten för dataläsning (Disk 1) fluktuerar kraftigt, men ligger i genomsnitt över 200 Megabyte/s.
I det här fallet begränsas kompressorens hastighet av möjligheten att skriva de komprimerade data på Disk 0.
Nu ser vi graden av komprimering av de resulterande arkiven:
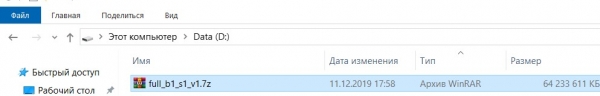
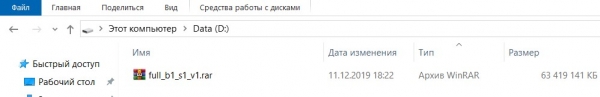
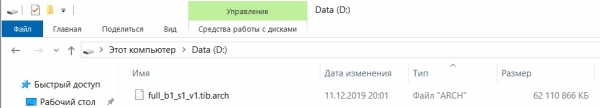
Det är tydligt att kompressorn RTT-Mid var bäst på komprimering; arkivet skapat av den är 1,3 Gigabyte mindre än arkivet från WinRar och 2,1 Gigabyte mindre än arkivet från 7z.
Tiden som lagts ned på att skapa arkivet:
- 7-zip – 26 minuter 10 sekunder;
- WinRar – 17 minuter 40 sekunder;
- RTT-Mid – 7 minuter 30 sekunder.
Därmed lyckades även det testprogram som inte var optimerat, med hjälp av algoritmen RTT-Mid, att skapa ett arkiv mer än två och en halv gång snabbare och arkivet blev betydligt mindre än konkurrenternas…
De som inte tror på skärmdumparna kan själva kontrollera deras äkthet. Testprogrammet finns tillgängligt på , ladda ner och kontrollera.
Men endast på processorer som stöder AVX-2. Utan stöd för dessa instruktioner fungerar kompressorn inte, och testa inte algoritmen på gamla AMD-processorer, de är långsamma när det gäller att utföra AVX-kommandon...
Den använda komprimeringsmetoden
Algoritmen använder en metod för indexering av upprepande textfragment i bytesgranulering. Denna komprimeringsmetod är gammal, men har inte använts eftersom sökoperationen efter matchningar var mycket resurskrävande och tog betydligt längre tid än att bygga en ordbok. Så algoritmen RTT-Mid är ett klassiskt exempel på en "tillbakagång till framtiden"...
I RTT-kompressorn används en unik snabb sökscanner för matchningar, det är just den som har möjliggjort att komprimeringsprocessen kan påskyndas. Scannern är egentillverkad, "det är min dyrgrip ...", "den kostar en hel del, eftersom den är helt handgjord" (skriven i assembler).
Matchningssökaren är genomförd med en tvånivå sannolikhetsschema; först scannas närvaron av en "indikator" för matchning, och endast efter att "indikatorn" har identifierats i denna plats aktiveras proceduren för att upptäcka den verkliga matchningen.
Fönstret för matchningssökning har en oförutsägbar storlek, beroende av graden av entropi i den bearbetade datablocket. För helt slumpmässiga (inte komprimerbara) data är storleken megabyte, medan data med upprepningar alltid har en storlek över en megabyte.
Men många moderna dataformat är inte komprimerbara, och att "köra" en resurskrävande scanner på dem är meningslöst och slöseri, därför finns det två arbetslägen i scannern. Först letas delar av den ursprungliga texten med möjliga upprepningar, denna operation utförs också med en sannolikhetsmetod och utförs mycket snabbt (i hastighet av 4-6 Gigabyte/s). Sedan behandlas de delar med möjliga matchningar av den huvudsakliga scannern.
Indexkompression är inte särskilt effektivt, man måste ersätta upprepande fragment med index, och indexmatrisen sänker kraftigt kompressionsförhållandet.
För att öka komprimeringsgraden indexeras inte bara fullständiga matchningar av byte-strängar, utan också partiella, när strängen innehåller matchande och icke-matchande byte. För detta inkluderar indexformatet ett fält för matchningsmask som anger de matchande byte för två block. För ännu större komprimering används indexering med överlappande flera delvis matchande block på det nuvarande blocket.
Allt detta har gjort det möjligt att i kompressorn RTT-Mid uppnå en komprimeringsgrad som kan jämföras med kompressorer som använder den ordbaserade metoden, men som arbetar mycket snabbare.
Hastigheten på den nya komprimeringsalgoritmen
Om kompressorn arbetar med monopoliserad användning av cache-minnet (4 Megabyte krävs för en tråd), varierar hastigheten mellan 700-2000 Megabyte/sekund per processor-kärna beroende på typen av komprimerade data och påverkas lite av processor-frekvensen.
Vid flertrådad implementering av kompressorn bestäms den effektiva skalbarheten av mängden tredje nivåns cache-minne. Till exempel, med 9 Megabyte cache-minne är det meningslöst att starta mer än två komprimeringsströmmar eftersom hastigheten inte kommer att öka. Men med 20 Megabyte cache kan man redan starta fem komprimeringsströmmar.
En annan betydande parameter som bestämmer kompressorns hastighet är latensen i det operativa minnet. Algoritmen använder slumpvisa åtkomster till RAM, varav en del inte når cache-minnet (ungefär 10%), och den måste vänta på data från RAM, vilket sänker hastigheten.
Systemarbetet med in- och utdata påverkar också avsevärt hastigheten på kompressorn. Frågor till RAM från in- och utdata blockerar åtkomsten till data från CPU, vilket också sänker komprimeringshastigheten. Detta problem är betydande för bärbara datorer och stationära datorer, för servrar det är mindre betydande tack vare en mer avancerad kontrollstruktur för åtkomst till systembussen och flerkanaligt RAM.
Överallt i texten i artikeln talas det om komprimering, medan dekompression ligger utanför denna artikel eftersom "allt är i sin ordning". Dekompression utförs betydligt snabbare och begränsas av in- och utdatahastigheten. Ett fysiskt kärna i en enda tråd kan enkelt uppnå upplösningshastigheter på 3-4 Gigabyte/s.
Detta beror på avsaknaden av matchningssökning i dekompressionsprocessen, som "äter upp" huvuddelen av CPU- och cache-minnesresurserna vid komprimering.
Tillförlitlighet i lagring av komprimerade data
Som titeln på hela klassen av programvaror som använder datakomprimering (arkivverktyg) antyder, är de avsedda för långsiktig lagring av information, inte för år utan för århundraden och årtusenden...
Under lagringstiden förlorar lagringsmedia en del av informationen, här är ett exempel:
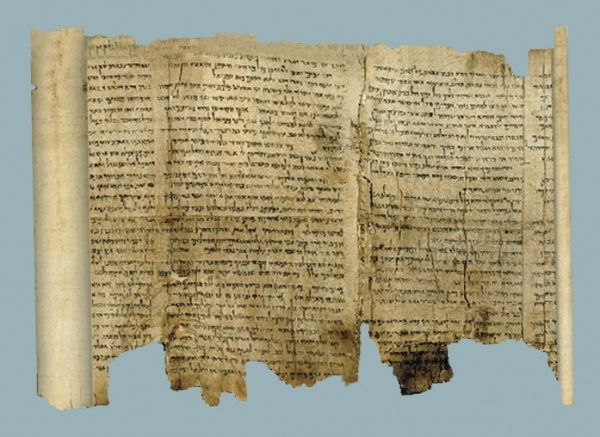
Detta "analoga" lagringsmedium är tusen år gammalt, vissa fragment har gått förlorade, men i stort sett är informationen "läsbar"...
Ingen av de ansvarsfulla tillverkarna av moderna digitala lagringssystem och digitala medier erbjuder garantier för fullständig informationsbevarande i mer än 75 år.
Och det är ett problem, men ett uppskjutet problem, som våra efterkommande kommer att behöva lösa...
Digitala datalagringssystem kan förlora data inte bara efter 75 år; databasfel kan inträffa när som helst, även under deras inspelning. Dessa förvrängningar försöker man minimera genom att använda redundans och korrigera med felkorrigeringssystem. Redundans och felkorrigeringssystem kan sällan återställa förlorad information, och om de gör det, finns det inga garantier för att återställningsoperationen var korrekt.
Och detta är också ett stort problem, men inte uppskjutet, utan ett aktuellt.
Moderna kompressorer som används för arkivering av digitala data är baserade på olika modifieringar av ordningsmetoden, och för sådana arkiv är förlust av information ett katastrofalt händelse; det finns till och med en etablerad term för en sådan situation — "korrupt" arkiv...
Den låga tillförlitligheten vid lagring av information i arkiv med ordbaserad kompression beror på strukturen hos de komprimerade uppgifterna. Informationen i ett sådant arkiv innehåller inte den ursprungliga texten, utan istället lagras poster med referenser i en ordbok som dynamiskt modifieras av den aktuella text som komprimeras. Vid förlust eller förvanskning av en del av arkivet blir det omöjligt att identifiera alla följande poster varken efter innehåll eller längd på referensen i ordboken, eftersom det inte går att förstå vad referensen motsvarar.
Det är omöjligt att återställa information från ett sådant "kaputt" arkiv.
RTT-algoritmen bygger på en mer tillförlitlig metod för lagring av komprimerade data. Den använder en indexmetod för att hantera upprepade fragment. Denna metod för kompression minimerar effekterna av information som förvanskas på lagringsmedium och korrigerar automatiskt förvanskningar som uppstår vid lagring av information i många fall.
Detta beror på att den arkiverade filen vid indexkompression innehåller två fält:
- ett fält för ursprunglig text med borttagna upprepningar;
- ett indexfält.
Indexfältet, som är avgörande för att återställa informationen, är inte stort till storleken och kan dupliceras för att säkerställa tillförlitligheten i datalagringen. Därför, även om en del av den ursprungliga texten eller indexmatrisen förloras, kan all annan information återställas utan problem, precis som på en bild med ett "analogt" informationslagringsmedium.
Nackdelar med algoritmen
Det finns inget utan nackdelar. Indexmetoden för kompression komprimerar inte upprepande sekvenser av liten längd. Detta beror på begränsningarna hos indexmetoden. Indexen är minst 3 byte långa och kan vara upp till 12 byte. Om det finns upprepningar med en storlek mindre än den som beskrivs av dess index, beaktas de inte, oavsett hur ofta sådana upprepningar förekommer i den komprimerade filen.
Den traditionella ordboksmetoden för komprimering komprimerar effektivt flera korta upprepningar och når därför en högre komprimeringsgrad än indexkomprimering. Detta uppnås dock på bekostnad av en hög belastning på CPU:n, vilket innebär att ordboksmetoden måste sänka databehandlingshastigheten till 10-20 megabyte per sekund på verkliga beräkningsinstallationer vid full CPU-belastning för att effektivt kunna komprimera data jämfört med indexmetoden.
Sådana låga hastigheter är oacceptabla för moderna datalagringssystem och utgör mer av ett 'akademiskt' intresse än ett praktiskt.
Graden av informationskomprimering kommer att öka avsevärt i nästa modifiering av RTT-algoritmen (RTT-Max), som redan är under utveckling.
Så som alltid, fortsättning följer…
Källa: habr.com
