

Hej, habr.
Om någon utnyttjar systemet och stöter på prestandaproblem med lagringen (IO, lagrat diskutrymme), så bör chansen att man överväger ClickHouse som en ersättning sträva mot en. Detta påstående innebär att en tredjepartsimplementation redan används som mottagande metrikdaemon, till exempel eller .
ClickHouse löser de beskrivna problemen väl. Till exempel, efter att ha flyttat 2TiB data från whisper, fick de plats i 300GiB. Jag kommer inte att gå in mer på jämförelsen, det finns gott om artiklar om detta. Dessutom har vårt ClickHouse-lager inte varit perfekt fram till nyligen.
Problem med upptaget utrymme
Vid första anblick borde allt fungera bra. Följande , skapar vi en konfiguration för lagringsschemat (nedan retention), sedan skapar vi en tabell enligt rekommendationen från den valda backend för graphite-web: + eller , beroende på vilken stack som används. Och... en tidsinställd bomb sätts igång.
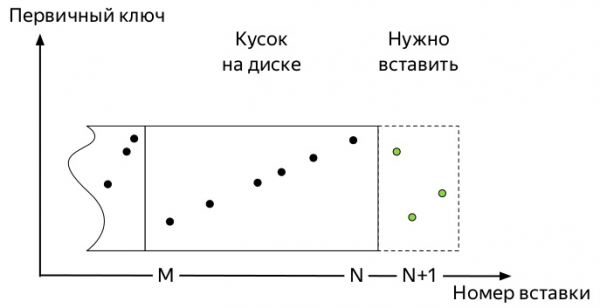
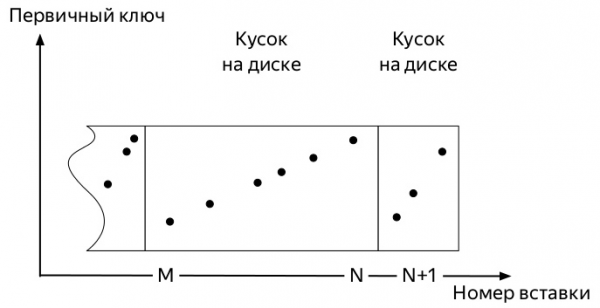
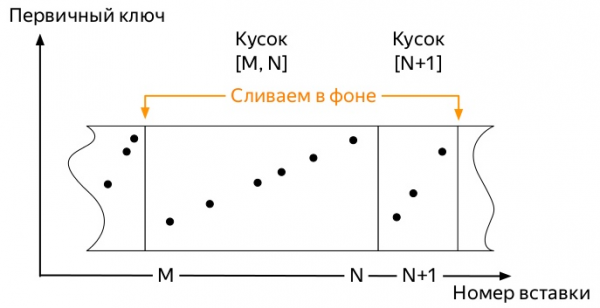
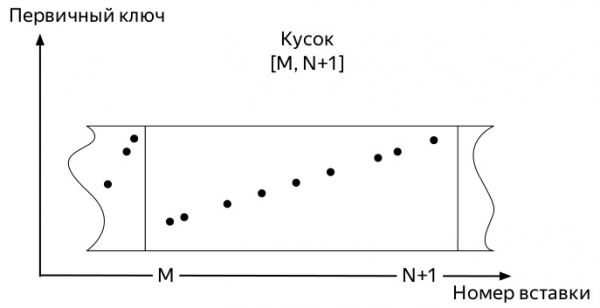
För att förstå vilken, måste man veta hur insättningarna fungerar och den fortsatta livscykeln för data i tabellerna från *MergeTree ClickHouse (diagrammen är hämtade från Aleksej Zatelepin):
- En
blockdata. I vårt fall är det metrikar som har ankommit.

- Varje sådan block sorteras enligt nyckeln
ORDER BY, specificerad vid skapandet av tabellen. - Efter sortering,
en del(part) data skrivs till disk.
- Servern övervakar i bakgrunden så att sådana delar inte blir för många, och kör bakgrunds-
sammanfogningarna(merge, därefter merges).
- Servern slutar automatiskt köra merges så snart inga data längre aktivt kommer in i
partition(partitionen, men kan manuellt startas med kommandotOPTIMIZEOPTIMIZE ... FINAL. - Så kommer de första metrikarna in. Och de tar upp ett visst utrymme. De efterföljande händelserna kan variera något beroende på många faktorer:
Partitioneringsnyckeln kan vara antingen mycket liten (dag) eller mycket stor (flera månader).
Retention-konfigurationen kan innefatta flera betydande trösklar för aggregering av data inom den aktiva partitionen (dit metrikarna skrivs), eller så kan den kanske inte.
- Partitionnyckeln kan vara både mycket liten (en dag) och mycket stor (flera månader).
- Retentionkonfigurationen kan rymma flera betydande datainsamlingsgränser inom den aktiva partitionen (dit mätvärdena skrivs), eller så kan den inte göra det.
- Om det finns mycket data, kommer de tidigaste bitarna, som på grund av bakgrundssammanslagningar redan kan vara stora (vid val av en suboptimal partitioneringsnyckel), inte att slås samman med de nya små bitarna.
Och allt avslutas alltid på samma sätt. Utrymmet som upptas av metrik i ClickHouse växer bara om:
- man inte tillämpar
Partitioneringsnyckeln kan vara antingen mycket liten (dag) eller mycket stor (flera månader).manuellt eller - inte sätter in data i alla partitioner kontinuerligt, för att förr eller senare kunna starta en bakgrundssammanslagning.
Den andra metoden verkar vara den enklaste att implementera och därför är den felaktig och prövades först.
Jag skrev ett ganska enkelt skript i Python som skickade falska metrik för varje dag under de senaste 4 åren och kördes varje timme av cron.
Eftersom hela arbetet i ClickHouse DBMS är baserat på att detta system förr eller senare kommer att göra allt det bakgrundsarbetet, men maskinens tidpunkt är okänd, lyckades jag inte vänta på att de gamla stora bitarna skulle ge sig till att börja sammanslås med de nya små. Det blev klart att jag behövde hitta ett sätt att automatisera tvingande optimeringar.
Informationen i systemtabellerna för ClickHouse
Låt oss titta på strukturen av tabellen . Det ger uttömmande information om varje bit av alla tabeller på ClickHouse-servern. Den innehåller bland annat följande kolumner:
- databasnamn (
database); - tabellnamn (
tabell); - partitionens namn och ID (
partitionen, men kan manuellt startas med kommandot&partition_id); - när biten skapades (
modification_time); - minimalt och maximalt datum i biten (partitioneringen sker dag för dag) (
min_date&max_date);
Det finns också en tabell , med följande intressanta fält:
- databasnamn (
Tables.database); - tabellnamn (
Tables.table); - metrikens ålder, när nästa aggregering ska tillämpas (
age);
Så:
- Vi har en tabell med bitar och en tabell med aggregeringsregler.
- Vi förenar deras snitt och får alla tabeller *GraphiteMergeTree.
- Vi letar efter alla partitioner där:
- mer än en bit
- eller det är dags att tillämpa nästa aggregeringsregel, och
modification_timeäldre än den punkten.
Implementering
Denna fråga
VÄLJ
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- Den "äldre" regeln som kan tillämpas på
    -- partitionen, men inte i framtiden, se (*)
    max(g.age) AS age,
    -- Antal delar i partitionen
    countDistinct(p.name) AS parts,
    -- Den äldsta mätningen i partitionen antas vara 00:00:00 nästa dag
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- När partitionen bör optimeras
    max_time + age AS rollup_time,
    -- När den äldsta delen i partitionen senast uppdaterades
    min(p.modification_time) AS modified_at
FRÅN system.parts AS p
INNER JOIN
(
    -- Alla regler för alla tabeller *GraphiteMergeTree
    VÄLJ
        Tables.database AS database,
        Tables.table AS table,
        age
    FRÅN system.graphite_retentions
    ARRAY JOIN Tables
    GRUPPERA EFTER
        database,
        table,
        age
) AS g PÅ
    (p.table = g.table)
    OCH (p.database = g.database)
DÄR
    -- Endast aktiva delar
    p.active
    -- (*) Och endast rader där aggregeringsregler redan bör tillämpas
    OCH ((toDateTime(p.max_date + 1) + g.age) < now())
GRUPPERA EFTER
    table,
    partition
HAVING
    -- Endast partitioner som är yngre än optimeringstidpunkten
    (modified_at  1)
ORDNA EFTER
    table ASC,
    partition ASC,
    age ASC
returnerar var och en av partitionerna i tabellerna *GraphiteMergeTree, vars sammanslagning bör leda till frigörande av diskutrymme. Nu återstår bara att göra det lilla: gå igenom dem alla med en fråga Partitioneringsnyckeln kan vara antingen mycket liten (dag) eller mycket stor (flera månader).. I den slutliga implementeringen har man även beaktat att partitioner med aktiv skrivning inte behöver beröras.
Det är precis det här som projektet gör . Tidigare kollegor från Yandex.Market har testat den i produktion, resultatet kan ses nedan.
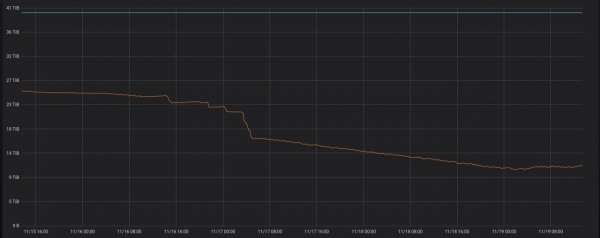
Om programmet körs på en server med ClickHouse kommer det enkelt att börja fungera i daemonläge. En gång i timmen kommer en fråga att köras för att kontrollera om nya partitioner äldre än tre dagar har dykt upp som kan optimeras.
I de närmaste planerna — att tillhandahålla åtminstone deb-paket, och om möjligt — även rpm.
Avslutande
Under de senaste 9 månaderna har jag inom mitt företag tillbringat mycket tid med att arbeta i skärningspunkten mellan ClickHouse och graphite-web. Det har varit en bra erfarenhet, resultatet av detta möjliggjorde en snabb övergång från whisper till ClickHouse som lagring av mätvärden. Jag hoppas att denna artikel — är något slags början på en serie om vilka förbättringar vi har gjort i olika delar av denna stack och vad som kommer att göras i framtiden.
Utvecklingen av förfrågan tog flera liter öl och ett antal admin-dagar tillsammans med , för vilket jag vill uttrycka min tacksamhet. Och även för att han recenserade denna artikel.
Källa: habr.com
