

Idag har REST API blivit standarden för utveckling av webbapplikationer och gör det möjligt att dela upp utvecklingen i oberoende delar. För UI används för närvarande olika populära ramverk som Angular, React, Vue och andra. Backend-utvecklare kan välja från ett stort utbud av språk och ramverk. Idag skulle jag vilja prata om ett ramverk som . Vi på använder det aktivt för interna projekt. Genom att använda nest och paketet , kommer vi att skapa en enkel CRUD-applikation.
Varför NestJS
Under den senaste tiden har det kommit många backend-ramverk i JavaScript-gemenskapen. Och om de erbjuder liknande funktioner som Nest, så vinner det definitivt på en punkt — dess arkitektur. Följande funktioner gör att NestJS kan skapa industriella applikationer och skala utvecklingen för stora team:
- användning av TypeScript som det primära utvecklingsspråket. Även om NestJS stöder JavaScript kan vissa funktioner sluta fungera, särskilt när det gäller externa paket;
- finnande av en DI-container som möjliggör skapande av löst kopplade komponenter;
- ramverkets funktionalitet är uppdelad i oberoende bytbara komponenter. Till exempel kan en underliggande ramverk vara antingen , såväl som , för att arbeta med databaser erbjuder nest ur låda bindningar till , , ;
- NestJS är plattformsoberoende och stödjer REST, GraphQL, Websockets, gRPC, etc.
Själva ramverket är inspirerat av frontend-ramverket Angular och har konceptuellt mycket gemensamt med det.
Installation av NestJS och distribution av projektet
Nest innehåller paketet /cli, который позволяет быстро развернуть базовый каркас приложения. Установим глобально данный пакет:
npm install --global @nest/cliEfter installationen genererar vi grunden för vår applikation med namnet nest-rest. Detta görs genom att använda kommandot nest new nest-rest.
nest new nest-rest
dmitrii@dmitrii-HP-ZBook-17-G3:~\/projects $ nest new nest-rest
  Vi kommer att skapa din app på några sekunder..

SKAPA \/nest-rest\/.prettierrc (51 byte)
SKAPA \/nest-rest\/README.md (3370 byte)
SKAPA \/nest-rest\/nest-cli.json (84 byte)
SKAPA \/nest-rest\/nodemon-debug.json (163 byte)
SKAPA \/nest-rest\/nodemon.json (67 byte)
SKAPA \/nest-rest\/package.json (1805 byte)
SKAPA \/nest-rest\/tsconfig.build.json (97 byte)
SKAPA \/nest-rest\/tsconfig.json (325 byte)
SKAPA \/nest-rest\/tslint.json (426 byte)
SKAPA \/nest-rest\/src\/app.controller.spec.ts (617 byte)
SKAPA \/nest-rest\/src\/app.controller.ts (274 byte)
SKAPA \/nest-rest\/src\/app.module.ts (249 byte)
SKAPA \/nest-rest\/src\/app.service.ts (142 byte)
SKAPA \/nest-rest\/src\/main.ts (208 byte)
SKAPA \/nest-rest\/test\/app.e2e-spec.ts (561 byte)
SKAPA \/nest-rest\/test\/jest-e2e.json (183 byte)

? Vilken paketförvaltare vill du ️ använda? yarn
 Installation pågår...

  Projektet nest-rest skapades framgångsrikt
  Kom igång med följande kommandon:

$ cd nest-rest
$ yarn run start

                         Tack för att du installerade Nest
                Överväg att donera till vår öppna kollektiva
                       för att hjälpa oss att underhålla detta paket.

                Donera: https:\/\/opencollective.com\/nest
Som paketförvaltare väljer vi yarn.
För närvarande kan du starta servern med kommandot npm start och för att komma åt adressen kan du se startsidan. Men vi har inte samlats här för detta, så vi går vidare.
Inställning för arbete med databasen
För denna artikel har jag valt PostgreSQL som databas. Man diskuterar inte om smak, men enligt min mening är det den mest mogna databasen med alla nödvändiga funktioner. Som redan nämnts, för att arbeta med databaser tillhandahåller Nest integration med olika paket. Eftersom mitt val föll på PostgreSQL, är det logiskt att välja TypeORM som ORM. Låt oss installera de nödvändiga paketen för databasintegrationen:
yarn add typeorm @nestjs\/typeorm pg
I ordning, vad varje paket behövs till:
- typeorm — paketet med själva ORM:en;
- @nestjs\/typeorm — TypeORM-paketet för NestJS. Lägger till moduler för import i projektmoduler, samt en uppsättning hjälpare dekoratorer;
- pg — drivrutinen för att arbeta med PostgreSQL.
Okej, paketen är installerade, nu behöver vi starta själva databasen. Jag kommer att använda docker-compose.yml med följande innehåll:
docker-compose.yml
version: '3.1'

services:
  db:
    image: postgres:11.2
    restart: always
    environment:
      POSTGRES_PASSWORD: example
    volumes:
      - ..\/db:\/var\/lib\/postgresql\/data
      - .\/postgresql.conf:\/etc\/postgresql\/postgresql.conf
    ports:
      - 5432:5432
  adminer:
    image: adminer
    restart: always
    ports:
      - 8080:8080
Som vi kan se konfigurerar denna fil starten av 2 containrar:
- db — detta är containern med databasen. I vårt fall används PostgreSQL version 11.2;
- adminer — databashanteraren. Tillhandahåller ett webbgränssnitt för att visa och hantera databasen.
För att arbeta med TCP-anslutningar har jag lagt till en konfiguration med följande innehåll.
postgresql.conf
# -----------------------------
# PostgreSQL configuration file
# -----------------------------
#
# This file consists of lines of the form:
#
# name = value
#
# (The "=" is optional.) Whitespace may be used. Comments are introduced with
# "#" anywhere on a line. The complete list of parameter names and allowed
# values can be found in the PostgreSQL documentation.
#
# The commented-out settings shown in this file represent the default values.
# Re-commenting a setting is NOT sufficient to revert it to the default value;
# you need to reload the server.
#
# This file is read on server startup and when the server receives a SIGHUP
# signal. If you edit the file on a running system, you have to SIGHUP the
# server for the changes to take effect, run "pg_ctl reload", or execute
# "SELECT pg_reload_conf()". Some parameters, which are marked below,
# require a server shutdown and restart to take effect.
#
# Any parameter can also be given as a command-line option to the server, e.g.,
# "postgres -c log_connections=on". Some parameters can be changed at run time
# with the "SET" SQL command.
#
# Memory units: kB = kilobytes Time units: ms = milliseconds
# MB = megabytes s = seconds
# GB = gigabytes min = minutes
# TB = terabytes h = hours
# d = days
#------------------------------------------------------------------------------
# FILE LOCATIONS
#------------------------------------------------------------------------------
# The default values of these variables are driven from the -D command-line
# option or PGDATA environment variable, represented here as ConfigDir.
#data_directory = 'ConfigDir' # use data in another directory
# (change requires restart)
#hba_file = 'ConfigDir/pg_hba.conf' # host-based authentication file
# (change requires restart)
#ident_file = 'ConfigDir/pg_ident.conf' # ident configuration file
# (change requires restart)
# If external_pid_file is not explicitly set, no extra PID file is written.
#external_pid_file = '' # write an extra PID file
# (change requires restart)
#------------------------------------------------------------------------------
# CONNECTIONS AND AUTHENTICATION
#------------------------------------------------------------------------------
# - Connection Settings -
listen_addresses = '*'
#listen_addresses = 'localhost' # what IP address(es) to listen on;
# comma-separated list of addresses;
# defaults to 'localhost'; use '*' for all
# (change requires restart)
#port = 5432 # (change requires restart)
#max_connections = 100 # (change requires restart)
#superuser_reserved_connections = 3 # (change requires restart)
#unix_socket_directories = '/tmp' # comma-separated list of directories
# (change requires restart)
#unix_socket_group = '' # (change requires restart)
#unix_socket_permissions = 0777 # begin with 0 to use octal notation
# (change requires restart)
#bonjour = off # advertise server via Bonjour
# (change requires restart)
#bonjour_name = '' # defaults to the computer name
# (change requires restart)
# - TCP Keepalives -
# see "man 7 tcp" for details
#tcp_keepalives_idle = 0 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
#tcp_keepalives_interval = 0 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
#tcp_keepalives_count = 0 # TCP_KEEPCNT;
# 0 selects the system default
# - Authentication -
#authentication_timeout = 1min # 1s-600s
#password_encryption = md5 # md5 or scram-sha-256
#db_user_namespace = off
# GSSAPI using Kerberos
#krb_server_keyfile = ''
#krb_caseins_users = off
# - SSL -
#ssl = off
#ssl_ca_file = ''
#ssl_cert_file = 'server.crt'
#ssl_crl_file = ''
#ssl_key_file = 'server.key'
#ssl_ciphers = 'HIGH:MEDIUM:+3DES:!aNULL' # allowed SSL ciphers
#ssl_prefer_server_ciphers = on
#ssl_ecdh_curve = 'prime256v1'
#ssl_min_protocol_version = 'TLSv1'
#ssl_max_protocol_version = ''
#ssl_dh_params_file = ''
#ssl_passphrase_command = ''
#ssl_passphrase_command_supports_reload = off
#------------------------------------------------------------------------------
# RESOURCE USAGE (except WAL)
#------------------------------------------------------------------------------
# - Memory -
#shared_buffers = 32MB # min 128kB
# (change requires restart)
#huge_pages = try # on, off, or try
# (change requires restart)
#temp_buffers = 8MB # min 800kB
#max_prepared_transactions = 0 # zero disables the feature
# (change requires restart)
# Caution: it is not advisable to set max_prepared_transactions nonzero unless
# you actively intend to use prepared transactions.
#work_mem = 4MB # min 64kB
#maintenance_work_mem = 64MB # min 1MB
#autovacuum_work_mem = -1 # min 1MB, or -1 to use maintenance_work_mem
#max_stack_depth = 2MB # min 100kB
#shared_memory_type = mmap # the default is the first option
# supported by the operating system:
# mmap
# sysv
# windows
# (change requires restart)
#dynamic_shared_memory_type = posix # the default is the first option
# supported by the operating system:
# posix
# sysv
# windows
# mmap
# (change requires restart)
# - Disk -
#temp_file_limit = -1 # limits per-process temp file space
# in kB, or -1 for no limit
# - Kernel Resources -
#max_files_per_process = 1000 # min 25
# (change requires restart)
# - Cost-Based Vacuum Delay -
#vacuum_cost_delay = 0 # 0-100 milliseconds (0 disables)
#vacuum_cost_page_hit = 1 # 0-10000 credits
#vacuum_cost_page_miss = 10 # 0-10000 credits
#vacuum_cost_page_dirty = 20 # 0-10000 credits
#vacuum_cost_limit = 200 # 1-10000 credits
# - Background Writer -
#bgwriter_delay = 200ms # 10-10000ms between rounds
#bgwriter_lru_maxpages = 100 # max buffers written/round, 0 disables
#bgwriter_lru_multiplier = 2.0 # 0-10.0 multiplier on buffers scanned/round
#bgwriter_flush_after = 0 # measured in pages, 0 disables
# - Asynchronous Behavior -
#effective_io_concurrency = 1 # 1-1000; 0 disables prefetching
#max_worker_processes = 8 # (change requires restart)
#max_parallel_maintenance_workers = 2 # taken from max_parallel_workers
#max_parallel_workers_per_gather = 2 # taken from max_parallel_workers
#parallel_leader_participation = on
#max_parallel_workers = 8 # maximum number of max_worker_processes that
# can be used in parallel operations
#old_snapshot_threshold = -1 # 1min-60d; -1 disables; 0 is immediate
# (change requires restart)
#backend_flush_after = 0 # measured in pages, 0 disables
#------------------------------------------------------------------------------
# WRITE-AHEAD LOG
#------------------------------------------------------------------------------
# - Settings -
#wal_level = replica # minimal, replica, or logical
# (change requires restart)
#fsync = on # flush data to disk for crash safety
# (turning this off can cause
# unrecoverable data corruption)
#synchronous_commit = on # synchronization level;
# off, local, remote_write, remote_apply, or on
#wal_sync_method = fsync # the default is the first option
# supported by the operating system:
# open_datasync
# fdatasync (default on Linux)
# fsync
# fsync_writethrough
# open_sync
#full_page_writes = on # recover from partial page writes
#wal_compression = off # enable compression of full-page writes
#wal_log_hints = off # also do full page writes of non-critical updates
# (change requires restart)
#wal_buffers = -1 # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
#wal_writer_delay = 200ms # 1-10000 milliseconds
#wal_writer_flush_after = 1MB # measured in pages, 0 disables
#commit_delay = 0 # range 0-100000, in microseconds
#commit_siblings = 5 # range 1-1000
# - Checkpoints -
#checkpoint_timeout = 5min # range 30s-1d
#max_wal_size = 1GB
#min_wal_size = 80MB
#checkpoint_completion_target = 0.5 # checkpoint target duration, 0.0 - 1.0
#checkpoint_flush_after = 0 # measured in pages, 0 disables
#checkpoint_warning = 30s # 0 disables
# - Archiving -
#archive_mode = off # enables archiving; off, on, or always
# (change requires restart)
#archive_command = '' # command to use to archive a logfile segment
# placeholders: %p = path of file to archive
# %f = file name only
# e.g. 'test ! -f /mnt/server/archivedir/%f && cp %p /mnt/server/archivedir/%f'
#archive_timeout = 0 # force a logfile segment switch after this
# number of seconds; 0 disables
# - Archive Recovery -
# These are only used in recovery mode.
#restore_command = '' # command to use to restore an archived logfile segment
# placeholders: %p = path of file to restore
# %f = file name only
# e.g. 'cp /mnt/server/archivedir/%f %p'
# (change requires restart)
#archive_cleanup_command = '' # command to execute at every restartpoint
#recovery_end_command = '' # command to execute at completion of recovery
# - Recovery Target -
# Set these only when performing a targeted recovery.
#recovery_target = '' # 'immediate' to end recovery as soon as a
# consistent state is reached
# (change requires restart)
#recovery_target_name = '' # the named restore point to which recovery will proceed
# (change requires restart)
#recovery_target_time = '' # the time stamp up to which recovery will proceed
# (change requires restart)
#recovery_target_xid = '' # the transaction ID up to which recovery will proceed
# (change requires restart)
#recovery_target_lsn = '' # the WAL LSN up to which recovery will proceed
# (change requires restart)
#recovery_target_inclusive = on # Specifies whether to stop:
# just after the specified recovery target (on)
# just before the recovery target (off)
# (change requires restart)
#recovery_target_timeline = 'latest' # 'current', 'latest', or timeline ID
# (change requires restart)
#recovery_target_action = 'pause' # 'pause', 'promote', 'shutdown'
# (change requires restart)
#------------------------------------------------------------------------------
# REPLICATION
#------------------------------------------------------------------------------
# - Sending Servers -
# Set these on the master and on any standby that will send replication data.
#max_wal_senders = 10 # max number of walsender processes
# (change requires restart)
#wal_keep_segments = 0 # in logfile segments; 0 disables
#wal_sender_timeout = 60s # in milliseconds; 0 disables
#max_replication_slots = 10 # max number of replication slots
# (change requires restart)
#track_commit_timestamp = off # collect timestamp of transaction commit
# (change requires restart)
# - Master Server -
# These settings are ignored on a standby server.
#synchronous_standby_names = '' # standby servers that provide sync rep
# method to choose sync standbys, number of sync standbys,
# and comma-separated list of application_name
# from standby(s); '*' = all
#vacuum_defer_cleanup_age = 0 # number of xacts by which cleanup is delayed
# - Standby Servers -
# These settings are ignored on a master server.
#primary_conninfo = '' # connection string to sending server
# (change requires restart)
#primary_slot_name = '' # replication slot on sending server
# (change requires restart)
#promote_trigger_file = '' # file name whose presence ends recovery
#hot_standby = on # "off" disallows queries during recovery
# (change requires restart)
#max_standby_archive_delay = 30s # max delay before canceling queries
# when reading WAL from archive;
# -1 allows indefinite delay
#max_standby_streaming_delay = 30s # max delay before canceling queries
# when reading streaming WAL;
# -1 allows indefinite delay
#wal_receiver_status_interval = 10s # send replies at least this often
# 0 disables
#hot_standby_feedback = off # send info from standby to prevent
# query conflicts
#wal_receiver_timeout = 60s # time that receiver waits for
# communication from master
# in milliseconds; 0 disables
#wal_retrieve_retry_interval = 5s # time to wait before retrying to
# retrieve WAL after a failed attempt
#recovery_min_apply_delay = 0 # minimum delay for applying changes during recovery
# - Subscribers -
# These settings are ignored on a publisher.
#max_logical_replication_workers = 4 # taken from max_worker_processes
# (change requires restart)
#max_sync_workers_per_subscription = 2 # taken from max_logical_replication_workers
#------------------------------------------------------------------------------
# QUERY TUNING
#------------------------------------------------------------------------------
# - Planner Method Configuration -
#enable_bitmapscan = on
#enable_hashagg = on
#enable_hashjoin = on
#enable_indexscan = on
#enable_indexonlyscan = on
#enable_material = on
#enable_mergejoin = on
#enable_nestloop = on
#enable_parallel_append = on
#enable_seqscan = on
#enable_sort = on
#enable_tidscan = on
#enable_partitionwise_join = off
#enable_partitionwise_aggregate = off
#enable_parallel_hash = on
#enable_partition_pruning = on
# - Planner Cost Constants -
#seq_page_cost = 1.0 # measured on an arbitrary scale
#random_page_cost = 4.0 # same scale as above
#cpu_tuple_cost = 0.01 # same scale as above
#cpu_index_tuple_cost = 0.005 # same scale as above
#cpu_operator_cost = 0.0025 # same scale as above
#parallel_tuple_cost = 0.1 # same scale as above
#parallel_setup_cost = 1000.0 # same scale as above
#jit_above_cost = 100000 # perform JIT compilation if available
# and query more expensive than this;
# -1 disables
#jit_inline_above_cost = 500000 # inline small functions if query is
# more expensive than this; -1 disables
#jit_optimize_above_cost = 500000 # use expensive JIT optimizations if
# query is more expensive than this;
# -1 disables
#min_parallel_table_scan_size = 8MB
#min_parallel_index_scan_size = 512kB
#effective_cache_size = 4GB
# - Genetic Query Optimizer -
#geqo = on
#geqo_threshold = 12
#geqo_effort = 5 # range 1-10
#geqo_pool_size = 0 # selects default based on effort
#geqo_generations = 0 # selects default based on effort
#geqo_selection_bias = 2.0 # range 1.5-2.0
#geqo_seed = 0.0 # range 0.0-1.0
# - Other Planner Options -
#default_statistics_target = 100 # range 1-10000
#constraint_exclusion = partition # on, off, or partition
#cursor_tuple_fraction = 0.1 # range 0.0-1.0
#from_collapse_limit = 8
#join_collapse_limit = 8 # 1 disables collapsing of explicit
# JOIN clauses
#force_parallel_mode = off
#jit = on # allow JIT compilation
#plan_cache_mode = auto # auto, force_generic_plan or
# force_custom_plan
#------------------------------------------------------------------------------
# REPORTING AND LOGGING
#------------------------------------------------------------------------------
# - Where to Log -
#log_destination = 'stderr' # Valid values are combinations of
# stderr, csvlog, syslog, and eventlog,
# depending on platform. csvlog
# requires logging_collector to be on.
# This is used when logging to stderr:
#logging_collector = off # Enable capturing of stderr and csvlog
# into log files. Required to be on for
# csvlogs.
# (change requires restart)
# These are only used if logging_collector is on:
#log_directory = 'log' # directory where log files are written,
# can be absolute or relative to PGDATA
#log_filename = 'postgresql-%Y-%m-%d_%H%M%S.log' # log file name pattern,
# can include strftime() escapes
#log_file_mode = 0600 # creation mode for log files,
# begin with 0 to use octal notation
#log_truncate_on_rotation = off # If on, an existing log file with the
# same name as the new log file will be
# truncated rather than appended to.
# But such truncation only occurs on
# time-driven rotation, not on restarts
# or size-driven rotation. Default is
# off, meaning append to existing files
# in all cases.
#log_rotation_age = 1d # Automatic rotation of logfiles will
# happen after that time. 0 disables.
#log_rotation_size = 10MB # Automatic rotation of logfiles will
# happen after that much log output.
# 0 disables.
# These are relevant when logging to syslog:
#syslog_facility = 'LOCAL0'
#syslog_ident = 'postgres'
#syslog_sequence_numbers = on
#syslog_split_messages = on
# This is only relevant when logging to eventlog (win32):
# (change requires restart)
#event_source = 'PostgreSQL'
# - When to Log -
#log_min_messages = warning # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic
#log_min_error_statement = error # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic (effectively off)
#log_min_duration_statement = -1 # logs statements and their durations
# according to log_statement_sample_rate. -1 is disabled,
# 0 logs all statement, > 0 logs only statements running at
# least this number of milliseconds.
#log_statement_sample_rate = 1 # Fraction of logged statements over
# log_min_duration_statement. 1.0 logs all statements,
# 0 never logs.
# - What to Log -
#debug_print_parse = off
#debug_print_rewritten = off
#debug_print_plan = off
#debug_pretty_print = on
#log_checkpoints = off
#log_connections = off
#log_disconnections = off
#log_duration = off
#log_error_verbosity = default # terse, default, or verbose messages
#log_hostname = off
#log_line_prefix = '%m [%p] ' # special values:
# %a = application name
# %u = user name
# %d = database name
# %r = remote host and port
# %h = remote host
# %p = process ID
# %t = timestamp without milliseconds
# %m = timestamp with milliseconds
# %n = timestamp with milliseconds (as a Unix epoch)
# %i = command tag
# %e = SQL state
# %c = session ID
# %l = session line number
# %s = session start timestamp
# %v = virtual transaction ID
# %x = transaction ID (0 if none)
# %q = stop here in non-session
# processes
# %% = '%'
# e.g. '<%u%%%d> '
#log_lock_waits = off # log lock waits >= deadlock_timeout
#log_statement = 'none' # none, ddl, mod, all
#log_replication_commands = off
#log_temp_files = -1 # log temporary files equal or larger
# than the specified size in kilobytes;
# -1 disables, 0 logs all temp files
#log_timezone = 'GMT'
#------------------------------------------------------------------------------
# PROCESS TITLE
#------------------------------------------------------------------------------
#cluster_name = '' # added to process titles if nonempty
# (change requires restart)
#update_process_title = on
#------------------------------------------------------------------------------
# STATISTICS
#------------------------------------------------------------------------------
# - Query and Index Statistics Collector -
#track_activities = on
#track_counts = on
#track_io_timing = off
#track_functions = none # none, pl, all
#track_activity_query_size = 1024 # (change requires restart)
#stats_temp_directory = 'pg_stat_tmp'
# - Monitoring -
#log_parser_stats = off
#log_planner_stats = off
#log_executor_stats = off
#log_statement_stats = off
#------------------------------------------------------------------------------
# AUTOVACUUM
#------------------------------------------------------------------------------
#autovacuum = on # Enable autovacuum subprocess? 'on'
# requires track_counts to also be on.
#log_autovacuum_min_duration = -1 # -1 disables, 0 logs all actions and
# their durations, > 0 logs only
# actions running at least this number
# of milliseconds.
#autovacuum_max_workers = 3 # max number of autovacuum subprocesses
# (change requires restart)
#autovacuum_naptime = 1min # time between autovacuum runs
#autovacuum_vacuum_threshold = 50 # min number of row updates before
# vacuum
#autovacuum_analyze_threshold = 50 # min number of row updates before
# analyze
#autovacuum_vacuum_scale_factor = 0.2 # fraction of table size before vacuum
#autovacuum_analyze_scale_factor = 0.1 # fraction of table size before analyze
#autovacuum_freeze_max_age = 200000000 # maximum XID age before forced vacuum
# (change requires restart)
#autovacuum_multixact_freeze_max_age = 400000000 # maximum multixact age
# before forced vacuum
# (change requires restart)
#autovacuum_vacuum_cost_delay = 2ms # default vacuum cost delay for
# autovacuum, in milliseconds;
# -1 means use vacuum_cost_delay
#autovacuum_vacuum_cost_limit = -1 # default vacuum cost limit for
# autovacuum, -1 means use
# vacuum_cost_limit
#------------------------------------------------------------------------------
# CLIENT CONNECTION DEFAULTS
#------------------------------------------------------------------------------
# - Statement Behavior -
#client_min_messages = notice # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# log
# notice
# warning
# error
#search_path = '"$user", public' # schema names
#row_security = on
#default_tablespace = '' # a tablespace name, '' uses the default
#temp_tablespaces = '' # a list of tablespace names, '' uses
# only default tablespace
#check_function_bodies = on
#default_transaction_isolation = 'read committed'
#default_transaction_read_only = off
#default_transaction_deferrable = off
#session_replication_role = 'origin'
#statement_timeout = 0 # in milliseconds, 0 is disabled
#lock_timeout = 0 # in milliseconds, 0 is disabled
#idle_in_transaction_session_timeout = 0 # in milliseconds, 0 is disabled
#vacuum_freeze_min_age = 50000000
#vacuum_freeze_table_age = 150000000
#vacuum_multixact_freeze_min_age = 5000000
#vacuum_multixact_freeze_table_age = 150000000
#vacuum_cleanup_index_scale_factor = 0.1 # fraction of total number of tuples
# before index cleanup, 0 always performs
# index cleanup
#bytea_output = 'hex' # hex, escape
#xmlbinary = 'base64'
#xmloption = 'content'
#gin_fuzzy_search_limit = 0
#gin_pending_list_limit = 4MB
# - Locale and Formatting -
#datestyle = 'iso, mdy'
#intervalstyle = 'postgres'
#timezone = 'GMT'
#timezone_abbreviations = 'Default' # Select the set of available time zone
# abbreviations. Currently, there are
# Default
# Australia (historical usage)
# India
# You can create your own file in
# share/timezonesets/.
#extra_float_digits = 1 # min -15, max 3; any value >0 actually
# selects precise output mode
#client_encoding = sql_ascii # actually, defaults to database
# encoding
# These settings are initialized by initdb, but they can be changed.
#lc_messages = 'C' # locale for system error message
# strings
#lc_monetary = 'C' # locale for monetary formatting
#lc_numeric = 'C' # locale for number formatting
#lc_time = 'C' # locale for time formatting
# default configuration for text search
#default_text_search_config = 'pg_catalog.simple'
# - Shared Library Preloading -
#shared_preload_libraries = '' # (change requires restart)
#local_preload_libraries = ''
#session_preload_libraries = ''
#jit_provider = 'llvmjit' # JIT library to use
# - Other Defaults -
#dynamic_library_path = '$libdir'
#------------------------------------------------------------------------------
# LOCK MANAGEMENT
#------------------------------------------------------------------------------
#deadlock_timeout = 1s
#max_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_relation = -2 # negative values mean
# (max_pred_locks_per_transaction
# / -max_pred_locks_per_relation) - 1
#max_pred_locks_per_page = 2 # min 0
#------------------------------------------------------------------------------
# VERSION AND PLATFORM COMPATIBILITY
#------------------------------------------------------------------------------
# - Previous PostgreSQL Versions -
#array_nulls = on
#backslash_quote = safe_encoding # on, off, or safe_encoding
#escape_string_warning = on
#lo_compat_privileges = off
#operator_precedence_warning = off
#quote_all_identifiers = off
#standard_conforming_strings = on
#synchronize_seqscans = on
# - Other Platforms and Clients -
#transform_null_equals = off
#------------------------------------------------------------------------------
# ERROR HANDLING
#------------------------------------------------------------------------------
#exit_on_error = off # terminate session on any error?
#restart_after_crash = on # reinitialize after backend crash?
#data_sync_retry = off # retry or panic on failure to fsync
# data?
# (change requires restart)
#------------------------------------------------------------------------------
# CONFIG FILE INCLUDES
#------------------------------------------------------------------------------
# These options allow settings to be loaded from files other than the
# default postgresql.conf.
#include_dir = 'conf.d' # include files ending in '.conf' from
# directory 'conf.d'
#include_if_exists = 'exists.conf' # include file only if it exists
#include = 'special.conf' # include file
#------------------------------------------------------------------------------
# CUSTOMIZED OPTIONS
#------------------------------------------------------------------------------
# Add settings for extensions hereDet var allt, nu kan vi starta containrarna med kommandot docker-compose up -d. Eller i en separat konsol med kommandot docker-compose up.
Så, paketen är installerade, databasen är igång, nu återstår det att sammanfoga dem. För detta behöver vi lägga till en fil som heter ormconfig.js med följande innehåll i projektets rot:
ormconfig.js
const process = require('process');

const username = process.env.POSTGRES_USER || "postgres";
const password = process.env.POSTGRES_PASSWORD || "example";

module.exports = {
  "type": "postgres",
  "host": "localhost",
  "port": 5432,
  username,
  password,
  "database": "postgres",
  "synchronize": true,
  "dropSchema": false,
  "logging": true,
  "entities": [__dirname + "/src/**/*.entity.ts", __dirname + "/dist/**/*.entity.js"],
  "migrations": ["migrations/**/*.ts"],
  "subscribers": ["subscriber/**/*.ts", "dist/subscriber/**/*.js"],
  "cli": {
    "entitiesDir": "src",
    "migrationsDir": "migrations",
    "subscribersDir": "subscriber"
  }
}
Den här konfigurationen kommer att användas för CLI TypeORM.
Låt oss titta närmare på denna konfiguration. På raderna 3 och 4 hämtar vi användarnamn och lösenord från miljövariabler. Detta är praktiskt när du har flera miljöer (dev, stage, prod, etc). Som standard är användarnamnet postgres, lösenordet är example. I övrigt är konfigurationen trivial, så vi stannar bara vid de mest intressanta parametrarna:
- synchronize — anger om databasens schema ska skapas automatiskt när applikationen startas. Var försiktig med detta alternativ och använd det inte i produktion, annars kan du förlora data. Detta alternativ är praktiskt vid utveckling och felsökning av applikationen. Som ett alternativ till detta alternativ kan du använda kommandot
schema:syncfrån CLI TypeORM. - dropSchema — att återställa schemat varje gång en anslutning upprättas. Precis som med det föregående, ska detta alternativ endast användas under utvecklings- och felsökningsprocessen.
- entities — vilka sökvägar som används för att leta efter modellbeskrivningar. Observera att sökningen stöder maskering.
- cli.entitiesDir — katalogen där modeller skapade från CLI TypeORM som standard bör placeras.
För att vi ska kunna använda alla funktioner av TypeORM i vår Nest-applikation måste vi importera modulen TypeOrmModule på AppModule. Det vill säga din AppModule att se ut på följande sätt:
app.module.ts
import { Module } from '@nestjs/common';
import { AppController } from './app.controller';
import { AppService } from './app.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import * as process from "process";

const username = process.env.POSTGRES_USER || 'postgres';
const password = process.env.POSTGRES_PASSWORD || 'example';

@Module({
  imports: [
    TypeOrmModule.forRoot({
      type: 'postgres',
      host: 'localhost',
      port: 5432,
      username,
      password,
      database: 'postgres',
      entities: [__dirname + '/**/*.entity{.ts,.js}'],
      synchronize: true,
    }),
  ],
  controllers: [AppController],
  providers: [AppService],
})
export class AppModule {}
Som du har märkt, i metoden forRoot skickas samma konfiguration för databasanslutning som i filen ormconfig.ts
Det sista steget är att lägga till några uppgifter för att arbeta med TypeORM i package.json. Eftersom CLI är skriven i javascript och körs i en nodejs-miljö, men alla våra modeller och migreringar kommer att skrivas i typescript, måste vi transpile våra migreringar och modeller innan vi använder CLI. Därför behöver vi paketet ts-node:
yarn add -D ts-node
Sedan lägger vi till de nödvändiga kommandona i package.json:
"typeorm": "ts-node -r tsconfig-paths/register ./node_modules/typeorm/cli.js",
"migration:generate": "yarn run typeorm migration:generate -n",
"migration:create": "yarn run typeorm migration:create -n",
"migration:run": "yarn run typeorm migration:run"
Det första kommandot, typeorm, lägger till en ts-node-wrapper för att köra TypeORM CLI. De andra kommandona är praktiska genvägar som du som utvecklare kommer att använda nästan varje dag:
migration:generate — skapar en migrering baserad på ändringar i dina modeller.
migration:create — skapar en tom migrering.
migration:run — kör migreringar.
Nu är allt klart, vi har lagt till de nödvändiga paketen, konfigurerat applikationen för att arbeta med databasen både via CLI och direkt från applikationen, och vi har även startat databashanteringssystemet. Det är dags att lägga till logik i vår applikation.
Installation av paket för att skapa CRUD
Bara med Nest kan man skapa ett API som möjliggör att skapa, läsa, uppdatera och ta bort en enhet. Denna lösning är mycket flexibel men kan vara överdriven i vissa fall. Till exempel, om du snabbt behöver skapa en prototyp kan du ofta avstå från flexibiliteten till förmån för snabbare utveckling. Många ramverk erbjuder funktionalitet för att generar CRUD baserat på en datamodell av en viss enhet. Och Nest är inget undantag! Denna funktionalitet erbjuds av paketet . Dess möjligheter är ganska intressanta:
- lätt installation och konfiguration;
- oberoende av databashanteringssystem;
- ett kraftfullt frågespråk med stöd för filter, paginering, sortering, relationsladdning och nästlade entiteter, caching, osv.;
- ett paket för att skapa förfrågningar på front-end;
- enkelt att åsidosätta metoder i kontrollern;
- en liten konfiguration;
- stöd för swagger-dokumentation.
Funktionaliteten är indelad i flera paket:
- — ett grundpaket som tillhandahåller dekoreraren () för att generera rutter, konfiguration och validering;
- — ett paket som erbjuder en builder/parser för förfrågningar att använda på front-end;
- — ett paket för integration med TypeORM, som erbjuder den grundläggande tjänsten TypeOrmCrudService med CRUD-metoder för att arbeta med entiteter i databasen.
I denna handledning behöver vi paketen jsx/crud och jsx/crud-typeorm. För att börja, installera dem
yarn add @nestjsx/crud class-transformer class-validatorPaket och i denna applikation behövs för att deklarativt beskriva reglerna för transformation av instanser av modeller och validering av inkommande förfrågningar. Dessa paket är från samma författare, så gränssnitten liknar varandra.
Direkt implementering av CRUD
Som exempel på modell tar vi en lista över användare. Användarna kommer att ha följande fält: id, username, displayName, e-post. id — ett autoinkrementellt fält, e-post och username — unika fält. Enkelt! Nu kvarstår det bara att förverkliga vår idé som en Nest-applikation.
För att börja måste vi skapa en modul users, som kommer att ansvarar för att hantera användarna. Vi använder CLI:t från NestJS, och i rotmappen av vårt projekt kör vi kommandot nest g module users.
nest g module users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g module users
CREATE /src/users/users.module.ts (82 bytes)
UPDATE /src/app.module.ts (312 bytes)
I denna modul lägger vi till en mapp för entiteter, där våra modellfiler kommer att ligga. I synnerhet lägger vi hit filen user.entity.ts med beskrivningen av användarmodellen:
user.entity.ts
import { Column, Entity, PrimaryGeneratedColumn } from 'typeorm';

@Entity()
export class User {
  @PrimaryGeneratedColumn()
  id: string;

  @Column({unique: true})
  email: string;

  @Column({unique: true})
  username: string;

  @Column({nullable: true})
  displayName: string;
}
För att vår applikation ska "se" denna modell, måste vi importera den i modulen UsersModule users.module.ts TypeOrmModule med följande innehåll:
import { Module } from '@nestjs/common'; import { UsersController } from './controllers/users/users.controller'; import { UsersService } from './services/users/users.service'; import { TypeOrmModule } from '@nestjs/typeorm'; import { User } from './entities/user.entity';@Module({ controllers: [UsersController], providers: [UsersService], imports: [ TypeOrmModule.forFeature([User]) ] }) export class UsersModule {}
import { Module } from '@nestjs/common';
import { UsersController } from './controllers/users/users.controller';
import { UsersService } from './services/users/users.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import { User } from './entities/user.entity';

@Module({
  controllers: [UsersController],
  providers: [UsersService],
  imports: [
    TypeOrmModule.forFeature([User])
  ]
})
export class UsersModule {}
D.v.s här importerar vi TypeOrmModule, där vi anger listan över modeller relaterade till denna modul som metodparameter. forFeature skapar vi en lista över modeller som tillhör den här modulen.
Återstår att skapa motsvarande entitet i databasen. För dessa ändamål finns migrationsmekanismen. För att skapa en migration baserad på ändringarna i modellerna, måste vi köra kommandot npm run migration:generate -- CreateUserTable:
Spoiler Rubrik
$ npm run migration:generate -- CreateUserTable
Migration /home/dmitrii/projects/nest-rest/migrations/1563346135367-CreateUserTable.ts har genererats framgångsrikt.
Klart på 1.96s.
Vi behövde inte skriva migrationen för hand, allt hände på ett magiskt sätt. Är inte det ett under! Men det är inte allt. Låt oss titta på den skapade migrationsfilen:
1563346135367-CreateUserTable.ts
import {MigrationInterface, QueryRunner} from "typeorm";

export class CreateUserTable1563346816726 implements MigrationInterface {

    public async up(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`CREATE TABLE "user" ("id" SERIAL NOT NULL, "email" character varying NOT NULL, "username" character varying NOT NULL, "displayName" character varying, CONSTRAINT "UQ_e12875dfb3b1d92d7d7c5377e22" UNIQUE ("email"), CONSTRAINT "UQ_78a916df40e02a9deb1c4b75edb" UNIQUE ("username"), CONSTRAINT "PK_cace4a159ff9f2512dd42373760" PRIMARY KEY ("id"))`);
    }

    public async down(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`DROP TABLE "user"`);
    }

}
Som vi kan se har det automatiskt genererats inte bara en metod för att köra migrationen, utan också en metod för att ångra den. Fantastiskt!
Återstår bara att köra denna migration. Det görs med följande kommando:
npm run migration:run.Nu har förändringarna i schemat överförts till databasen.
Därefter skapar vi en tjänst som kommer att ansvara för hanteringen av användarna och ärver den från TypeOrmCrudService. I den överordnade konstruktorparams måste vi ange den repository för den intressanta entiteten, i vårt fall Användare repository.
users.service.ts
import { Injectable } from '@nestjs/common';
import { TypeOrmCrudService } from '@nestjsx/crud-typeorm';
import { User } from '../../entities/user.entity';
import { InjectRepository } from '@nestjs/typeorm';
import { Repository } from 'typeorm';

@Injectable()
export class UsersService extends TypeOrmCrudService{
  constructor(@InjectRepository(User) usersRepository: Repository){
    super(usersRepository);
  }
}
Denna tjänst kommer vi att behöva i kontrollern users. För att skapa en controller, skriv i terminalen nest g controller users/controllers/users
nest g controller users/controllers/users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g controller users/controllers/users
SKAPA /src/users/controllers/users/users.controller.spec.ts (486 bytes)
SKAPA /src/users/controllers/users/users.controller.ts (99 bytes)
UPPDATERA /src/users/users.module.ts (188 bytes)
Vi öppnar den här kontrollern och redigerar den för att lägga till lite magi jsx/crud. Till klassen UsersController lägger vi till en dekoratör av följande slag:
@Crud({
  model: {
    type: User
  }
}) — en dekoratör som lägger till nödvändiga metoder i kontrollern för att arbeta med modellen. Typen av modellen anges i fältet model.type dekoratorns konfiguration.
Det andra steget är att implementera gränssnittet CrudController. "I samlingen" ser koden för kontrollern ut som följer:
import { Controller } from '@nestjs/common';
import { Crud, CrudController } from '@nestjsx/crud';
import { User } from '../../entities/user.entity';
import { UsersService } from '../../services/users/users.service';

@Crud({
  model: {
    type: User
  }
})
@Controller('users')
export class UsersController implements CrudController{
  constructor(public service: UsersService){}
}
Och det är allt! Nu stödjer kontrollern hela uppsättningen operationer med modellen! Tvekar du? Låt oss prova vår applikation i praktiken!
Skapa en förfrågningsscenarie i TestMace
För att testa vår tjänst kommer vi att använda en IDE för att arbeta med API . Varför TestMace? Jämfört med liknande produkter har det följande fördelar:
- kraftfull hantering av variabler. Just nu finns det flera typer av variabler, var och en med en specifik roll: inbyggda variabler, dynamiska variabler, miljövariabler. Varje variabel tillhör en nod med stöd för ärvningsmekanism;
- enkelt skapande av scenarier utan programmering. Det kommer vi att prata mer om nedan;
- läsbart format som gör det möjligt att spara projekt i versionshanteringssystem;
- autokomplettering, syntaxmarkering, variabelvärdesmarkering;
- stöd för API-beskrivning med möjlighet till import från Swagger.
Låt oss starta vår server med kommandot npm start och försöka hämta listan över användare. Enligt vår kontrollkonfiguration kan listan över användare fås via url localhost:3000/users. Låt oss göra en förfrågan till denna url.
Efter att ha startat TestMace kan du se ett sådant gränssnitt:
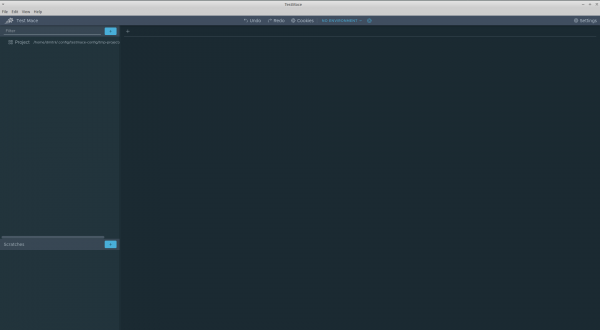
Till vänster högst upp finns projektträdet med en rotknut . Låt oss försöka skapa vår första förfrågan för att hämta listan över användare. För detta skapar vi en nod. Detta görs i snabbmenyn för Project-noden Lägg till nod -> RequestStep.
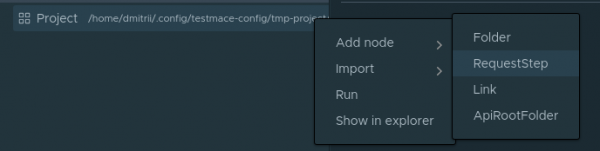
I fältet URL klistrar du in localhost:3000/users och utför förfrågan. Vi får 200 kod med en tom array i svaret. Det är förståeligt, vi har fortfarande inte lagt till någon.
Låt oss skapa ett scenario som kommer att inkludera följande steg:
- skapa en användare;
- förfrågan efter id för den nyss skapade användaren;
- borttagning av id för användaren som skapades i steg 1.
Så, låt oss köra. För enkelhetens skull skapar vi en nod av typen . I grunden är detta bara en mapp där vi kommer att spara hela scenariet. För att skapa en nod av type Folder måste vi välja Lägg till nod -> Mapp. Vi kallar noden check-create. Inuti noden check-create skapar vi vår första förfrågan för att skapa en användare. Vi kommer att kalla den nyss skapade noden create-user. Så just nu kommer hierarkin av noder att se ut på följande sätt:
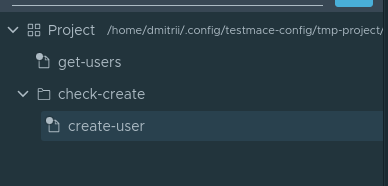
Låt oss gå till fliken för den öppna create-user noden. Vi anger följande parametrar för förfrågan:
- Förfrågestyp – POST
- URL – localhost:3000/users
- Body – JSON med värdet
{"email": "user@user.com", "displayName": "New user", "username": "user"}
Vi utför denna förfrågan. Vår applikation säger att posten har skapats.
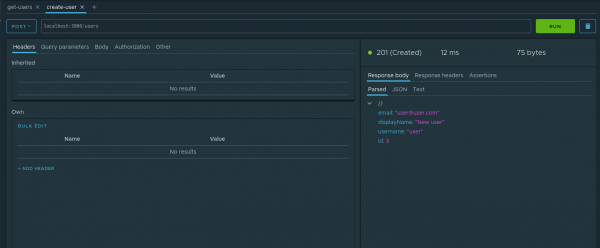
Nåväl, låt oss kontrollera detta faktum. För att kunna arbeta med id:t för den skapade användaren i de följande stegen, är det nödvändigt att spara denna parameter. För detta ändamål passar mekanismen . Låt oss i vårt exempel titta på hur man arbetar med dem. I fliken parsed av svaret för nodens id, måste vi välja alternativet Tilldela till variabel. I dialogrutan måste vi ange följande parametrar:
- Node — i vilken av förfäderna vi ska skapa den dynamiska variabeln. Vi väljer check-create
- Variabelnamn — namnet på denna variabel. Vi kallar den
userId.
Så här ser processen för att skapa en dynamisk variabel ut:
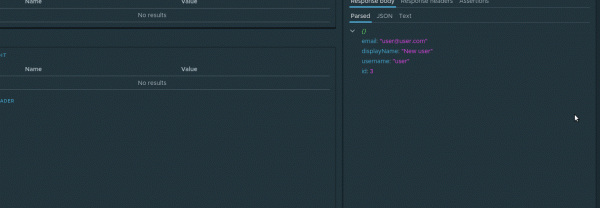
Nu kommer värdet av den dynamiska variabeln att uppdateras varje gång denna förfrågan utförs. Och eftersom dynamiska variabler stöder mekanismen för hierarkiskt arv, kommer variabeln userId att vara tillgänglig i efterkommande check-create noder på alla nivåer av inbäddning.
I nästa förfrågan kommer denna variabel att vara användbar för oss. Vi kommer specifikt att begära den nyss skapade användaren. Som ett barn till noden check-create skapar vi förfrågan check-if exists med parametern url lika med localhost:3000/users/${$dynamicVar.userId}. Konstruktionen av typen ${variable_name} är hämtningen av värdet på variabeln. Eftersom vi har en dynamisk variabel, måste vi för att få den, hänvisa till objektet $dynamicVar, d.v.s. den fullständiga hänvisningen till den dynamiska variabeln userId ser ut som följande ${$dynamicVar.userId}. Vi utför förfrågan och ser till att datan hämtas korrekt.
Den sista touchen återstår – att göra en begäran om borttagning. Den behövs inte bara för att kontrollera borttagningens funktion utan också för att, så att säga, städa upp efter sig i databasen, eftersom fälten email och användarnamn är unika. Så, i noden check-create skapar vi en begäran delete-user med följande parametrar
- Typ av begäran – DELETE
- URL –
localhost:3000/users/${$dynamicVar.userId}
Vi startar. Väntar. Njut av resultatet)
Nu kan vi när som helst köra detta scenario helt. För att starta scenariot behöver du välja i kontextmenyn check-create noden punkten Run.
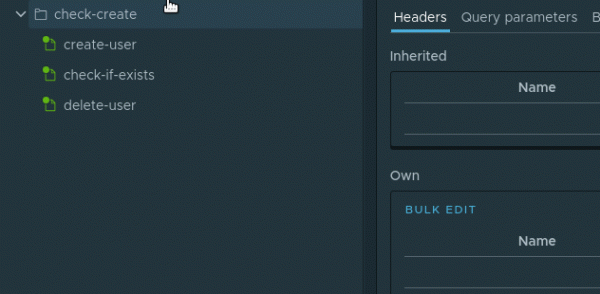
Noderna i scenariot kommer att utföras efter varandra
Detta scenario kan du spara i ditt projekt genom att utföra File -> Save project.
Slutsats
I formatet för denna artikel kunde vi helt enkelt inte få plats med alla funktioner av de använda verktygen. När det gäller den huvudsakliga orsaken – paketet jsx/crud – förblev följande ämnen outforskade:
- anpassad validering och transformation av modeller;
- ett kraftfullt frågespråk och dess bekväma användning på fronten;
- överskrivning och tillägg av nya metoder i crud-kontroller;
- stöd för swagger;
- cachehantering.
Men även det som beskrivs i artikeln är tillräckligt för att förstå att även ett så företagsinriktat ramverk som NestJS har verktyg för snabb prototypbyggnad av applikationer. Och en så fantastisk IDE som möjliggör att hålla ett bestämt tempo.
Källkoden för denna artikel, tillsammans med projektet , finns tillgänglig i repot . För att öppna projektet är det tillräckligt att utföra File -> Open project.
Källa: habr.com
