

Jag stötte på en uppgift av följande slag. Det är nödvändigt att implementera en datalagringsbehållare som tillhandahåller följande funktionalitet:
- lägg till ett nytt element
- ta bort ett element efter dess ordningsnummer
- hämta ett element efter dess ordningsnummer
- data lagras i sorterad ordning
Data läggs ständigt till och tas bort, strukturen måste säkerställa snabb hastighet. I början försökte jag implementera något sådant med hjälp av standardbehållare från std. Den vägen var inte framgångsrik, och jag kom till insikten att jag behövde implementera något själv. Det enda som kom i minnet var att använda ett binärt sökträd. Eftersom det uppfyller kraven för snabb inläggning, borttagning och lagring av data i sorterad ordning. Nu återstod bara att lista ut hur man ska indexera alla element och räkna om indexen när trädet förändras.
struct node_s {
    data_t data;

    uint64_t weight; // nodens vikt

    node_t *left;
    node_t *right;

    node_t *parent;
};
I artikeln kommer det att vara fler bilder och teori än kod. Koden kan ses via länken nedan.
Vikt
För detta utsattes trädet för en liten modifiering, ytterligare information om vikt noden. Vikten av en nod är antalet efterkommande av denna nod + 1 (vikten av en enda enhet).
Funktionen för att få nodens vikt:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
För ett blad är vikten därför lika med 0.
Låt oss nu gå vidare till en visuell representation av ett exempel på ett sådant träd. Med svart färg kommer nyckeln på noden att visas (värdet visas inte, eftersom det inte är nödvändigt), med röd — nodens vikt, med grön — nodens index.
När trädet är tomt är dess vikt 0. Låt oss lägga till rootelementet:
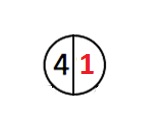
Vikten av trädet blir 1, vikten av rootelementet är 1. Vikten av rootelementet är vikt för trädet.
Låt oss lägga till några fler element:
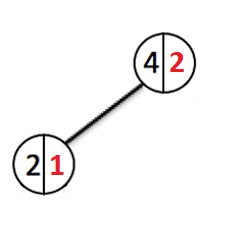
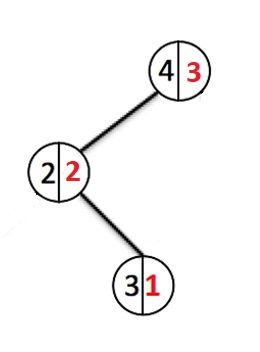
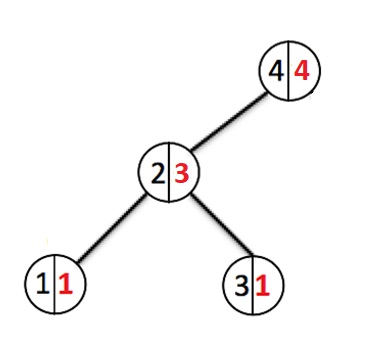
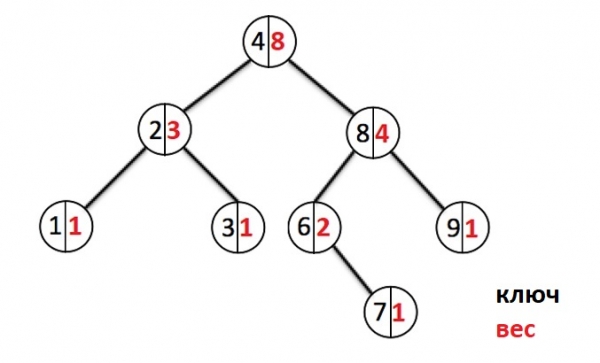
Varje gång ett nytt element läggs till, går vi ner genom noderna och ökar viktvärdet för varje passerad nod. När en ny nod skapas får den vikten 1. Om en nod med en sådan nyckel redan finns, skriver vi om värdet och går tillbaka upp till roten, vilket återställer viktvärdena för alla de noder vi passerat.
Om en nod tas bort, går vi neråt och minskar vikten för de passerade noderna.
Index
Låt oss nu gå vidare till hur man indexerar noder. Noderna lagrar uppenbarligen inte sitt index, utan det beräknas utifrån nodernas vikt. Om de skulle lagra sitt index skulle det kräva O(n) tid för att uppdatera indexen för alla noder efter varje ändring av trädet.
Vi går vidare till en visuell representation. Vårt träd är tomt, vi lägger till den första noden:
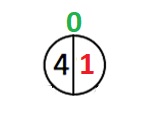
Den första noden har index 0, och nu finns det två möjliga fall. I det första fallet kommer rotnodens index att ändras, i det andra kommer det inte att förändras.
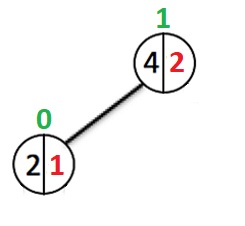
Roten har ett vänster delträd med vikten 1.
Det andra fallet:
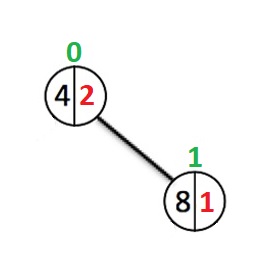
Indexet för roten har inte ändrats, eftersom vikten av dess vänstra delträd förblev 0.
Hur indexet för en nod beräknas, är vikten av dess vänstra delträd plus det tal som ges av föräldern. Vad är det här talet? Det är indexräknaren, som initialt är 0, eftersom roten inte har någon förälder. Sedan beror allt på om vi går ner till vänster barn eller höger. Om vi går till vänster, så läggs inget till indexräknaren. Om vi går till höger, då lägger vi till indexet för den aktuella noden.
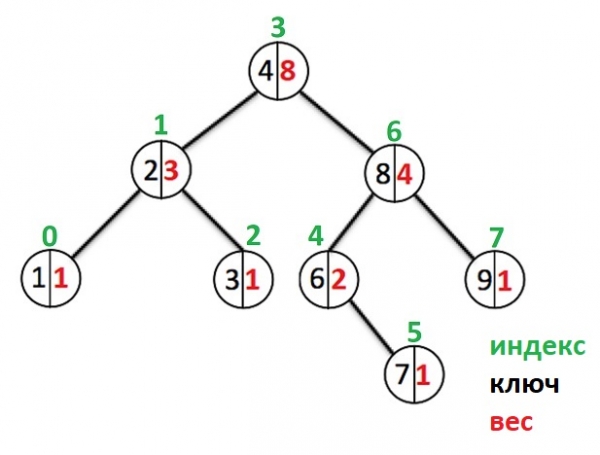
Till exempel hur indexet för elementet med nyckeln 8 (höger barn av roten) beräknas. Det är "Index för roten" + "vikten av den vänstra delträdet av noden med nyckeln 8" + "1" == 3 + 2 + 1 == 6
Indexet för elementet med nyckeln 6 kommer att vara "Index för roten" + 1 == 3 + 1 == 4
Följaktligen, för att få, ta bort ett element efter index krävs tid O(log n), eftersom för att få det önskade elementet måste vi först hitta det (gå ner från roten till detta element).
Djup
Utifrån vikten kan man också beräkna djupet på trädet. Detta behövs för balansering.
För detta måste vikten av den aktuella noden avrundas till det första talet som är en potens av 2 som är större än eller lika med den angivna vikten och ta den binära logaritmen av det. På så sätt får vi djupet på trädet, under förutsättning att det är balanserat. Trädet balanseras efter att en ny nod har lagts till. Jag kommer inte att ge teorin om hur man balanserar träd. I källkoderna presenteras en balansfunktion.
Kod för att konvertera vikt till djup.
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Sammanfattning
- insättning av en ny nod sker på O(log n)
- borttagning av ett element enligt ordningsnummer sker på O(log n)
- hämtning av ett element enligt ordningsnummer sker på O(log n)
Hastighet O(log n) vi betalar för att alla data lagras i sorterad ordning.
Jag vet inte var en sådan struktur kan vara användbar. Det är bara en uppgift för att förstå hur träd fungerar. Tack för uppmärksamheten.
Länkar
Projektet innehåller testdata för att kontrollera hastigheten. Trädet fylls med 1000000 element. Det sker sekventiell borttagning, insättning och hämtning av element 1000000 gång. Det vill säga 3000000 operationer. Resultatet visade sig vara ganska bra ~ 8 sekunder.
Källa: habr.com
