

Hej, Habr!
Jag arbetar i Tinkoff-teamet som utvecklar vårt eget notifieringscenter. Större delen av tiden utvecklar jag i Java med hjälp av Spring Boot och löser olika tekniska problem som uppstår i projektet.
De flesta av våra mikrotjänster kommunicerar asynkront med varandra via en meddelandebroker. Tidigare använde vi IBM MQ som broker, men den klarade inte belastningen längre, trots att den hade höga leveransgarantier.
Som ett alternativ fick vi Apache Kafka, som har hög skalbarhet, men tyvärr kräver en nästan skräddarsydd konfiguration för olika scenarier. Dessutom tillät mekanismen för åtminstone en leverans, som fungerar i Kafka som standard, inte att upprätthålla den nödvändiga nivån av konsistens direkt. Jag kommer nu att dela vår erfarenhet av att konfigurera Kafka, särskilt hur man ställer in och lever med exakt en leverans.
Garanti för leverans och mer
Parametrarna som vi kommer att diskutera nedan kan hjälpa till att förebygga vissa problem med standardanslutningsinställningar. Men först vill jag fokusera på en parameter som underlättar eventuell felsökning.
Detta kommer att hjälpa med client.id för Producer och Consumer. Vid första anblick kan man använda applikationens namn som värde, och i de flesta fall fungerar det. Dock kan situationen där flera Consumers används i applikationen och man ger dem samma client.id leda till följande varning:
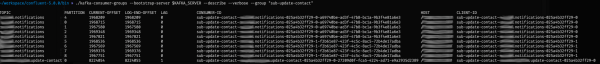
org.apache.kafka.common.utils.AppInfoParser — Fel vid registrering av AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Om du vill använda JMX i en applikation med Kafka kan detta bli ett problem. I detta fall är det bäst att använda en kombination av applikationens namn och till exempel ämnets namn som värde för client.id. Resultatet av vår konfiguration kan ses i utmatningen av kommandot kafka-consumer-groups från verktygen från Confluent:
Nu ska vi gå igenom scenariot för garanterad leverans av meddelanden. Kafka Producer har en parameter acks, som tillåter konfigurationen av efter hur många acknowledgments som klusterledaren bör betrakta meddelandet som framgångsrikt skrivet. Denna parameter kan ta följande värden:
- 0 — acknowledgments kommer inte att räknas.
- 1 — standard parameter, acknowledgement is only required from 1 replica.
- −1 — acknowledgement is required from all synchronized replicas (cluster configuration) min.insync.replicas).
From the listed values, it is clear that acks equal to −1 provide the strongest guarantees that the message will not be lost.
As we all know, distributed systems are unreliable. To protect against temporary failures, Kafka Producer provides the parameter retries, which allows you to specify the number of retry attempts during delivery.timeout.ms. Since the retries parameter defaults to Integer.MAX_VALUE (2147483647), the number of message retries can be controlled by only changing delivery.timeout.ms.
Moving towards exactly once delivery
The listed settings allow our Producer to deliver messages with a high guarantee. Now let’s talk about how to ensure that only one copy of the message is written to the Kafka topic? In the simplest case, for this the Producer needs to set the parameter enable.idempotence to true. Idempotence guarantees that only one message is written to a specific partition of one topic. A prerequisite for enabling idempotence is the values acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. If these parameters are not set by the developer, the above values will be automatically assigned.
When idempotence is configured, it is necessary to ensure that the same messages go to the same partitions every time. This can be done by configuring the key and the partitioner.class parameter on the Producer. Let’s start with the key. It must be the same for each delivery. This is easily achieved by using some business identifier from the original message. The partitioner.class parameter defaults to . With this default partitioning strategy, we do the following:
- If the partition is explicitly specified when sending the message, use it.
- If no partition is specified but a key is provided — choose the partition based on the hash of the key.
- If neither partition nor key is specified — select partitions in a round-robin manner.
In addition, using the key and idempotent sending with the parameter max.in.flight.requests.per.connection = 1 ger en ordnad behandling av meddelanden i Consumer. Det är viktigt att komma ihåg att om din kluster har inställningar för åtkomstkontroll, så kommer du att behöva rättigheter för idempotent skrivning till ämnet.
Om du plötsligt saknar funktioner för idempotent sändning baserat på nyckel eller logik på Producer-sidan kräver bevarande av datakonsistens mellan olika partitioner, så kan transaktioner hjälpa. Dessutom kan du med hjälp av kedjetransaktioner villkorsbundet synkronisera skrivningen i Kafka, till exempel med skrivningen i en databas. För att aktivera transaktionell sändning på Producer måste den ha idempotens och dessutom ange transactional.id. Om din Kafka-kluster har inställningar för åtkomstkontroll, så krävs det också rättigheter för transaktionell skrivning, precis som för idempotent skrivning, som kan tillhandahållas med en mask med hjälp av värdet som lagras i transactional.id.
Formellt kan vilken sträng som helst användas som transaktionsidentifierare, till exempel programmets namn. Men om du kör flera instanser av samma program med samma transactional.id, då kommer den första instansen som startas att stoppas med ett fel, eftersom Kafka kommer att betrakta den som en zombiprocess.
org.apache.kafka.common.errors.ProducerFencedException: Producenten försökte göra en operation med en gammal epok. Antingen finns det en nyare producent med samma transactionalId, eller så har producentens transaktion löpt ut av broker.För att lösa det här problemet lägger vi till ett suffix till applikationsnamnet som är värdnamnet, vilket vi får från miljövariablerna.
Producenten är konfigurerad, men transaktioner i Kafka hanterar endast meddelandets synlighet. Oavsett transaktionens status, går meddelandet direkt till ämnet men får ytterligare systemattribut.
För att sådana meddelanden inte ska läsas av Consumer innan tiden, måste den ställa in parametern isolation.level till värdet read_committed. En sådan Consumer kan läsa icke-transaktionella meddelanden som tidigare, medan transaktionella endast kan läsas efter commit.
Om du har ställt in alla tidigare nämnda inställningar, så har du konfigurerat exakt en gång-leverans. Grattis!
Men det finns en annan nuance. Transactional.id, som vi konfigurerade ovan, är faktiskt en prefix för transaktionen. Till transaktionshanteraren läggs ett sekvensnummer till. Den identifierare som erhålls utfärdas för transactional.id.expiration.ms, som konfigureras på en Kafka-kluster och har ett standardvärde på "7 dagar". Om applikationen under denna tid inte har mottagit några meddelanden kommer du vid nästa transaktionella sändning att få InvalidPidMappingException. Därefter kommer transaktionskoordinatorn att tilldela ett nytt sekvensnummer för nästa transaktion. Medan detta meddelande kan gå förlorat om InvalidPidMappingException inte hanteras korrekt.
Istället för sammanfattningar
Som man kan se är det inte tillräckligt att bara skicka meddelanden till Kafka. Man måste välja en kombination av parametrar och vara beredd på att göra snabba förändringar. I den här artikeln har jag försökt visa i detalj hur man konfigurerar exakt engångsleverans och beskrivit flera konfigurationsproblem med client.id och transactional.id som vi stött på. Nedan, i korthet, är inställningarna för Producer och Consumer.
Producer:
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — för ordnad sändning)
- transactional.id = ${application-name}-${hostname}
Consumer:
- isolation.level = read_committed
För att minimera fel i framtida applikationer har vi gjort vårt eget wrapper över spring-konfigurationen, där värden redan är angivna för några av de angivna parametrarna.
Här är ett par resurser för självstudier:
Källa: habr.com
