

Det är känt att en CTO:s kompetens bara prövas vid andra åket i denna roll. Eftersom det är en sak att arbeta i ett företag i flera år, utvecklas tillsammans med det och, därmed, gradvis ta på sig mer ansvar i samma kulturella kontext. Och något helt annat är att direkt gå in i rollen som teknisk chef i ett företag med en massa legacy och en hel del problem som noggrant sopats under mattan.
I det här avseendet är erfarenheten av Leon Fayer, som han delade på , inte direkt unik, men av den summan som han fått efter 20 år i olika roller, är den mycket användbar. Nedan finns en tidslinje över händelserna under 90 dagar och många roliga anekdoter som man kan skratta åt när de händer någon annan, men som inte är så roliga att stöta på personligen.
Leon berättar mycket färgstarkt på ryska, så om du har 35-40 minuter rekommenderar jag att titta på videon. Den textbaserade versionen hittar du nedan för att spara tid.
Den första versionen av rapporten var en välstrukturerad beskrivning av arbetet med människor och processer, innehållande nyttiga rekommendationer. Men den fångade inte alla överraskningar som dök upp längs vägen. Därför ändrade jag formatet och redogjorde för de problem som dök upp i det nya företaget som en ande ur en flaska, och metoderna för att lösa dem i kronologisk ordning.
En månad före
Som många goda historier började denna med alkohol. Vi satt med bekanta på en bar, och som vanligt i IT-kretsar klagade alla på sina problem. En av dem hade just bytt jobb och berättade om sina svårigheter både med teknologin och med människor, och med teamet. Ju mer jag lyssnade, desto mer insåg jag att han bara behövde anställa mig, eftersom det var just sådana problem jag hade löst de senaste 15 åren. Så jag sa det till honom, och nästa dag träffades vi redan i en arbetsmiljö. Företaget kallades Teaching Strategies.
Teaching Strategies är ledande på marknaden för utbildningsprogram för mycket små barn - från födseln till tre års ålder. Det traditionella "papper"-företaget har funnits i cirka 40 år, medan den digitala SaaS-versionen av plattformen har funnits i 10. För relativt kort tid sedan inleddes processen att anpassa den digitala teknologin till företagets standarder. Den "nya" versionen lanserades 2017 och var nästan som den gamla, förutom att den fungerade sämre.
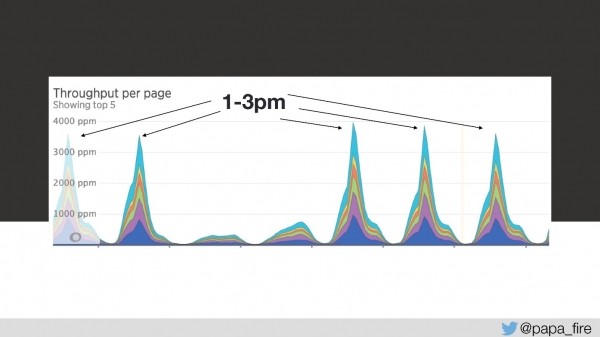
Det mest intressanta är att trafiken hos det här företaget är väldigt förutsägbar — dag för dag, år efter år, kan man väldigt tydligt förutsäga hur många människor som kommer och när. Till exempel, mellan klockan 13 och 15 på eftermiddagen går alla barn i förskolorna och sover, medan lärarna börjar mata in information. Och så här sker det varje dag, förutom på helgerna, eftersom nästan ingen arbetar då.
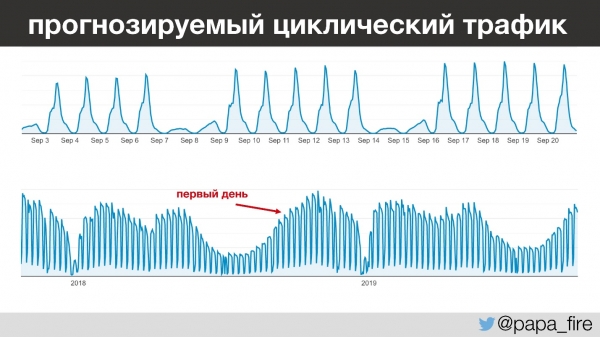
För att gå händelserna i förväg kan jag nämna att jag började mitt arbete under perioden med den största årliga trafiken, vilket är intressant av olika skäl.
Plattformen, som verkar ha funnits i bara 2 år, hade en slags stack: ColdFusion & SQL Server 2008. ColdFusion, om ni inte vet, vilket ni förmodligen inte gör, är en typ av enterprise PHP som kommit ut i mitten av 90-talet, och jag har inte hört något om det sedan dess. Det fanns också: Ruby, MySQL, PostgreSQL, Java, Go, Python. Men den huvudsakliga monoliten körde på ColdFusion och SQL Server.
Problem
Ju mer jag pratade med företagets anställda om arbetet och de problem som uppstod, desto mer insåg jag att problemen inte bara var av teknisk natur. Visst, teknologin var gammal — vi hade arbetat med gammal teknologi, men det fanns problem med teamet och processerna, och företaget började förstå detta.
Traditionellt satt teknikerna i hörnet och sysslade med sitt eget arbete. Men mer och mer av verksamheten började ske genom den digitala versionen. Så det fanns nya tillägg till företaget under det senaste året innan jag började: en styrelse, CTO, CPO och QA-chef. Det vill säga, företaget började investera i den teknologiska sfären.
Tecken på tungt arv fanns inte bara i systemen. Företaget hade legacy-processer, legacy-människor, legacy-kultur. Allt detta behövde ändras. Jag tänkte att det säkerligen inte skulle bli tråkigt och beslutade mig för att prova.
Två dagar före
Två dagar innan min nya anställning anlände jag till kontoret, fyllde i de sista papperna, träffade teamet och upptäckte att teamet vid den tiden kämpade med ett problem. Problemet var att den genomsnittliga laddningstiden för sidor hade stigit till 4 sekunder, det vill säga i dubbelt så lång tid.
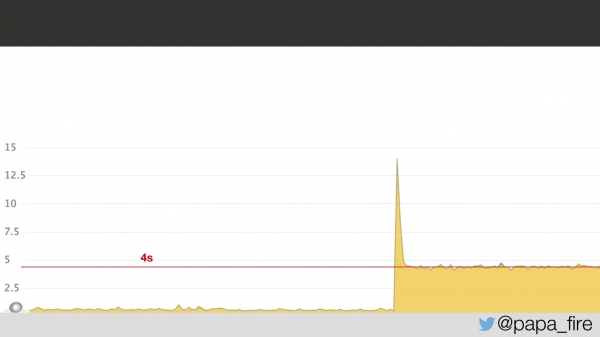
Enligt grafen hade något uppenbarligen hänt, men vad vet jag inte. Det visade sig att problemet låg i nätverks latens i datacentret: 5 ms latens i datacentret omvandlades till 2 sekunder för användarna. Varför det blev så visste jag inte, men det blev i alla fall känt att problemet låg i datacentret.
Dag ett
Två dagar hade gått, och på min första arbetsdag upptäckte jag att problemet fortfarande var kvar.
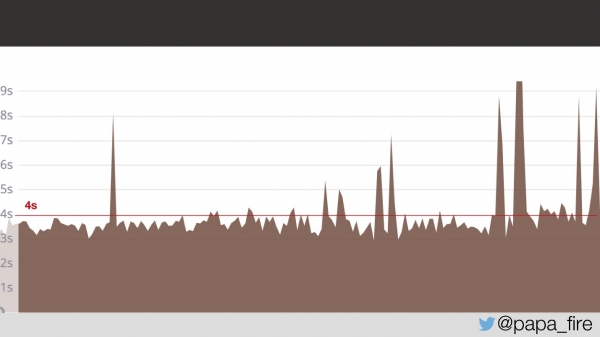
Under de två dagarna laddades sidorna för användarna i genomsnitt på 4 s. Jag frågade om de hade kommit fram till vad problemet var.
— Ja, vi har öppnat ett ärende.
— Och?
— Tja, de har ännu inte svarat oss.
Då insåg jag att allt jag fått höra tidigare bara var en liten del av isberget som vi måste kämpa emot.
Det finns ett bra citat som passar bra i det här fallet:
«Ibland krävs det att man förändrar organisationen för att förändra teknologin».
Men eftersom jag började arbeta under den mest hektiska tiden på året var jag tvungen att titta på båda lösningsalternativen: både kortsiktigt och långsiktigt. Och börja med det som var kritiskt just nu.
Dag tre
Så, inläsningen tar 4 sekunder, och mellan 13 och 15 är det de största topparna.
På den tredje dagen såg inläsningen ut så här under den tidsperioden:
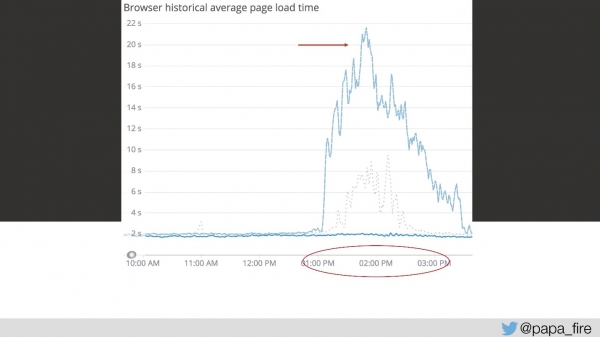
Från mitt perspektiv fungerade ingenting överhuvudtaget. Från allas perspektiv gick det dock något långsammare än vanligt. Men det går inte bara så — det är ett allvarligt problem.
Jag försökte övertyga teamet, men de sa bara att vi behövde fler servrar. Det är förstås en lösning på problemet, men långt ifrån den enda och mest effektiva. Jag frågade varför servrarna inte räckte, vilken trafikvolym vi hade. Jag extrapolerade data och kom fram till att vi hade ungefär 150 förfrågningar per sekund, vilket i stort sett ligger inom rimliga gränser.
Men vi får inte glömma att innan man får rätt svar måste man ställa rätt fråga. Min nästa fråga var: hur många frontend-servrar har vi. Svaret förvånade mig lite — vi hade 17 frontend-servrar!
— Jag vågar knappt fråga, 150 delat med 17 blir det ungefär 8? Menar ni att varje server hanterar 8 förfrågningar per sekund, och om det imorgon blir 160 förfrågningar per sekund, så behöver vi ytterligare 2 servrar?
Självklart behövde vi inga fler servrar. Lösningen låg i själva koden och var ganska uppenbar:
var currentClass = classes.getCurrentClass();
return currentClass;
Det fanns en funktion getCurrentClass(), eftersom allt på sidan fungerar i kontexten av en klass — det är sant. Och just denna funktion hade på varje sida 200+ förfrågningar.
Lösningen var därmed väldigt enkel, man behövde inte ens skriva om något: man behövde bara undvika att begära samma information flera gånger.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Jag blev mycket glad eftersom jag trodde att jag hade hittat det största problemet redan den tredje dagen. Hur naiv jag var, det var bara ett av många problem.
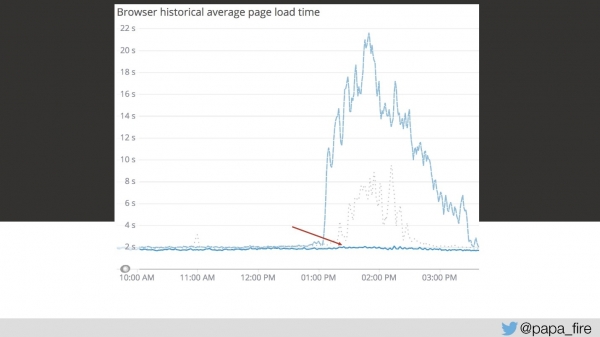
Men lösningen av det första problemet sänkte tidsplanen betydligt.
Samtidigt jobbade vi med andra optimeringar. Det fanns många uppenbara saker som kunde åtgärdas. Till exempel, den tredje dagen upptäckte jag att det faktiskt fanns en cache i systemet (först trodde jag att alla förfrågningar gick direkt från databasen). När jag tänker på cache, föreställer jag mig standard Redis eller Memcached. Men bara jag tänkte så, eftersom MongoDB och SQL Server användes för caching i det systemet — samma databas som vi just hade läst data från.
Dag tio
Den första veckan sysslade jag med problem som behövde åtgärdas omedelbart. Någonstans under andra veckan deltog jag för första gången i en standup för att prata med teamet, se vad som hände och hur hela processen fortskred.
Återigen upptäcktes något intressant. Teamet bestod av: 18 utvecklare; 8 testare; 3 managare; 2 arkitekter. Och alla deltog i de gemensamma ritualerna, vilket innebar att fler än 30 personer kom till standup varje morgon och berättade vad de hade gjort. Det var uppenbart att mötet inte tog 5 eller 15 minuter. Ingen lyssnade på varandra eftersom alla arbetade på olika system. I sådant format var 2-3 biljetter per timme under grooming sessionen redan ett bra resultat.
Det första vi gjorde var att dela upp teamet i flera linjer baserat på produkter. För olika sektioner och system utsåg vi separata team som inkluderade utvecklare, testare, produktchefer och affärsanalytiker.
Resultatet blev:
- Kortsade ner på standups och möten.
- Ämneskunskap om produkten.
- Känsla av ägande. När människor tidigare ofta roterade mellan systemen visste de att någon annan troligtvis skulle behöva jobba med deras buggar, men inte de själva.
- Samarbete mellan grupper. Det behöver inte sägas att QA inte kommunicerade mycket med programmerarna tidigare, produktchefen gjorde sitt eget och så vidare. Nu hade de en gemensam ansvarspunkt.
Vi fokuserade främst på effektivitet, prestanda och kvalitet — dessa var de problem vi försökte lösa genom att omvandla teamet.
Dag elva
I processen av att ändra teamstrukturen upptäckte jag hur man beräknar BerättelsePoäng. 1 SP motsvarade en dag, och varje ticket innehöll SP för både utveckling och QA, vilket betyder minst 2 SP.
Hur upptäckte jag detta?
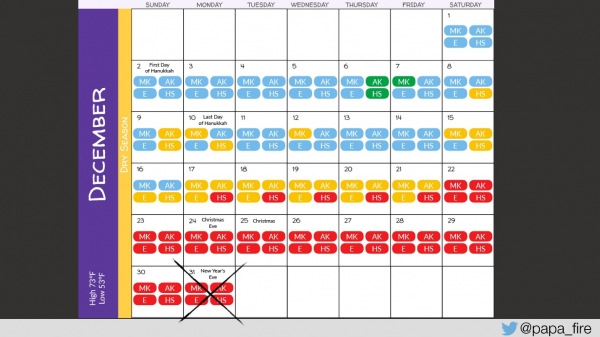
Vi hittade en bugg: i en av rapporterna, där start- och slutdatum för den önskade rapporten anges, beaktas inte den sista dagen. Det vill säga i någonstans i frågan fanns det inte <=, utan bara <. Jag fick höra att detta var tre Story Points, vilket betyder 3 dagar.
Efter detta gjorde vi:
- Vi granskade systemet för att bedöma Story Points. Nu når upptäckten av små buggar, som snabbt kan köras genom systemet, snabbare ut till användaren.
- Vi började sammanföra relaterade tickets för utveckling och testning. Tidigare var varje ticket, varje bugg en isolerad ekosystem, obunden till något annat. Att ändra tre knappar på en sida kunde ha varit tre olika tickets med tre olika QA-processer istället för ett automatiserat test på sidan.
- Vi började arbeta med utvecklarna kring tillvägagångssättet för att uppskatta arbetsinsatsen. Tre dagar för att byta en knapp — det är inte roligt.
Dag tjugo
Någonstans vid mitten av den första månaden stabiliserades situationen något, jag hade fått grepp om vad som huvudsakligen pågick och började redan se mot framtiden och tänka på långsiktiga lösningar.
Bevara kompatibilitet med git-repositoriets diskformat (utan att bevara kompatibilitet med verktyg);
- En hanterad plattform. Hundratals förfrågningar på varje sida — det är orealistiskt.
- Förutsägbara trender. Det fanns periodiska trafiktoppar som vid första anblicken inte korrelerade med andra mätvärden — vi behövde förstå varför detta inträffar och lära oss att förutsäga.
- Utvidgning av plattformen. Företaget växer ständigt, fler och fler användare kommer, trafiken ökar.
Tidigare brukade vi ofta säga: „Låt oss skriva om allt i [språk/ramverk], allt kommer att fungera bättre!“
I de flesta fall fungerar det inte, det är bra om det som skrivs om ens fungerar alls. Så vi behövde skapa en roadmap — en konkret strategi som illustrerar steg för steg hur affärsmålen kommer att uppnås (vad vi kommer att göra och varför), som:
- reflekterar projektets mission och mål;
- prioriterar kärnmål;
- innehåller en tidslinje för deras uppnåelse.
Inga tidigare samtal hade förts med teamet om syftet bakom några förändringar. Rätta framgångsmått behövs för detta. För första gången i företagets historia har vi satt KPI:er för den tekniska gruppen, och dessa mått kopplades till organisationen.
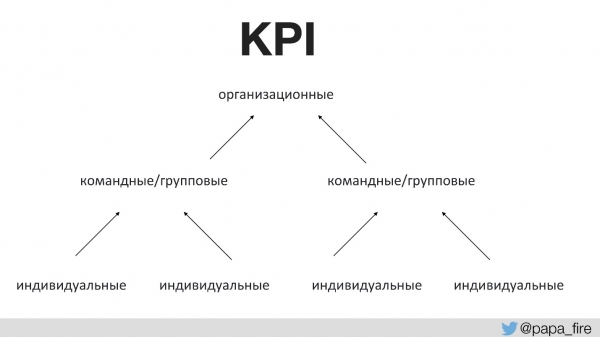
Det vill säga att organisatoriska KPI:er stöds av teamen, och teamets KPI:er stöds sedan av individer. Annars, om de tekniska KPI:erna inte stämmer överens med de organisatoriska, drar varje person åt sitt håll.
Till exempel, en av de organisatoriska KPI:erna är att öka marknadsandelen genom nya produkter.
Vad kan stödja målet att ha fler nya produkter?
- För det första vill vi ägna mer tid åt att utveckla nya produkter istället för att åtgärda fel. Detta är en logisk lösning som är lätt att mäta.
- För det andra vill vi stödja en ökning av transaktionsvolymen, för ju större marknadsandel, desto fler användare och därmed mer trafik.
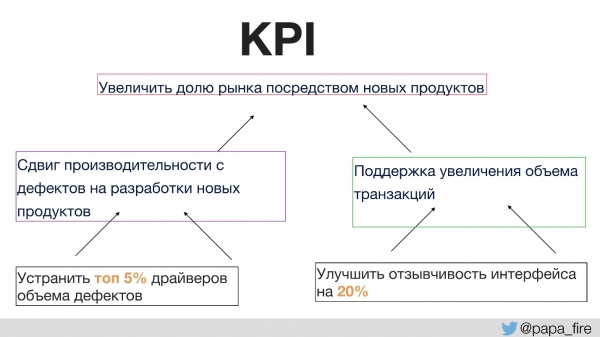
Då kan individuella KPI:er, som kan utföras inom gruppen, till exempel handla om den plats varifrån de största felen kommer. Om vi fokuserar just på den sektionen kan vi minska antalet fel mycket, vilket i sin tur ökar tiden för att utveckla nya produkter och återigen stödja de organisatoriska KPI:erna.
Därmed ska varje beslut, inklusive att skriva om koden, stödja specifika mål som företaget har ställt upp för oss (organisationsväxt, nya funktioner, rekrytering av personal).
Under denna process framkom en intressant sak, som blev en nyhet inte bara för de tekniska, utan för hela företaget: alla ticketar måste vara inriktade på minst en KPI. Det vill säga, om produktägaren säger att de vill skapa en ny funktion, ska den första frågan ställas: 'Vilken KPI stöder den här funktionen?' Om ingen, så är det tyvärr en onödig funktion.
Tredje dagen
I slutet av månaden upptäckte jag en annan detalj, att ingen i mitt Ops-team någonsin hade sett avtalen vi gör med kunderna. Du kan fråga dig varför man ska se avtalen.
- För det första, eftersom SLA:erna är skrivna i avtalen.
- För det andra är SLA olika. Varje kund kom med sina egna krav, och försäljningsavdelningen skrev under utan att titta.
En annan intressant detalj — i kontraktet med en av de största kunderna står det att alla versioner av programvaran som plattformen stöder måste vara n-1, det vill säga inte den senaste versionen, utan näst senaste.
Det är tydligt hur långt borta vi var från n-1, när plattformen var på ColdFusion och SQL Server från 2008, som man slutade stödja helt i juli.
Dag fyrtiofem
Någonstans vid mitten av andra månaden hade jag tillräckligt med tid för att sätta mig ner och göra valuestreammapping helt över hela processen. Det är nödvändiga steg som måste vidtas, från att skapa produkten till att leverera den till konsumenten, och de måste beskrivas så detaljerat som möjligt.
Du delar upp processen i små bitar och ser vad som tar för lång tid, vad som kan optimeras, förbättras, osv. Till exempel, hur lång tid tar en förfrågan från produkten, genom grooming, hur länge det tar innan den når en biljett som utvecklaren kan ta, QA osv. Så detaljerat ser du på varje steg och tänker på vad som kan optimeras.
När jag gjorde detta, blev två saker tydliga:
- en hög procentandel av biljetter som returnerades från QA tillbaka till utvecklarna;
- pull request-granskningar tog för lång tid.
Problemet var att detta var slutsatser som: det verkar ta mycket tid, men vi är inte säkra på hur mycket.
»Man kan inte förbättra det man inte kan mäta.«
Hur rättfärdigar man hur allvarligt problemet är? Förloras dagar eller timmar på grund av det?
För att mäta detta lade vi till några steg i Jira-processen: «redo för utvecklare» och «redo för QA», för att mäta hur lång tid varje biljett väntar och hur många gånger den returneras till ett visst steg.
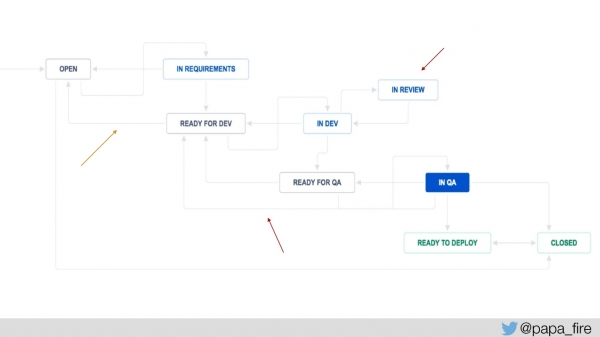
Vi lade också till «under granskning», för att veta hur länge biljetterna i genomsnitt befinner sig under granskning, och utifrån det bygga vidare. Vi hade systemmetrik, nu har vi lagt till nya metrik och började mäta:
- Effektiviteten i processen: produktivitet och planerat/lämnat.
- Kvaliteten på processen: antal defekter, defekter från QA.
Detta hjälper verkligen att förstå vad som fungerar bra och vad som fungerar dåligt.
Dag femtiotvå
Det är förstås allt bra och intressant, men mot slutet av den andra månaden inträffade något som i princip var förutsägbart, även om jag inte hade förväntat mig en så stor omfattning. Människor började lämna, eftersom ledningen förändrades. Nya personer kom in i ledningen som började förändra allt, och de gamla sades upp. Och vanligtvis i ett företag som har funnits i flera år känner alla varandra.
Det var förväntat, men omfattningen av uppsättningarna var oväntad. Till exempel, under en vecka lämnade två teamledare samtidigt in sin uppsägning av eget val. Därför var jag tvungen att inte bara glömma andra problem, utan fokusera på att skapa ett team. Det är ett långsiktigt och svårt problem att lösa, men det var något vi var tvungna att ta itu med, eftersom vi ville behålla de som var kvar (eller åtminstone de flesta av dem). Vi behövde på något sätt reagera på att folk hade gått för att upprätthålla moralen i teamet.
I teorin är det bra: en ny person kommer in, som har en helt fri hand, kan utvärdera teamets färdigheter och byta ut personal. I verkligheten kan man inte bara få in nya människor av många olika skäl. Det behövs alltid balans.
- Mellan gammalt och nytt. Vi behöver behålla de gamla som kan förändras och stödja missionen. Men samtidigt måste vi föra in nya idéer, vilket vi kommer att diskutera lite senare.
- Erfarenhet. Jag har pratat mycket med bra juniorer som brann för att arbeta hos oss. Men jag kunde inte anställa dem eftersom det fanns för få seniorkar som skulle stödja juniorerna och vara deras mentorer. Först behövde vi samla ledningen och bara sedan läsa in ungdomarna.
- Piskor och morötter.
Jag har inget bra svar på frågan om vilken balans som är rätt, hur man upprätthåller den, hur många människor man ska behålla och hur mycket man ska pressa. Det är en rent individuell process.
Dag femtioetthundra
Jag började observera teamet för att förstå vem jag har, och kom återigen ihåg:
”De flesta problem är problem med människor.”
Jag upptäckte att teamet, både utvecklarna och Ops, har tre stora problem:
- Tillfredsställelse med det rådande tillståndet.
- Brist på ansvar — för ingen har någonsin kopplat resultat från anställda till påverkan på affärerna.
- Rädsla för förändringar.
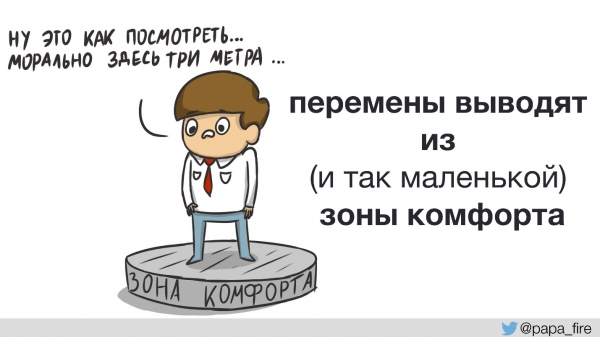
Förändringar tar alltid oss ur vår komfortzon, och ju yngre människor är, desto mer ogillar de förändringar eftersom de inte förstår varför och inte vet hur. Det vanligaste svaret jag har hört är: "Vi har aldrig gjort så här förut." Det gick så långt att även de minsta förändringarna inte gick obemärkt förbi utan att någon blev upprörd. Det spelade ingen roll hur mycket förändringarna berörde deras arbete, folk sa: "Nej, varför? Det kommer inte att fungera."
Men man kan inte bli bättre utan att förändra något.
Jag hade ett helt absurt samtal med en anställd, jag berättade mina idéer om optimering, och han sa till mig:
— Åh, du har inte sett vad vi hade förra året!
— Så vad?
— Just nu är det mycket bättre än det var.
— Så det kan inte bli ännu bättre?
— Varför ska det?
Bra fråga — varför? Som om det är tillräckligt bra om det är bättre än tidigare. Detta leder till avsaknad av ansvar, vilket i grunden är helt normalt. Som jag sa, var teknikgruppen något avsides. Företaget trodde att de borde vara med, men ingen har någonsin satt upp standarder. I supporten hade ingen sett SLA, så för gruppen var det helt "acceptabelt" (och detta överraskade mig mest):
- 12 sekunder laddning;
- 5-10 minuter driftstopp varje release;
- att åtgärda kritiska problem tar dagar och veckor;
- brist på jour 24x7 / on-call.
Ingen har någonsin försökt fråga, varför inte göra detta bättre, och ingen har någonsin förstått att det inte ska vara så.
Som bonus fanns det också ett annat problem: brist på erfarenhet. Seniorerna lämnade, och det kvarstående unga teamet växte under den gamla regimen och blev förgiftat av den.
Till allt detta var folk också rädda för att misslyckas, att verka inkompetenta. Detta uttrycker sig genom att de, för det första, aldrig under några omständigheter bad om hjälp. Hur många gånger har vi pratat i grupp och individuellt, och jag har sagt: "Ställ en fråga om du inte vet hur man gör något." Jag är säker på mig själv och vet att jag kan lösa vilket problem som helst, men det kommer att ta tid. Så om jag kan fråga någon som vet hur man löser det på 10 minuter, så frågar jag. Ju mindre erfarenhet du har, desto mer rädd är du för att fråga eftersom du tänker att de kommer att anse att du är inkompetent.
Denna rädsla för att ställa frågor tar sig intressanta former. Till exempel, man frågar: "Hur går det med denna uppgift?" — "Det är bara några timmar kvar, jag är nästan klar." Nästa dag frågar man igen och får svaret att allt är bra, men det har dykt upp ett litet problem; det kommer definitivt att vara klart innan dagen är över. En ytterligare dag går, och så fort man inte pressar mot väggen och tvingar dem att prata med någon, så fortsätter allt så. Människor vill lösa uppgiften själva; de anser att om de inte lyckas själva, så är det ett stort misslyckande.
Det är därför utvecklarna överdrev sina uppskattningar. Det var verkligen ett skämt när vi diskuterade en specifik uppgift, jag fick en siffra som jag blev mycket förvånad över. Till det fick jag höra att utvecklaren inkluderar även tiden för att biljetten kommer tillbaka från QA, eftersom de kommer att hitta fel där, och tiden som PR kommer att ta, samt tiden medan de som ska granska den är upptagna – det vill säga allt som är möjligt.
För det andra, människor som är rädda för att verka okunniga, analyserar överdrivet. När man säger vad som konkret behöver göras, börjar det: "Nej, men vad händer om vi tänker här?" I detta avseende är vårt företag inte unikt, det är ett standardproblem för yngre generationer.
Till svar införde jag följande metoder:
- Regeln om 30 minuter. Om du inte kan lösa problemet på 30 minuter, be någon annan om hjälp. Detta fungerar med varierande framgång eftersom folk ändå inte ber om hjälp, men åtminstone har processen börjat.
- Exkludera allt utom kärnan, vid uppskattningen av tidsåtgången för uppgiften, det vill säga att endast räkna med tiden det tar att skriva koden.
- Kontinuerligt lärande för dem som analyserar för mycket. Det handlar helt enkelt om att kontinuerligt arbeta med människor.
Den sextionde dagen
Medan jag höll på med allt detta, var det dags att ta itu med budgeten. Självklart hittade jag mycket intressant kring vart vi spenderade pengar. Till exempel hade vi en helt rack i ett separat datacenter, där en FTP-server stod, som användes av en enda kund. Det visade sig att "... vi flyttade, men den blev så kvar; vi bytte aldrig ut den." Det var för två år sedan.
Räkningen för molntjänster väckte särskilt intresse. Jag är säker på att den huvudsakliga orsaken till den stora räkningen för molntjänster är utvecklarna, som för första gången i sina liv har obegränsad tillgång till servrar. De behöver inte be: "Ge mig en testserver, tack" – de kan ta en själva. Dessutom vill utvecklarna alltid bygga ett så häftigt system att Facebook och Netflix skulle bli avundsjuka.
Men utvecklarna har ingen erfarenhet av att köpa servrar och saknar färdighet i att avgöra rätt serverstorlek, eftersom de tidigare inte har behövt det. Och vanligtvis förstår de inte helt skillnaden mellan skalbarhet och prestanda.
Resultatet av inventeringen:
- Vi har lämnat en datacenter.
- Vi har sagt upp kontrakt med 3 loggtjänster. Eftersom vi hade 5 — varje utvecklare som började experimentera tog en ny.
- Vi stängde av 7 AWS-system. Återigen, döda projekt stängdes aldrig av, de fortsatte att fungera.
- Vi minskade mjukvarukostnaderna med 6 gånger.
Dag sjuttiofem
Tiden gick, och efter två och en halv månad skulle jag träffa styrelsen. Vår styrelse är varken bättre eller sämre än andra, de vill veta allt precis som alla andra styrelser. Folk investerar pengar och vill förstå hur det vi gör stämmer överens med de uppsatta KPI:erna.
Styrelsen får mycket information varje månad: antal användare, deras tillväxt, vilka tjänster de använder och hur, samt prestanda och produktivitet, och slutligen den genomsnittliga sidladdningstiden.
Problemet är bara att jag anser att genomsnittet är ett rent ont. Men det är mycket svårt att förklara detta för styrelsen. De är vana vid att arbeta med aggregerade siffror, inte till exempel spridningen av laddningstider i sekunder.
I samband med detta fanns det intressanta ögonblick. Till exempel sa jag att trafiken måste delas mellan separata webbservrar beroende på typ av innehåll.
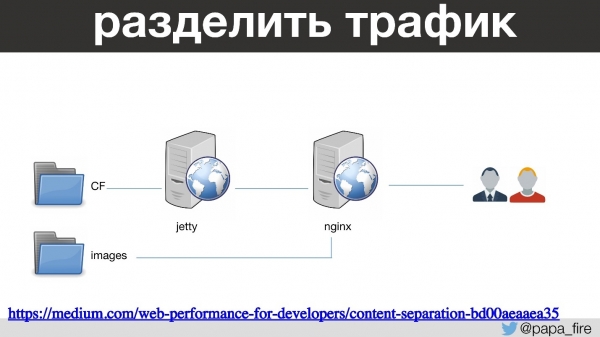
Det vill säga ColdFusion går genom Jetty och nginx och laddar sidor. Bilder, JS och CSS går igenom en separat nginx med sina egna konfigurationer. Det är en ganska standardpraxis, om jag tänker tillbaka på för ett par år sedan. Resultatet är att bilderna laddas mycket snabbare, och … den genomsnittliga laddningstiden har ökat med 200 ms.
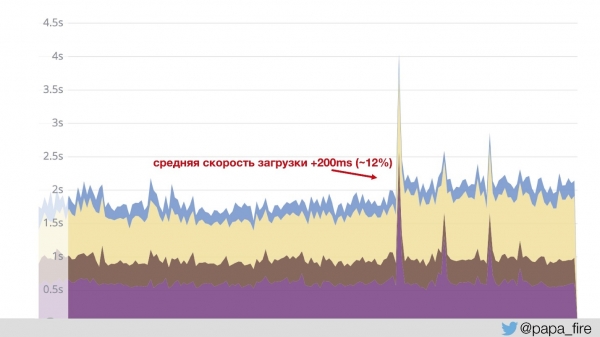
Det här hände eftersom grafiken baseras på data som kommer från Jetty. Det vill säga snabb innehåll räknas inte — medelvärdet har skjutit i höjden. Vi förstod det, vi skrattade, men hur ska vi förklara styrelsen varför vi gjorde något som blev 12% sämre?
Dag åttiofem
I slutet av den tredje månaden insåg jag att det fanns en sak jag verkligen inte hade räknat med — tid. Allt jag talade om tar tid.
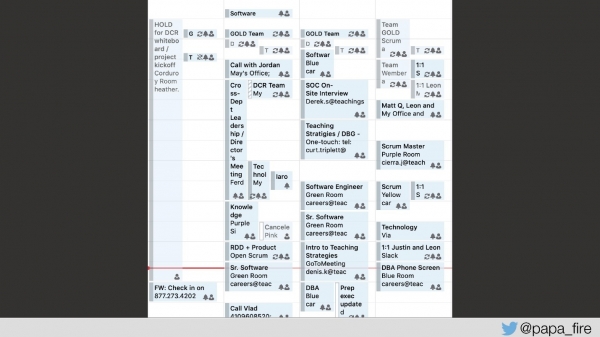
Detta är min verkliga kalender för veckan — bara en arbetsvecka, inte så överbelastad. Det finns inte tillräckligt med tid för allt. Därför behöver vi återigen rekrytera folk som kan hjälpa till med problemen.
Slutsats
Detta är långt ifrån allt. I den här berättelsen har jag inte ens kommit till hur vi arbetade med produkten och försökte anpassa oss till den gemensamma vågen, eller hur vi integrerade supporten, eller hur vi löste andra tekniska problem. Till exempel råkade jag helt av en slump få veta att vi inte använde SEQUENCE. Vi har en egen skriven funktion nextID, och den används inte i en transaktion.
Det fanns en miljon liknande saker som man lätt kan prata länge om. Men det viktigaste som fortfarande bör nämnas är kulturen.
Det är just kulturen eller bristen på den som leder till alla andra problem. Vi försöker bygga en kultur där folk:
- inte är rädda för misslyckanden;
- lär sig av misstagen;
- samarbetar med andra team;
- visar initiativ;
- tar ansvar;
- välkomnar resultat som ett mål;
- fira framgången.
Med detta kommer allt annat.
Leon Fire , och på .
När det gäller arvet finns det två strategier: att undvika att arbeta med det till varje pris, eller att modigt övervinna de medföljande svårigheterna. Vi går den andra vägen, ändrar processer och tillvägagångssätt. Följ med oss på , och , och låt oss tillsammans implementera en DevOps-kultur.
Källa: habr.com
