

I denna artikel presenterar jag mina tankar om internetets historia och framtidsutsikter, centraliserade och decentraliserade nätverk och som ett resultat — den möjliga arkitekturen för nästa generations decentraliserade nätverk.
Det är något fel med internet.
Första gången jag kom i kontakt med internet var 2000. Självklart var detta långt ifrån början — nätet hade redan funnits innan dess, men denna tid kan kallas för det första uppsvinget av internet. World Wide Web — ett genialiskt påhitt av Tim Berners-Lee, web1.0 i sin klassiska kanoniska form. Många webbplatser och sidor, som länkar till varandra med hyperlänkar. Vid första anblicken — en enkel, som allt genialt, arkitektur: decentraliserad och fri. Jag vill — jag reser mellan andra människors webbplatser genom att följa hyperlänkar; jag vill — jag skapar min egen webbplats, där jag publicerar det som intresserar mig — till exempel mina artiklar, fotografier, program, hyperlänkar till webbplatser som jag finner intressanta. Och andra länkar till mig.
Det verkar som en idyllisk bild, eller hur? Men ni vet redan hur allt detta slutade.
Antalet sidor blev för stort, och att hitta information blev en ganska komplicerad sak. De hyperlänkar som skrevs av författarna kunde helt enkelt inte strukturera denna enorma mängd information. Först kom kataloger som fylldes manuellt, och därefter de gigantiska sökmotorerna som började använda listiga heuristiska rangordningsalgoritmer. Webbplatser skapades och lämnades, information duplicerades och förvreds. Internet kommersialiserades snabbt och kom allt längre bort från det perfekta akademiska nätverket. Märkningsspråket förvandlades snabbt till ett formateringsspråk. Reklam dök upp, vidriga irriterande banners och teknologier för manipulation och bedrägerier om sökmotorer — SEO. Nätet blev snabbt förorenat med informationsskräp. Hyperlänkar slutade vara ett verktyg för logisk koppling och blev ett verktyg för marknadsföring. Webbplatser blev slutna, stängde sig inåt, förvandlades från öppna "sidor" till hermetiska "applikationer" och blev endast medel för att generera inkomst.
Redan då hade jag en viss tanke att "något här är fel". En massa olika webbplatser, från primitiva hemsidor med skrikig design till "megaportaler" överfulla med blinkande bannerannonser. Även om webbplatserna handlar om samma ämne — de är helt orelaterade, varje med sin egen design, sin egen struktur, irriterande annonser, dåligt fungerande sökfunktioner, problem med nedladdningar (ja, jag ville ha information offline). Redan då började internet likna någon form av television, där användbart innehåll var ihopklistrat med all möjlig skräp.
Decentralisering har blivit en mardröm.
Vad vill man då?
Paradoxalt nog, redan då, utan att veta något om web 2.0 eller p2p, behövde jag som användare ingen decentralisering! När jag minns mina oinfekterade tankar från den tiden, kommer jag fram till att jag behövde… en enhetlig databas! En sådan som skulle ge alla resultat på en förfrågan, snarare än de som är mest lämpade för rangordningsalgoritmen. En sådan där alla dessa resultat skulle vara uniformt formaterade och stylade med min egen enhetliga design, istället för skrikiga, hemmagjorda designer från mängder av Vasja Pupkin. En sådan som jag skulle kunna spara offline utan att oroa mig för att webbplatsen plötsligt skulle försvinna och informationen gå förlorad för alltid. En sådan som jag skulle kunna mata in min egen information i — till exempel kommentarer och taggar. En som jag skulle kunna söka i, sortera och filtrera med mina personliga algoritmer.
Web 2.0 och sociala medier
Under tiden introducerades konceptet Web 2.0. Formulerat 2005 av Tim O'Reilly som "metoden för att designa system, som genom att beakta nätverksinteraktioner blir bättre ju fler människor som använder dem" — och som innebär aktivt engagemang från användarna i kollektiv skapelse och redigering av nätinnehåll. Utan överdrift var höjdpunkten och triumfen för detta koncept sociala medier. Gigantiska plattformar som förenar miljarder användare och lagrar hundratals petabyte data.
Vad har vi fått i sociala medier?
- enhetlig gränssnitt; det visade sig att alla möjligheter för att skapa en mängd bländande design inte var något som användarna behövde; alla sidor för alla användare har samma design, vilket alla tycker är bra och till och med bekvämt; endast innehållet skiljer sig åt.
- enhetlig funktionalitet; all mångfald av skript visade sig också vara onödig. "Flöde", vänner, album… under sociala mediers tid har deras funktionalitet mer eller mindre stabiliserats och kommer knappast att förändras: eftersom funktionaliteten bestäms av människors aktivitetsformer, och människor förändras praktiskt taget inte.
- enhetlig databas; det visade sig vara mycket mer bekvämt att arbeta med en sådan databas än med många spridda webbplatser; sökningen blev mycket enklare. Istället för att ständigt skanna igenom olika svagt relaterade sidor, cacha allt detta, rangordna enligt komplexa heuristiska algoritmer – en relativt enkel enhetlig fråga till en enda databas med en känd struktur.
- feedbackgränssnitt – gilla och dela; i den vanliga webben kunde Google på inget sätt få feedback från användare efter att de klickat på en länk i sökresultaten. I sociala medier visade sig denna koppling vara enkel och naturlig.
Vad har vi förlorat? Vi har förlorat decentralisering, och därmed – frihet.. Det anses nu att våra data inte tillhör oss längre. Tidigare kunde vi placera vår hemsida på vår egen dator, men nu överlämnar vi alla våra data till internetjättarna.
Dessutom, i takt med att internet har utvecklats, har regeringar och företag blivit intresserade av det, vilket har lett till problem med politisk censur och upphovsrättsliga begränsningar. Våra sidor på sociala medier kan stängas av och tas bort om innehållet inte uppfyller vissa regler; för ett oförsiktigt inlägg kan man dras till administrativ och till och med straffrättslig ansvarighet.
Och nu undrar vi igen: borde vi inte återfå decentralisering? Men i en annan form, fri från bristerna i det första försöket?
Peer-to-peer-nätverk
De första p2p-näten dök upp långt innan web 2.0 och utvecklades parallellt med webbens tillväxt. Den huvudsakliga klassiska användningen av p2p är fildelning; de första nätverken utvecklades för att dela musik. De första nätverken (som Napster) var i grunden centraliserade och stängdes därför snabbt ned av upphovsrättsinnehavare. Efterträdare gick mot decentralisering. År 2000 lanserades protokollen ED2K (den första klienten eDokney) och Gnutella, följt av protokollet FastTrack (klienten KaZaA) år 2001. Gradvis ökade graden av decentralisering och teknologierna förbättrades. Istället för system med
Men p2p-nät har massor av nackdelar. Förutom tekniska brister som gäller varje specifik implementation av protokollet och klienten, kan man till exempel nämna en ganska vanlig nackdel — svårigheterna med sökning (det vill säga allt det som Web 1.0 stötte på, men i en ännu mer komplicerad variant). Här finns ingen Google med sin allestädes närvarande och omedelbara sökning. Och även om man för fildelningsnät skulle kunna använda sökningar baserat på filnamn eller metadata, är det ganska svårt, om inte omöjligt, att hitta något på exempelvis overlay-näten onion eller i2p.
Överlag, om man gör analogier med det klassiska internet, så har de flesta decentraliserade nätverken fastnat på en nivå som liknar FTP. Föreställ dig ett internet där det inte finns något annat än FTP: inga moderna webbplatser, inget web2.0, inget Youtube… Det är ungefär det tillstånd decentraliserade nätverk befinner sig i. Och trots vissa försök att förändra något, har förändringarna hittills varit få.
Innehåll
Låt oss titta på en annan viktig del av detta pussel - innehållet. Innehållet är det största problemet för varje webbplats, och särskilt för decentraliserade system. Var ska man få tag på det? Självklart kan man förlita sig på en grupp entusiaster (som det är med befintliga p2p-nätverk), men då kommer nätverkets utveckling att ta tid, och det kommer att finnas lite innehåll där.
Att arbeta med vanlig internet är att söka och studera innehåll. Ibland - spara (om innehållet är intressant och användbart, så sparar många, särskilt de som kommit in på nätet under dial-up-eran - inklusive mig - förnuftigt det offline, för att inte tappa bort det; eftersom internet är något vi inte har kontroll över, idag finns en webbplats, imorgon finns den inte, idag finns en video på YouTube - imorgon kan den ha blivit borttagen, osv.
Och för torrents (som vi uppfattar mer som ett leveransverktyg än som ett p2p-nätverk) föreslås faktiskt sparande. Och det är förresten ett av problemen med torrents: en nedladdad fil är svår att flytta till en plats där den är bekvämare att använda (vanligtvis måste man manuellt regenerera delningen) och man kan absolut inte döpa om den (man kan göra en hardlink, men det är något väldigt få känner till).
Sammanfattningsvis sparar många innehåll på något sätt. Vad händer med det efteråt? Vanligtvis hamnar de sparade filerna någonstans på disken, i en mapp som Downloads, i en osorterad hög, och ligger där tillsammans med många tusen andra filer. Detta är dåligt - och det är dåligt för användaren själv. Om internet har sökmotorer, så har användarens lokala dator inget liknande. Det är bra om användaren är ordentlig och van vid att sortera 'inkomna' nedladdade filer. Men långt ifrån alla är så...
I själva verket finns det en hel del som inte sparar någonting utan förlitar sig helt på online. Men i p2p-nätverk antas innehållet sparas lokalt på användarens enhet och delas med andra deltagare. Finns det en lösning som kan engagera båda användarkategorierna i ett decentraliserat nätverk, utan att ändra deras vanor, och dessutom - göra deras liv enklare?
Idén är ganska enkel: vad om vi skapar ett verktyg för bekväm och transparent lagring av innehåll från det vanliga internetet, där lagringen är smart - med semantisk metadata, och inte i en enda hög, utan i en specifik struktur med möjlighet för vidare strukturerande, och samtidigt dela det lagrade innehållet i ett decentraliserat nätverk?
Låt oss börja med lagring
Vi kommer inte att betrakta det praktiska användandet av internet för att se väderprognoser eller flygscheman. Vi är mer intresserade av självbärande och mer eller mindre oföränderliga objekt - artiklar (från tweets/poster i sociala medier till större artiklar, så som här på Habré), böcker, bilder, program, ljud- och videoinspelningar. Varifrån kommer informationen? Vanligtvis är det
- sociala medier (olika nyheter, korta notiser - "tweets", bilder, ljud och video)
- artiklar på tematiska resurser (som Habré); det finns inte så många bra resurser, vanligtvis bygger dessa resurser också på principen av sociala nätverk
- nyhetssajter
Som regel finns det standardfunktioner: "gilla", "dela", "dela på sociala medier" osv.
Låt oss föreställa oss en webbläsartillägg, som på ett speciellt sätt sparar allt vi har gillat, delat, sparat i "favoriter" (eller tryckt på en speciell knapp i tillägget, utplacerad i webbläsarens meny - i fall webbplatsen inte har funktionen att gilla/dela/lägga till bokmärken). Huvididén är att du bara gillar - precis som du har gjort en miljon gånger tidigare, och systemet sparar artikeln, bilden eller videoklippet i en speciell offline-lagring och denna artikel eller bild blir tillgänglig - både för offlinevisning genom gränssnittet av den decentraliserade klienten, och i själva det decentraliserade nätverket! För mig verkar det väldigt bekvämt. Inga extra åtgärder, och vi löser omedelbart flera uppgifter:
- lagring av värdefullt innehåll som kan gå förlorat eller bli raderat
- snabb fyllning av det decentraliserade nätverket
- aggregering av innehåll från olika källor (du kan vara registrerad på tiotals internetresurser, och alla gilla/dela kommer att samlas i en enda lokal databas)
- strukturerande av intressant innehåll för dina reglerna
Det är uppenbart att webbläsartillägget måste anpassas till strukturen för varje webbplats (detta är helt genomförbart — det finns redan tillägg för att spara innehåll från Youtube, Twitter, VK, etc.). Det finns inte så många webbplatser för vilka det faktiskt är meningsfullt att skapa personliga tillägg. Som regel handlar det om vanliga sociala nätverk (det finns inte mycket mer än ett dussin) och ett antal högkvalitativa nischsajter som Habr (som också är ganska få). Med öppen kod och specifikation bör utvecklingen av ett nytt tillägg baserat på en mall inte ta mycket tid. För andra webbplatser kan en universell spara-knapp användas, som skulle spara hela sidan i mhtml — eventuellt efter att ha rensat sidan från annonser.
Nu om strukturerandet
Med "smart" sparande menar jag åtminstone sparande med metadata: innehållskälla (URL), uppsättning tidigare givna gilla-markeringar, taggar, kommentarer, deras identifierare, etc. För vid vanlig sparande går denna information förlorad... Med källa kan man förstås inte bara den direkta URL:en, utan även den semantiska komponenten: till exempel en grupp i ett socialt nätverk eller en användare som har delat. Tillägget kan vara tillräckligt smart för att använda denna information för automatisk strukturering och taggning. Dessutom bör man förstå att användaren alltid kan lägga till viss metadata till det sparade innehållet, därför bör de mest användarvänliga gränssnitten för detta förutses (jag har många idéer om hur man gör det).
På så sätt löses frågan om strukturell och organisatorisk hantering av användarens lokala filer. Detta är redan en färdig nyttighet som kan användas även utan någon p2p. Bara någon slags offline-databas, som vet vad, varifrån och i vilket sammanhang vi har sparat, och som tillåter att genomföra små forskningar. Till exempel, hitta användare från externa sociala nätverk som har gillat de samma inläggen som du. Låter många sociala nätverk detta uttryckligen?
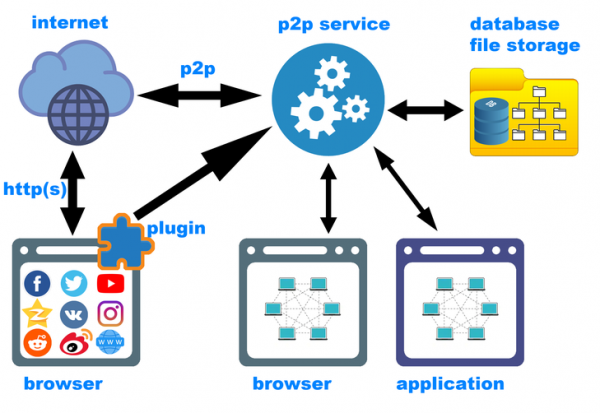
Här bör vi nämna att en enda webbläsartillägg givetvis inte är tillräckligt. Den andra viktiga komponenten i systemet är en decentraliserad nätverkstjänst som körs i bakgrunden och hanterar både själva p2p-nätverket (förfrågningar från nätverket och förfrågningar från klienten) samt sparar nytt innehåll med hjälp av tillägget. Tjänsten, i samarbete med tillägget, kommer att placera innehållet på rätt plats, beräkna hashvärden (och kanske avgöra om detta innehåll redan har sparats tidigare), och lägga till nödvändig metadata i den lokala databasen.
Vad som är intressant är att systemet skulle vara användbart redan i detta tillstånd, utan någon p2p. Många använder webbklippare som lägger till intressant innehåll från webben, till exempel i Evernote. Den föreslagna arkitekturen är en utvidgad version av en sådan klippare.
Och slutligen, p2p-utbyte
Det mest trevliga är att information och metadata (både sådan som fångats från webben och min egen) kan utbytas. Konceptet med sociala nätverk överförs utmärkt till p2p-arkitekturen. Man kan säga att sociala nätverk och p2p är skapade för varandra. Varje decentraliserat nätverk bör i idealfallet byggas som ett socialt nätverk; bara då fungerar det effektivt. "Vänner", "Grupper" – det är samma noder, som måste ha stabila kopplingar, och dessa kopplingar kommer från en naturlig källa – gemensamma intressen bland användarna.
Principerna för att spara och dela innehåll i ett decentraliserat nätverk är helt identiska med principerna för att spara (fånga) innehåll från det vanliga internet. Om du använder något innehåll från nätverket (och alltså har sparat det), så kan vem som helst använda dina resurser (disken och bandbredden) som behövs för att få just det innehållet.
Gilla är det enklaste verktyget för att spara och dela. Om jag har gillat något – oavsett om det är på det externa internet eller inom det decentraliserade nätverket – betyder det att jag gillar innehållet, och eftersom det är så är jag redo att ha det lokalt och dela det med andra deltagare i det decentraliserade nätverket.
- Innehållet kommer inte att "förloras"; det är nu sparat lokalt hos mig, och jag kan återvända till det senare, när som helst, utan att behöva oroa mig för att någon tar bort det eller blockera det.
- Jag kan (omedelbart eller senare) kategorisera, tagga, kommentera, associera med annat innehåll, i allmänhet göra något meningsfullt med det – vi kan kalla det "skapande av metainformation".
- Jag kan dela denna metainformation med andra nätverksdeltagare.
- Jag kan synkronisera min metainformation med metainformationen från andra deltagare.
Att avstå från missnöjesmarkeringar verkar också logiskt: om jag inte gillar innehållet, är det helt rimligt att jag inte vill använda mitt diskutrymme för att lagra det eller mitt internet för att dela det. Därför passar missnöjesmarkeringar inte in i decentralisering (även om det ibland kan vara nyttigt). ).
Ibland behöver man spara även sådant man "inte gillar". Det finns ett ord för det – "måste" :)
«Bokmärken(eller "Favoriter") – jag uttrycker inte min åsikt om innehållet, men sparar det i min lokala bokmärkeskatalog. Ordet "favoriter" (favorites) passar inte riktigt i betydelse (det finns likes och efterföljande kategorisering), medan "bokmärken" (bookmarks) fungerar bra. Innehåll i "bokmärken" delas också – om det är "nödvändigt" för dig (dvs du använder det på något sätt), är det logiskt att det kan vara "nödvändigt" för någon annan också. Varför inte använda dina resurser för detta?
Funktionen "vänner" är ganska uppenbar. Det handlar om personer med liknande intressen, vilket innebär att de förmodligen också har intressant innehåll. I ett decentraliserat nätverk innebär detta främst att prenumerera på nyhetsflöden från vänner och få tillgång till deras kataloger (album) med innehåll de sparat.
På liknande sätt är funktionen "arbetsgrupp" kollektivt flöde, eller forum, eller något liknande som man också kan prenumerera på – och därmed ta emot allt material från gruppen och dela det. Kanske borde "grupper", liknande stora forum, vara hierarkiska – det skulle göra det möjligt att strukturera gruppinnehåll bättre och också begränsa informationsflödet så att man inte tar emot/dela sådant som inte är särskilt intressant för en.
Allt annat
Det är värt att notera att en decentraliserad arkitektur alltid är mer komplex än en centraliserad. I centraliserade resurser finns det en strikt diktat från serverkoden. I decentraliserade resurser krävs det att man kommer överens med många jämlika deltagare. Självklart kan man inte komma undan med kryptografi, blockkedjor och andra prestationer som framför allt har utvecklats inom kryptovalutor.
Jag antar att det kan behövas några kryptografiska ömsesidiga förtroendebetyg som skapas av deltagarna i nätverket för varandra. Arkitekturen måste möjliggöra effektiv bekämpning av botnät som kan exempelvis omrösta sig själva inom något moln. Man vill verkligen att företag och botnätsfabriker, med allt deras teknologiska överläge, inte ska ta över styret av ett sådant decentraliserat nätverk; att dess huvudresurs ska vara levande människor som kan producera och strukturera innehåll som är intressant och nyttigt för andra levande människor.
Man hoppas också att ett sådant nätverk ska driva civilisationen mot framsteg. I detta avseende har jag en hel del idéer som dock inte ryms inom ramen för denna artikel. Jag kan bara säga att på ett visst sätt bör vetenskapligt, tekniskt, medicinskt och liknande innehåll ha fördel framför underhållningsinnehåll, och detta kommer att kräva en form av moderering. Modereringen av ett decentraliserat nätverk i sig är en icke-trivial uppgift, men lösbar (dock är ordet "moderering" här helt felaktigt och reflekterar överhuvudtaget inte processens kärna — varken externt eller internt... och jag har inte ens kommit på hur man skulle kunna kalla denna process).
Antagligen är det överflödigt att nämna behovet av att garantera anonymitet — både genom inbyggda medel (som i i2p eller Retroshare) och genom att låta all trafik passera genom TOR eller VPN.
Och slutligen den programvaruarkitektur som schematiskt ritas i artikeln. Som redan nämnts är det första systemkomponenten en webbläsartillägg som fångar innehåll med metadata. Den andra mest avgörande komponenten är en p2p-tjänst som arbetar i bakgrunden. Nätverkets funktionalitet bör uppenbarligen inte bero på om webbläsaren är öppen eller inte. Den tredje komponenten är klientmjukvaran — frontend. Detta kan vara en lokal webbservice (i så fall kan användaren arbeta med det decentraliserade nätverket utan att lämna sin favoritwebbläsare) eller en separat GUI-applikation för ett specifikt operativsystem (Windows, Linux, MacOS, Android, iOS, etc.). Jag gillar idén om att alla frontend-alternativ kan samexistera. Dessutom tvingar det till en strängare arkitektur av backend.
Det finns också många aspekter som inte ingick i denna artikel. Anslutning till delning av befintliga fillagringslösningar (d.v.s. när du redan har flera terabyte nedladdat och ger klienten tillgång att skanna detta, få hashar, jämföra dem med det som finns i nätverket och ansluta sig till delningen, och dessutom hämta metadata om sina egna filer från nätet — normala namn, beskrivningar, betyg, recensioner etc.), anslutning av externa metadatakällor (såsom Libgens databaser), valfritt utnyttjande av lagringsutrymme för att lagra andras krypterade innehåll (som i Freenet), arkitektur för integration med befintliga decentraliserade nätverk (här är det verkligen oklart), idén om mediehashing (användning av speciella perceptuella hash för medieinnehåll — bilder, ljud och video, vilket gör det möjligt att jämföra liknande mediafiler som skiljer sig åt i storlek, upplösning etc.) och mycket mer.
Sammanfattning av artikeln
1. I decentraliserade nätverk finns det ingen Google med sin sökning och ranking — men det finns en gemenskap av verkliga människor. Det sociala nätverket med sina återkopplingsmekanismer (gilla, dela ...) och sociala grafer (vänner, grupper ...) är den perfekta modellen för applikationsnivån för ett decentraliserat nätverk.
2. Huvudidén jag för fram i denna artikel är automatisk lagring av intressant innehåll från det vanliga internetet vid installation av gillande/återpostningar; detta kan vara nyttigt även utan p2p, bara för att hålla en personlig arkiv med intressant information.
3. Detta innehåll kan också automatiskt fylla en decentraliserad nätverk.
4. Principen för automatisk lagring av intressant innehåll fungerar även vid gillande/återpostningar inom det mest decentraliserade nätverket.
Källa: habr.com
