

är ett kolumnbaserat databashanteringssystem för onlineanalysfrågor (OLAP) med öppen källkod, utvecklat av Yandex. Det används av Yandex, CloudFlare, VK.com, Badoo och andra tjänster världen över för att lagra verkligt stora datamängder (insättningar av tusentals rader per sekund eller petabyte av data lagrade på disk).
I en vanlig, "radbaserad" databashanterare, exempelvis MySQL, Postgres, MS SQL Server, lagras data i följande ordning:
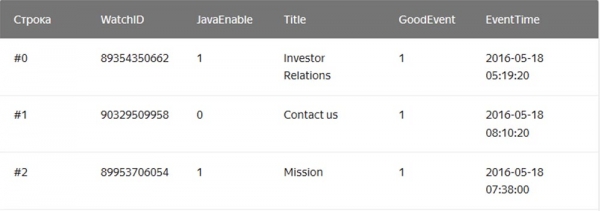
Här lagras värden som tillhör en rad fysiskt nära varandra. I kolumnbaserade databashanterare lagras värden från olika kolumner separat, och data från en kolumn lagras tillsammans:
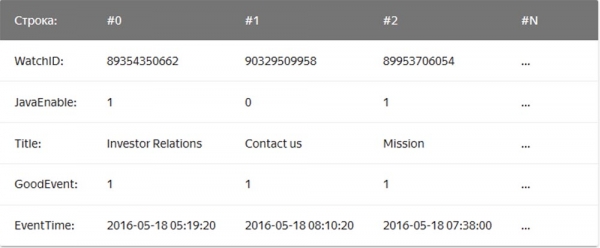
Exempel på kolumnbaserade databashanterare inkluderar Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Företag – e-post vidarebefordrare började använda Clickhouse 2018 för att skapa rapporter och blev mycket imponerad av dess enkelhet, skalbarhet, SQL-stöd och hastighet. Denna databashanterares hastighet gränsade till magi.
Enkelhet
Clickhouse installeras på Ubuntu med en enda kommando. Om du känner till SQL kan du omedelbart börja använda Clickhouse för dina behov. Men det betyder inte att du kan utföra "show create table" i MySQL och kopiera och klistra in SQL i Clickhouse.
Jämfört med MySQL finns det viktiga skillnader i datatyper i tabellschema ddefinitionerna i denna databashanterare, så för bekväm användning kommer du att behöva lite tid att ändra definitionerna av tabellscheman och studera tabellmotorer.
Clickhouse fungerar utmärkt utan någon ytterligare programvara, men om du vill använda replikering måste du installera ZooKeeper. Prestandaanalysen av frågor visar utmärkta resultat - systemtabeller innehåller all information och all data kan hämtas med hjälp av gammaldags och tråkig SQL.
Performance
- jämförelser av Clickhouse med Vertica och MySQL på en serverkonfiguration: två socklar Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 på 8 6TB SATA HDD, ext4.
- jämförelser av Clickhouse med Amazon RedShift molndatalager.
- Utdrag från Cloudflare-bloggen om Clickhouses prestanda :
ClickHouse-databasen har en mycket enkel design — alla noder i klustret har samma funktionalitet och använder endast ZooKeeper för samordning. Vi byggde ett litet kluster med flera noder och genomförde tester, där vi upptäckte att systemet har en ganska imponerande prestanda som motsvarar de påstådda fördelarna i benchmark-tester av analytiska databaser. Vi beslutade oss för att titta närmare på konceptet bakom ClickHouse. Det första hindret för våra studier var avsaknaden av verktyg och det begränsade ClickHouse-communityt, så vi grävde djupare in i designen av denna databashanterare för att förstå hur den fungerar.
ClickHouse stödjer inte direkt mottagning av data från Kafka, eftersom det bara är en databas, så vi skrev vår egen adaptertjänst i Go. Den läste de kodade Cap’n Proto-meddelanden från Kafka, konverterade dem till TSV och infogade dem i ClickHouse i block via HTTP-gränssnittet. Senare omskrev vi den här tjänsten för att använda Go-biblioteket tillsammans med vårt eget ClickHouse-gränssnitt för att förbättra prestandan. När vi utvärderade prestandan för paketmottagning upptäckte vi en viktig sak – det visade sig att ClickHouse-prestandan är starkt beroende av pakets storlek, det vill säga antalet samtidigt infogade rader. För att förstå varför detta händer, studerade vi hur ClickHouse lagrar data.
Den primära motorn, eller snarare, familjen av motorer för tabeller som används av ClickHouse för att lagra data är MergeTree. Denna motor är konceptuellt lik LSM-algoritmen som används i Google BigTable eller Apache Cassandra, men undviker att bygga en mellanliggande minnestabell och skriver data direkt till disken. Detta ger den utmärkt skrivbandbredd, eftersom varje infogat paket sorteras endast efter "primärnyckeln" primary key, komprimeras och skrivs till disken för att bilda ett segment.
Avsaknaden av minnestabeller eller något begrepp om "färskhet" av data innebär också att de endast kan läggas till, medan systemet inte stöder ändring eller borttagning. Idag är det enda sättet att ta bort data att ta bort dem månadsvis, eftersom segment aldrig korsar månadens gräns. ClickHouse-teamet arbetar aktivt med att göra denna funktion konfigurerbar. Å andra sidan gör detta skrivning och sammanslagning av segment konfliktfritt, vilket gör att bandbredden för insamling skalar linjärt med antalet parallella insättningar, så länge det inte sker mättnad av I/O eller kärnor.
Men denna omständighet innebär också att systemet inte är lämpat för små paket, så Kafka-tjänster och insättare används för buffring. Dessutom fortsätter ClickHouse konstant att utföra sammanslagning av segment i bakgrunden, så att många små delar av information kommer att slås samman och skrivas flera gånger, vilket ökar intensiteten i skrivningen. Samtidigt kan för många osammanhängande delar leda till aggressiv dämpning av insättningar så länge sammanslagningen pågår. Vi har upptäckt att den bästa kompromissen mellan realtidsdata och prestanda för mottagning är att ta emot ett begränsat antal insättningar per sekund i tabellen.
Nyckeln till läsprestanda för tabeller är indexering och datas placering på disken. Oavsett hur snabbt bearbetningen är, när motorn behöver skanna terabyte av data på disken och använda endast en del av dem, kommer det att ta tid. ClickHouse är ett kolumnar datalager, så varje segment innehåller en fil för varje kolumn med sorterade värden för varje rad. Därför kan hela kolumner som inte ingår i frågan först hoppas över och sedan kan flera celler bearbetas parallellt med vektoriserad exekvering. För att undvika fullständig skanning har varje segment en liten indexfil.
Med tanke på att alla kolumner är sorterade efter "primärnyckeln", innehåller indexfilen endast etiketter (fångade rader) av varje N:e rad för att kunna lagra dem i minnet även för mycket stora tabeller. Till exempel kan standardinställningen "markera var 8192:e rad" ställas in, då kommer "fattig" indexering av en tabell med 1 biljon rader, som enkelt får plats i minnet, att ta endast 122 070 tecken.
Utveckling av systemet
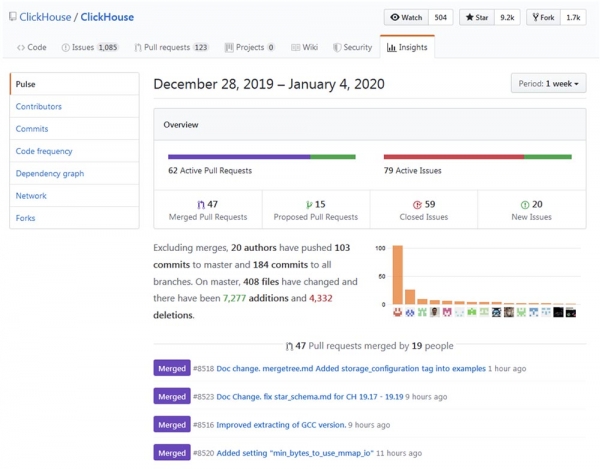
Utvecklingen och förbättringen av Clickhouse kan spåras på och man kan se att "tillväxtprocessen" sker i imponerande takt.
Popularitet
Det verkar som om populariteten för Clickhouse växer exponentiellt, särskilt inom den rysktalande gemenskapen. Förra årets konferens High Load 2018 (Moskva, 8-9 november 2018) visade att monster som vk.com och Badoo använder Clickhouse, med hjälp av vilken de matar in data (till exempel loggar) från tiotusentals servrar samtidigt. I en 40-minuters video . Snart kommer vi att publicera transkriptionen på Habr för att underlätta arbetet med materialet.
Användningsområden
Efter att ha lagt ner lite tid på undersökningar tror jag att det finns områden där ClickHouse kan vara användbart eller kan helt ersätta andra, mer traditionella och populära lösningar som MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot och Druid. Nedan följer detaljer om användning av ClickHouse för att modernisera eller helt ersätta ovanstående databashanterare.
Utökning av MySQL och PostgreSQL
För inte så länge sedan delvis ersatte vi MySQL med ClickHouse för plattformen för nyhetsbrev Problemet var att MySQL på grund av en dåligt genomtänkt design registrerade varje skickat mejl och varje länk i detta mejl med en base64-hash, vilket skapade en enorm MySQL-tabell (email_stats). Efter att ha skickat ut 10 miljoner mejl till abonnenterna upptog denna tabell 150 GB diskutrymme, och MySQL började "sakta ner" vid enkla förfrågningar. För att åtgärda problemet med diskutrymmet använde vi framgångsrikt InnoDB-tabellkomprimering, vilket minskade storleken med fyra gånger. Men det är fortfarande meningslöst att lagra mer än 20-30 miljoner e-postmeddelanden i MySQL endast för att läsa historik, eftersom varje enkel förfrågan som av någon anledning måste göra en fullständig genomsökning leder till swap och en stor belastning på I/O, vilket vi regelbundet fick varningar om från Zabbix.
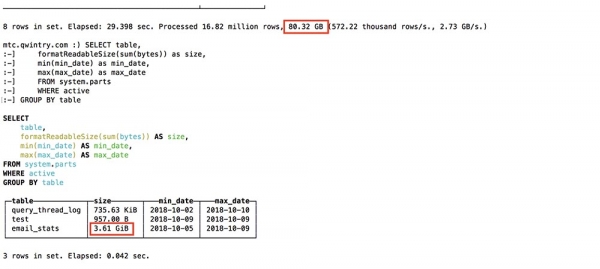
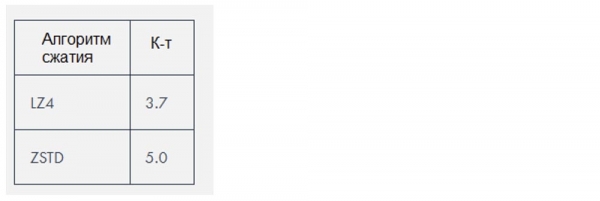
Clickhouse använder två komprimeringsalgoritmer som minskar datamängden med ungefär , men i detta specifika fall var datan särskilt "komprimerbar".
Ersättning av ELK
Enligt egen erfarenhet kräver ELK-stacken (ElasticSearch, Logstash och Kibana, i detta specifika fall ElasticSearch) mycket mer resurser för att köra än vad som verkligen behövs för att lagra loggar. ElasticSearch är en utmärkt motor om du behöver bra fulltextsökning i loggar (och jag tror inte att du verkligen behöver det), men jag undrar varför det de facto har blivit standardmotorn för loggning. Dess abonnemangsbandbredd tillsammans med Logstash skapade problem för oss även vid ganska små belastningar och krävde att vi la till allt mer RAM och diskutrymme. Som databas är Clickhouse bättre än ElasticSearch av följande skäl:
- Stöd för SQL-dialekt;
- Bättre komprimeringsgrad för lagrad data;
- Stöd för regex-sökning istället för fulltextsökning;
- Förbättrad förfrågningsplanering och högre total prestanda.
För närvarande är det största problemet som uppstår vid jämförelse av ClickHouse med ELK bristen på lösningar för loggutdelning, samt bristen på dokumentation och utbildningsmaterial om ämnet. Samtidigt kan varje användare ställa in ELK med hjälp av Digital Oceans guide, vilket är mycket viktigt för snabb implementering av sådana teknologier. Här finns en databasmotor, men än så länge finns det ingen Filebeat för ClickHouse. Ja, det finns och systemet för att arbeta med loggar , finns det ett verktyg för att föra in loggfilers data i ClickHouse, men allt detta tar mer tid. Men ClickHouse är trots allt ledande på grund av sin enkelhet, så även nybörjare kan enkelt installera det och börja använda det fullt ut bokstavligen inom 10 minuter.
Genom att föredra minimalistiska lösningar försökte jag använda FluentBit, ett verktyg för att exportera loggar med mycket låg minnesanvändning, tillsammans med ClickHouse, och försökte undvika att använda Kafka. Men det behövs åtgärdas vissa mindre kompatibilitetsproblem, som , innan detta kan göras utan ett proxy-lager som konverterar data från FluentBit till ClickHouse.
Som alternativ till Kibana kan ClickHouse användas som backend . Såvitt jag förstår kan det uppstå prestandaproblem vid rendering av stora datamängder, särskilt med äldre versioner av Grafana. Vi har ännu inte provat detta på Qwintry, men klagomål om detta dyker tidsenligt upp på ClickHouse-supportkanalen i Telegram.
Ersättning för Google Big Query och Amazon RedShift (lösning för stora företag)
Den perfekta användningen av BigQuery är att ladda upp 1 TB JSON-data och utföra analytiska frågor på dem. BigQuery är en fantastisk produkt vars skalbarhet är svår att överskatta. Det är mycket mer komplex mjukvara än ClickHouse, som körs på intern kluster, men ur kundens perspektiv har det mycket gemensamt med ClickHouse. BigQuery kan snabbt "bli dyrt" så snart du börjar betala per SELECT, så det är en verklig SaaS-lösning med alla dess fördelar och nackdelar.
ClickHouse är det bästa valet om du kör många resurskrävande frågor. Ju fler SELECT-frågor du kör varje dag, desto mer meningsfullt är det att byta ut BigQuery mot ClickHouse, eftersom en sådan byte kan spara dig tusentals dollar när det gäller många terabyte av bearbetade data. Detta gäller inte för lagrad data, vars bearbetning i BigQuery är ganska billig.
I artikeln av Altinities medgrundare Alexander Zaitsev beskrivs fördelarna med en sådan databasövergång.
Ersättning för TimescaleDB
TimescaleDB är en utvidgning av PostgreSQL som optimerar arbetet med tidsserier i en vanlig databas, ).
Även om ClickHouse inte är en seriös konkurrent inom tidsserieområdet, är det mycket snabbare än TimescaleDB för de flesta analytiska förfrågningar tack vare sin kolumnstruktur och vektoriserade frågeexekvering. Dessutom är ClickHouse:s prestanda för att ta emot batchdata cirka tre gånger bättre, och den använder dessutom 20 gånger mindre lagringsutrymme, vilket är avgörande för hantering av stora mängder historiska data:.
Till skillnad från ClickHouse är det enda sättet att spara lite lagringsutrymme i TimescaleDB att använda ZFS eller liknande filsystem.
Framtida uppdateringar av ClickHouse kommer förmodligen att införa delta-kompression som gör det ännu mer lämpligt för att hantera och lagra tidsseriedata. TimescaleDB kan vara det bättre valet än "rena" ClickHouse i följande fall:
- små installationer med mycket lite RAM (<3 GB);
- ett stort antal små INSERT-operationer som du inte vill buffra i stora block;
- bättre konsekvens, enhetlighet och ACID-krav;
- stöd för PostGIS;
- integration med befintliga PostgreSQL-tabeller, eftersom TimescaleDB i huvudsak är PostgreSQL.
Konkurrens med Hadoop och MapReduce
Hadoop och andra MapReduce-produkter kan utföra många komplexa beräkningar, men de verkar vanligtvis med enorma fördröjningar. ClickHouse löser detta problem genom att bearbeta terabyte av data och nästan omedelbart producera resultat. Därför är ClickHouse mycket effektivare för att utföra snabb, interaktiv analytisk forskning, vilket bör intressera databehandlingsspecialister.
Konkurrens med Pinot och Druid
De närmaste konkurrenterna till ClickHouse är kolumnar linjärt skalbara open source-produkter som Pinot och Druid. Utmärkt arbete med att jämföra dessa system publicerades i artikeln den 1 februari 2018.
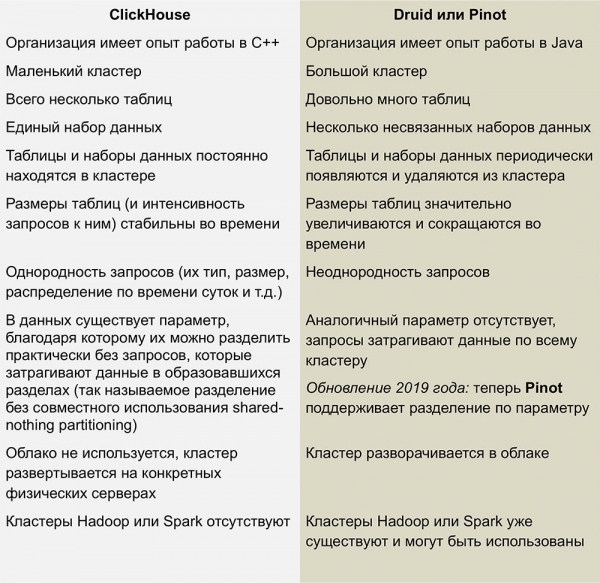
Denna artikel behöver uppdateras – den påstår att ClickHouse inte stöder UPDATE och DELETE-operationer, vilket inte är helt korrekt i förhållande till de senaste versionerna.
Vi har inte tillräcklig erfarenhet av att arbeta med dessa databashanteringssystem, men jag gillar verkligen inte komplexiteten hos den infrastruktur som krävs för att köra Druid och Pinot – det är en hel del "rörliga delar" omgiven av Java från alla håll.
Druid och Pinot är inkubatorprojekt inom Apache, vars utvecklingsförlopp detaljerat belyses av Apache på sina GitHub-projekt. Pinot debuterade i inkubatorn i oktober 2018, medan Druid föddes åtta månader tidigare – i februari.
Bristen på information om hur AFS fungerar väcker några, och kanske fåniga, frågor hos mig. Jag undrar om författarna till Pinot har märkt att Apache Foundation är mer gynnsam mot Druid, och om denna inställning till konkurrenten har orsakat någon form av avundsjuka? Kommer Druid att bromsa sin utveckling medan Pinot snabbt går framåt, om sponsorerna som stödjer den förra plötsligt blir intresserade av den senare?
Nackdelar med ClickHouse
Omoget: det är uppenbart att det fortfarande är en fascinerande teknik, men det finns ändå ingenting liknande i andra kolumnbaserade databashanteringssystem.
Små insättningar fungerar dåligt med hög hastighet: insättningar måste delas upp i större bitar, eftersom prestandan för små insättningar minskar i proportion till antalet kolumner i varje rad. Så här lagras data i ClickHouse på disken – varje kolumn motsvarar en eller flera filer, så för att infoga en rad som innehåller 100 kolumner måste minst 100 filer öppnas och skrivas. Därför krävs en medlare för att buffra insättningar (om inte själva klienten tillhandahåller buffring) – vanligtvis är det Kafka eller något köhanteringssystem. Man kan också använda Buffer table-motorn för att senare kopiera stora datasegment till MergeTree-tabeller.
Tabellanslutningar begränsas av serverns arbetsminne, men åtminstone finns de där! Till exempel finns det inga sådana anslutningar i Druid och Pinot, eftersom de är svåra att implementera direkt i distribuerade system som inte stödjer överföring av stora datamängder mellan noder.
Slutsatser
Under de kommande åren planerar vi att använda ClickHouse i Qwintry i stor utsträckning, eftersom denna databas ger en utmärkt balans mellan prestanda, låga overheadkostnader, skalbarhet och enkelhet. Jag är nästan säker på att den kommer att börja spridas snabbt så snart ClickHouse-gemenskapen hittar fler sätt att använda den i små och medelstora installationer.
Lite reklam 🙂
Tack för att ni stannar kvar hos oss. Gillar ni våra artiklar? Vill ni se fler intressanta material? Stöd oss genom att göra en beställning eller rekommendera oss till era vänner, , en unik motsvarighet till entry-level servrar som vi har skapat för er: (alternativ med RAID1 och RAID10 finns tillgängliga, upp till 24 kärnor och upp till 40GB DDR4).
Dell R730xd är två gånger billigare i datacentret Equinix Tier IV i Amsterdam? Bara hos oss i Nederländerna! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — från $99! Läs om
Källa: habr.com
