

Hej! Jag heter Danil Lipovoy, och vårt team på Sbertech har börjat använda HBase som ett datalagringssystem. Under studiet av detta har vi samlat erfarenhet som vi ville systematisera och beskriva (vi hoppas att det blir till nytta för många). Alla experiment som beskrivs nedan utfördes med versionerna HBase 1.2.0-cdh5.14.2 och 2.0.0-cdh6.0.0-beta1.
- Övergripande arkitektur
- Skriva data till HBASE
- Läsa data från HBASE
- Cachning av data
- Batchbehandling av data MultiGet/MultiPut
- Strategi för uppdelning av tabeller i regioner (splitting)
- Tålighet, komprimering och lokalitet av data
- Inställningar och prestanda
- Belastningstestning
- Slutsatser
1. Övergripande arkitektur
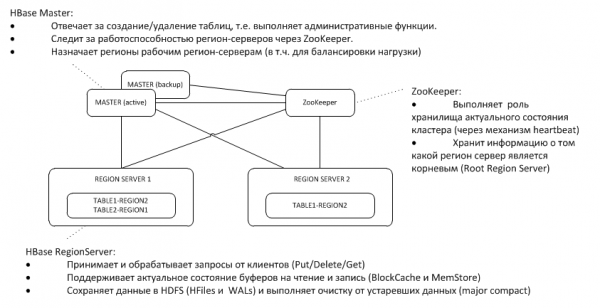
En reserv Master övervakar heartbeat från den aktiva på noden ZooKeeper och tar över masterfunktionen i händelse av att den avaktiveras.
2. Skriva data till HBASE
Först tittar vi på det enklaste fallet – att skriva ett nyckel-värde-objekt till en viss tabell med hjälp av put(rowkey). Klienten måste först ta reda på var den rotregioner servern (Root Region Server – RRS) ligger, som lagrar tabellen hbase:meta. Denna information får den från ZooKeeper. Därefter kontaktar den RRS och läser tabellen hbase:meta, från vilken den hämtar information om vilken RegionServer (RS) som ansvarar för att lagra data för den angivna nyckeln rowkey i den tabell som intresserar den. För framtida användning cachar klienten metatabellen, och därför går de efterföljande förfrågningarna snabbare, direkt till RS.
Därefter skriver RS, efter att ha mottagit förfrågan, först in den i WriteAheadLog (WAL), vilket är nödvändigt för återställning vid ett systemhaveri. Sedan sparas data i MemStore. Detta är en minnesbuffer som innehåller en sorterad uppsättning nycklar för denna region. Tabellen kan delas upp i regioner (partitioner), som var och en innehåller en icke-överliggande uppsättning nycklar. Detta tillåter, genom att placera regionerna på olika servrar, att uppnå högre prestanda. Men trots att denna slutsats är uppenbar, kommer vi att se att det inte alltid fungerar på detta sätt.
Efter att posten har lagts i MemStore får klienten en bekräftelse på att posten har sparats framgångsrikt. Den sparas dock egentligen bara i bufferten och kommer att överföras till disken först efter att en viss tidsperiod har passerat eller när den har fyllts med nya data.
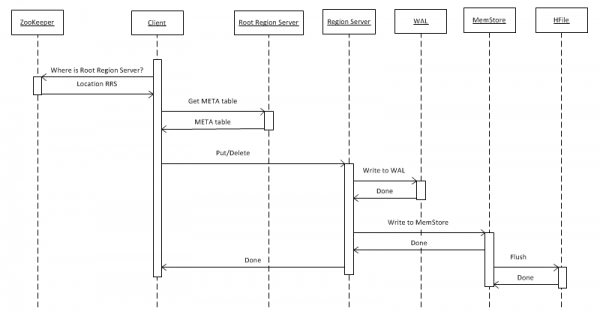
Vid utförandet av operationen "Delete" sker ingen fysisk radering av data. De markeras helt enkelt som raderade, och själva förstörelsen sker vid anrop av funktionen major compact, som beskrivs mer detaljerat i punkt 7.
Filer i HFile-format samlas i HDFS och med jämna mellanrum körs processen minor compact, som helt enkelt sammanfogar små filer till större utan att radera något. Med tiden blir detta ett problem som endast visar sig vid läsning av data (detta kommer vi att återkomma till senare).
Förutom den beskrivna uppladdningsprocessen finns det en mycket effektivare procedur, som utgör kanske den starkaste sidan av denna databas – BulkLoad. Det handlar om att vi själva skapar HFiles och lägger in dem på disken, vilket tillåter utmärkt skalning och uppnåelse av ganska anständiga hastigheter. I princip är det inte HBase som sätter gränser här, utan hårdvarans kapabiliteter. Nedan visas resultaten av uppladdningen på en kluster bestående av 16 RegionServers och 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 trådar), version HBase 1.2.0-cdh5.14.2.
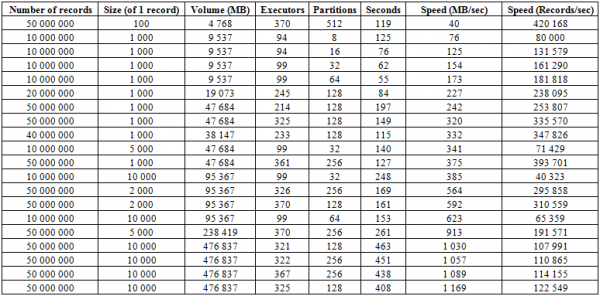
Här kan vi se att genom att öka antalet partitioner (regioner) i tabellen samt Spark-exekverare får vi en ökning av uppladdningshastigheten. Hastigheten beror också på skrivvolymen. Stora block ger en ökning i mått av MB/s, medan små block ökar antalet inskrivna poster per tidsenhet, vid övriga lika förhållanden.
Det är också möjligt att starta uppladdning i två tabeller samtidigt och få en dubblering av hastigheten. Nedan kan vi se att skrivningen av 10 KB block direkt i två tabeller går med en hastighet på cirka 600 Mb/s i varje (totalt 1275 Mb/s), vilket stämmer överens med skrivhastigheten i en tabell på 623 MB/s (se punkt №11 ovan).
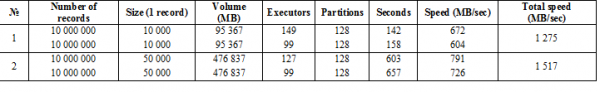
Den andra körningen med 50 KB-inspelningar visar att uppladdningshastigheten ökar endast i begränsad utsträckning, vilket indikerar att vi närmar oss de maximala värdena. Härvid bör man ha i åtanke att HBASE i princip inte belastas alls, allt som krävs från den är att först returnera data från hbase:meta, och efter inlagan av HFiles, tömma BlockCache och spara MemStore-bufferten på disken, om den inte är tom.
3. Läsa data från HBASE
Om vi antar att all information från hbase:meta redan finns hos kunden (se p.2), går förfrågan direkt till den RS där den önskade nyckeln lagras. Först sker sökningen i MemCache. Oavsett om det finns data där eller inte, sker sökningen också i BlockCache och vid behov i HFiles. Om data hittas i filen placeras de i BlockCache och kommer att returneras snabbare vid nästa förfrågan. Sökningen i HFile sker relativt snabbt tack vare användningen av en Bloom-filter, det vill säga genom att läsa en liten mängd data kan det direkt avgöra om denna fil innehåller den önskade nyckeln, och om inte, går det vidare till nästa.
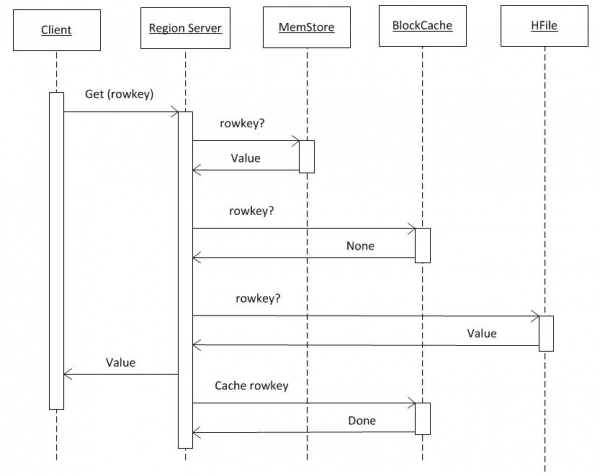
När data har erhållits från dessa tre källor bildar RS svaret. I synnerhet kan det skicka flera hittade versioner av objektet om kunden har begärt versionering.
4. Cachning av data
Buffrarna MemStore och BlockCache tar upp till 80% av den tilldelade on-heap-minnet på RS (resten är reserverat för tjänsteuppgifter i RS). Om den typiska användningen är sådan att processer skriver och omedelbart läser dessa samma data, är det meningsfullt att minska BlockCache och öka MemStore, eftersom data vid skrivning inte går in i läscachen, vilket gör att användningen av BlockCache blir mindre frekvent. BlockCache-bufferten består av två delar: LruBlockCache (alltid on-heap) och BucketCache (vanligtvis off-heap eller på SSD). BucketCache bör användas när det finns många läsningsförfrågningar som inte får plats i LruBlockCache, vilket leder till aktivt arbete av Garbage Collector. Vid detta tillfälle bör man inte förvänta sig en radikal ökning av prestanda från användningen av läs-cache, men vi återkommer till detta i p. 8.
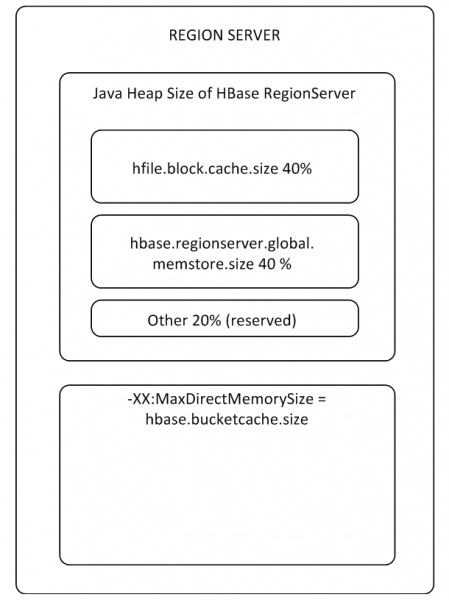
BlockCache är gemensam för hela RS, medan MemStore är specifik för varje tabell (en för varje Column Family).
Hur I teorin går data inte in i cachen vid skrivning och faktiskt är sådana parametrar CACHE_DATA_ON_WRITE för tabellen och 'Cache DATA on Write' för RS inställda på false. Men i praktiken, om man skriver data till MemStore, sedan spolar det till disk (återställer därmed), för att sedan ta bort den resulterande filen, kommer en get-förfrågan framgångsrikt att returnera data. Dessutom, även om BlockCache helt stängs av och tabellen fylls med nya data, för att sedan uppnå en spoling av MemStore till disk, radera dem och be om dem från en annan session, kommer de ändå att hämtas från någonstans. Så HBase lagrar inte bara data utan även mystiska mysterier.
hbase(main):001:0> create 'ns:magic', 'cf'
Skapade tabell ns:magic
Tog 1.1533 sekunder
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Tog 0.2610 sekunder
hbase(main):003:0> flush 'ns:magic'
Tog 0.6161 sekunder
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Parametern "Cache DATA on Read" är inställd på false. Om det finns idéer, välkomna att diskutera detta i kommentarerna.
5. Batchbearbetning av data MultiGet/MultiPut
Bearbetning av enskilda förfrågningar (Get/Put/Delete) är en ganska kostsam operation, så det är bäst att gruppera dem i List eller List, vilket ger en betydande prestandaökning. Detta gäller särskilt för skrivoperationer, men vid läsning finns följande fallgropp. I diagrammet nedan visas tiden för att läsa 50 000 poster från MemStore. Läsningen utfördes i en tråd och på den horisontella axeln visas antalet nycklar i förfrågan. Här kan vi se att när antalet nycklar i en förfrågan ökar till tusen, minskar exekveringstiden, det vill säga hastigheten ökar. Men med standardläget för MSLAB börjar prestandan falla kraftigt efter denna tröskel, och ju större datamängden i posten är, desto mer ökar arbetstiden.
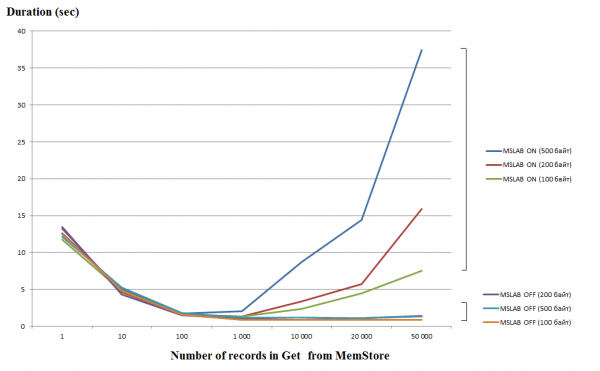
Tester utfördes på en virtuell maskin med 8 kärnor, version HBase 2.0.0-cdh6.0.0-beta1.
MSLAB-läget syftar till att minska fragmenteringen av heap, vilket uppstår genom blandning av nya och gamla generationers data. För att lösa problemet, när MSLAB är aktiverat, placeras data i relativt små celler (chunk) och bearbetas i portioner. Som ett resultat, när volymen i den begärda datapaketet överskrider den tilldelade storleken, minskar prestandan kraftigt. Å andra sidan är det inte önskvärt att stänga av detta läge, eftersom det kan leda till stopp på grund av GC vid intensiva databehandlingsmoment. En bra lösning är att öka storleken på cellerna vid aktiv skrivning med put samtidigt som man läser. Det bör noteras att problemet inte uppstår om man efter skrivningen utför flush-kommandot som överför MemStore till disken eller om data laddas med hjälp av BulkLoad. I tabellen nedan visas att förfrågningar från MemStore med större datamängder (och samma antal) leder till fördröjningar. Men genom att öka chunksize återfår vi bearbetningstiden till det normala.
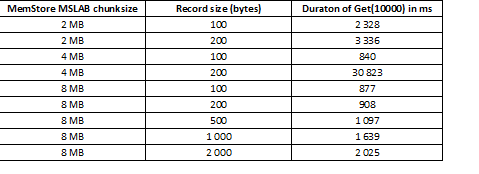
Förutom att öka chunksize är det också effektivt att dela upp data efter regioner, det vill säga tabellsplittring. Detta innebär att varje region får färre förfrågningar och om de placeras i en cell, förblir svarstiden bra.
6. Strategi för att dela upp tabeller i regioner (splittring)
Eftersom HBase är en nyckel-värde lagringslösning och partitioneringen sker baserat på nyckel, är det mycket viktigt att fördela data jämnt över alla regioner. Till exempel kommer partitionering av en sådan tabell i tre delar att resultera i att data delas upp i tre regioner:
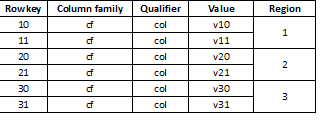
Det händer att detta leder till en kraftig nedgradering, om den data som laddas in senare mestadels består av long-värden som börjar med samma siffra, till exempel:
1000001
1000002
…
1100003
Eftersom nycklarna lagras i form av byte-arrayer, kommer alla att börja likadant och tillhöra en region #1 som lagrar detta nyckelintervall. Det finns flera strategier för splittring:
HexStringSplit – Konverterar nyckeln till en sträng med hexadecimalt kodande inom intervallet «00000000» => «FFFFFFFF» och fyller vänster med nollor.
UniformSplit – Konverterar nyckeln till en byte-array med hexadecimalt kodande inom intervallet «00» => «FF» och fyller höger med nollor.
Dessutom kan man ange vilket intervall eller uppsättning av nycklar som helst för splittring och konfigurera automatisk splittring. Men en av de enklaste och mest effektiva metoderna är UniformSplit och att använda hash-konkatenation, till exempel den högsta byte-paret från körningen av nyckeln genom CRC32(rowkey) funktionen och själva rowkey:
hash + rowkey
Då kommer alla data att fördelas jämnt över regionerna. Vid läsning kastas de första två bytesen helt enkelt bort och den ursprungliga nyckeln kvarstår. RS kontrollerar även mängden data och nycklar i regionen och bryter automatiskt upp den i delar när gränserna överskrids.
7. Felresiliens och datalokalisering
Eftersom varje nyckelset bara ansvarar för en region är lösningen på problem relaterade till RS-nederlag eller nedläggning att lagra all nödvändig data i HDFS. Vid ett RS-nederlag upptäcker master detta genom att inte få någon heartbeat från ZooKeeper-noden. Då tilldelar den en annan RS den drabbade regionen, och eftersom HFiles lagras i ett distribuerat filsystem, så läser den nya ägaren dem och fortsätter att betjäna data. Emellertid, eftersom en del data kan vara i MemStore och ännu inte har kommit in i HFiles, används WAL för att återställa operationernas historik, som också lagras i HDFS. Efter att förändringar har genomförts kan RS svara på förfrågningar, men flyttningen innebär att en del data och processer som hanterar dem hamnar på olika noder, vilket reducerar lokalitet.
Lösningen på problemet är major compaction – denna procedur flyttar filer till de noder som ansvarar för dem (dit där deras regioner ligger), vilket resulterar i att belastningen på nätverket och diskarna ökar kraftigt under denna procedur. Men senare förbättras åtkomsten till data markant. Dessutom utför major_compaction en sammanslagning av alla HFiles till en enda fil inom regionen och rensar data beroende på tabellinställningarna. Till exempel kan du ställa in antalet versioner av ett objekt som ska sparas eller dess livslängd, efter vilken objektet tas bort fysiskt.
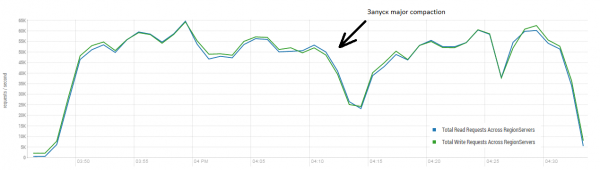
Denna procedur kan ha en mycket positiv effekt på HBase:s prestanda. På bilden nedan kan man se hur prestandan försämrades till följd av aktiv dataskrivning. Här syns hur 40 trådar skrev till en tabell och 40 trådar läste data samtidigt. Skrivraven genererar fler och fler HFiles som läses av andra trådar. Som resultat måste allt fler data tas bort från minnet och till slut startar GC, som i stort sett lamnar hela arbetet. Starten av major compaction ledde till rensning av de uppkomna avlagringarna och återställande av prestandan.
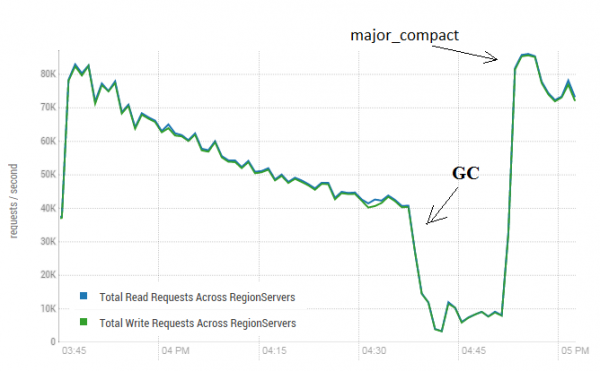
Testet utfördes på 3 DataNode och 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 trådar). HBase version 1.2.0-cdh5.14.2
Det är värt att notera att major compaction kördes på en "levande" tabell där data aktivt skrivits och lästs. Det har påståtts på nätet att detta kan leda till felaktiga svar vid läsning av data. För att verifiera detta startades en process som genererade nya data och skrev dem till tabellen. Därefter lästes dessa data omedelbart och jämfördes med det som hade skrivits. Under denna process kördes major compaction cirka 200 gånger och inga fel registrerades. Problemet kan eventuellt uppträda sällan och endast vid hög belastning, därför är det mer säkert att planera stopp av skriv- och läsprocesser och utföra rensning för att undvika sådana GC-fall.
Dessutom påverkar major compaction inte tillståndet för MemStore; för att spola dess innehåll till disk och kompaktera måste flush användas (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Inställningar och prestanda
Som redan nämnts visar HBase störst framgång där det inte behöver utföra några åtgärder, vid användning av BulkLoad. Detta gäller dock de flesta system och människor. Men detta verktyg är mer lämpligt för massinsättning av data i stora block, medan om processen kräver utförande av många konkurrerande läsa- och skrivförfrågningar används de ovan beskrivna kommandona Get och Put. För att fastställa optimala parametrar genomfördes körningar med olika kombinationer av tabellparametrar och inställningar:
- 10 trådar kördes samtidigt tre gånger i rad (låt oss kalla detta en trådblock).
- Körtiden för alla trådar i blocket genomsnittades och var det slutgiltiga resultatet av blockets arbete.
- Alla trådar arbetade med samma tabell.
- Innan varje körning av trådblock utfördes en major compaction.
- Varje block utförde endast en av följande operationer:
— Put
— Get
— Get+Put
- Varje block utförde 50 000 upprepningar av sin operation.
- Storleken på en post i blocket var 100 byte, 1000 byte eller 10000 byte (slumptal).
- Blocken kördes med varierande antal begärda nycklar (antingen en nyckel eller 10).
- Blocken kördes med olika tabellinställningar. Följande parametrar ändrades:
— BlockCache = aktiverad eller inaktiverad
— BlockSize = 65 KB eller 16 KB
— Partitioner = 1, 5 eller 30
— MSLAB = aktiverad eller inaktiverad
Så här ser blocket ut:
a. MSLAB-läge aktiverades/avaktiverades.
b. En tabell skapades där följande parametrar ställdes in: BlockCache = true/none, BlockSize = 65/16 Kb, Partitioner = 1/5/30.
c. GZ-komprimering ställdes in.
d. 10 trådar kördes samtidigt som utförde 1/10 operationer put/get/get+put till denna tabell med poster på 100/1000/10000 byte, vilket resulterade i 50 000 på varandra följande förfrågningar (nycklar slumpmässiga).
e. Punkt d upprepades tre gånger.
f. Den genomsnittliga körtiden för alla trådar beräknades.
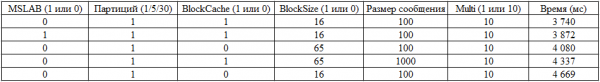
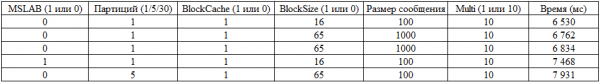
Alla möjliga kombinationer testades. Det var förutsägbart att med ökad poststorlek skulle hastigheten minska eller att inaktivering av cachelagring skulle leda till en nedgång. Målet var dock att förstå graden och betydelsen av påverkan av varje parameter, därför matades de insamlade uppgifterna in i en linjär regressionsfunktion, vilket möjliggör att uppskatta tillförlitligheten med hjälp av t-statistik. Nedan framgår resultaten från block som utför operationer Put. Den fullständiga uppsättningen kombinationer 2*2*3*2*3 = 144 alternativ + 72, eftersom vissa genomfördes två gånger. Således blev det sammanlagt 216 körningar:
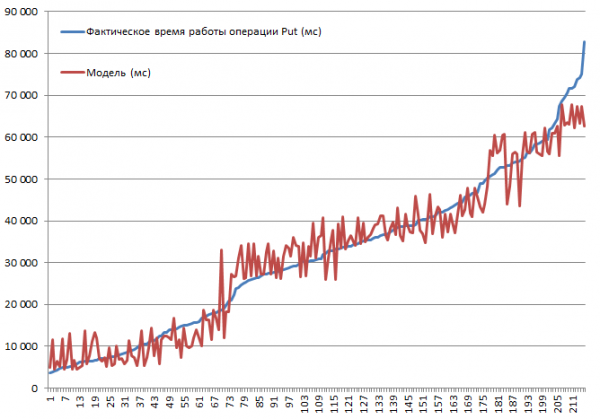
Testning utfördes på en mini-kluster bestående av 3 DataNodes och 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 trådar). HBase-version 1.2.0-cdh5.14.2.
Den högsta insättningstakten på 3,7 sekunder uppnåddes när MSLAB-läget var avstängt, på en tabell med en partition, med BlockCache aktiverat, BlockSize = 16, poster på 100 byte i grupper om 10.
Den lägsta insättningstakten på 82,8 sekunder uppnåddes när MSLAB-läget var aktiverat, på en tabell med en partition, med BlockCache aktiverat, BlockSize = 16, poster på 10000 byte i enstaka.
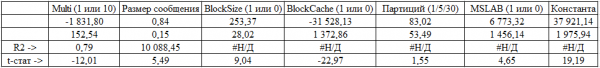
Nu ska vi titta på modellen. Vi ser en bra kvalitet av modellen enligt R2, men det är helt klart att extrapolering här inte rekommenderas. Det verkliga beteendet hos systemet vid parameterförändringar kommer att vara icke-linjärt, denna modell behövs inte för prognoser, utan för att förstå vad som hände inom angivna parametrar. Till exempel ser vi här enligt Student-kriteriet att för operationen Put har parametrarna BlockSize och BlockCache ingen betydelse (vilket är ganska förutsägbart):
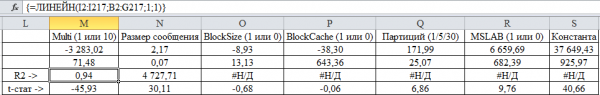
Det är ganska oväntat att en ökning av antalet partitioner leder till en minskning av prestanda (vi har redan sett den positiva effekten av att öka antalet partitioner vid BulkLoad), även om det är förklarligt. För det första innebär det att man måste formulera förfrågningar till 30 regioner istället för en, och datavolymen är inte tillräckligt stor för att ge vinst. För det andra definieras den totala svartiden av den långsammaste RS, och eftersom antalet DataNodes är mindre än antalet RS har vissa regioner noll lokalitet. Låt oss också titta på topp fem:
Nu får vi utvärdera resultaten från Get-blocken:
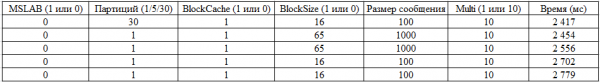
Antalet partitioner har förlorat sin betydelse, vilket troligen beror på att datan cachas väl och att cachen för läsning är den mest betydelsefulla (statistiskt sett) parametern. Naturligtvis är det också mycket fördelaktigt för prestandan att öka antalet meddelanden i förfrågan. Bästa resultaten:
Och slutligen, låt oss titta på modellen för blocket som först utförde get och sedan put:
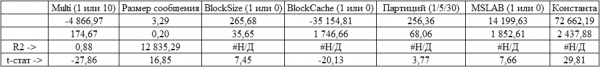
Här är alla parametrar signifikanta. Och resultaten för ledarna:
9. Belastningstestning
Och slutligen ska vi köra en mer eller mindre anständig belastning, men det är alltid mer intressant när man har något att jämföra med. På DataStax webbplats – den nyckelutvecklare för Cassandra - finns det NT av flera NoSQL-lagringar, inklusive HBase version 0.98.6-1. Inladdningen genomfördes med 40 trådar, datastorleken var 100 byte, SSD-diskar. Resultaten av testningen av Read-Modify-Write-operationerna visade följande resultat.
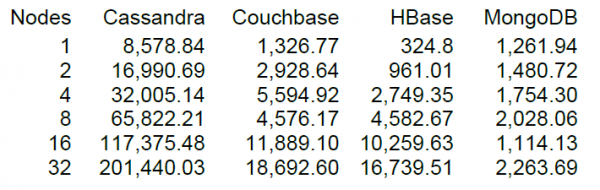
Såvitt jag förstår genomfördes läsningen i block om 100 poster och för 16 noder visade DataStax test av HBase en prestanda på 10 000 operationer per sekund.
Det är tur att vår kluster också har 16 noder, men det är inte så "turigt" att varje noder har 64 kärnor (trådar), medan i DataStax-testet har de bara 4. Å andra sidan har de SSD-diskar, medan vi har HDD, och en nyare version av HBase, och CPU-användning under belastning ökade i stort sett inte märkbart (visuellt med 5-10 procent). Men vi kommer ändå att försöka köra med denna konfiguration. Standardtabellinställningar, läsning utförs inom nyckelintervallet från 0 till 50 miljoner slumpmässigt (dvs. i grund och botten varje gång nya). Tabellen innehåller 50 miljoner poster, uppdelade i 64 partitioner. Nycklarna är hashade med crc32. Tabellinställningarna är standard, MSLAB är aktiverat. 40 trådar startas, varje tråd läser en uppsättning av 100 slumpmässiga nycklar och skriver omedelbart de genererade 100 byte till dessa nycklar.
Stand: 16 DataNode och 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 trådar). Version HBase 1.2.0-cdh5.14.2.
Det genomsnittliga resultatet ligger närmare 40 000 operationer per sekund, vilket är avsevärt bättre än i DataStax-testet. Men för experimentets skull kan villkoren ändras något. Det är ganska osannolikt att allt arbete kommer att utföras uteslutande med en tabell, och endast med unika nycklar. Anta att det finns en viss "het" uppsättning nycklar som genererar den största belastningen. Därför kommer vi att försöka skapa belastning med större poster (10 KB), också i batchar om 100, i 4 olika tabeller och begränsa nyckelintervallet till 50 000. På grafen nedan visas starten av 40 trådar, varje tråd läser en uppsättning av 100 nycklar och skriver omedelbart slumpmässiga 10 KB till dessa nycklar tillbaka.
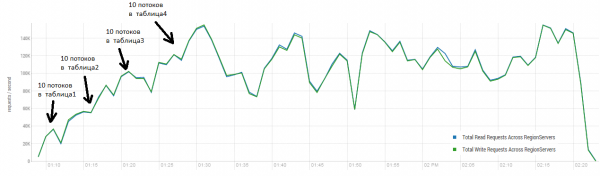
Stand: 16 DataNode och 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 trådar). Version HBase 1.2.0-cdh5.14.2.
Under belastningen genomfördes flera gånger major compaction, som visades ovan utan denna procedur kommer prestandan gradvis att försämras, men under genomförandet uppstår också en ytterligare belastning. Dips orsakas av olika skäl. Ibland avslutade trådarna sitt arbete och medan de startades om uppstod det en paus, ibland skapade externa applikationer belastning på klustret.
Att läsa och skriva direkt är ett av de mest krävande arbetsmönstren för HBase. Om man gör endast små put-förfrågningar, till exempel 100 byte vardera, genom att kombinera dem i paket om 10-50 tusen, kan man uppnå hundratusentals operationer per sekund och likaså gäller det för förfrågningar enbart för läsning. Det är värt att notera att resultaten är radikalt bättre än de som erhölls av DataStax, främst tack vare blockförfrågningar om 50 tusen.
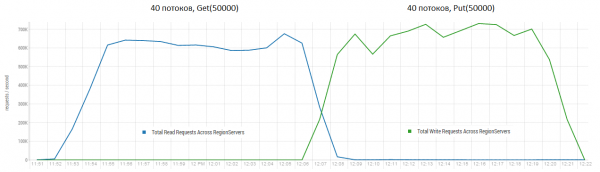
Stand: 16 DataNode och 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 trådar). Version HBase 1.2.0-cdh5.14.2.
10. Slutsatser
Detta system kan konfigureras ganska flexibelt, men påverkan av ett stort antal parametrar är fortfarande oklar. Delar av dem har testats, men ingick inte i det slutgiltiga testsetet. Till exempel visade preliminära experiment en liten betydelse av parametern DATA_BLOCK_ENCODING, som kodar information genom att använda värden från närliggande celler, vilket är helt förståeligt för slumpmässigt genererade data. I fallet med användning av ett stort antal upprepande objekt kan vinsten bli betydande. Generellt kan man säga att HBase ger intrycket av att vara en ganska seriös och genomtänkt databas som kan vara tillräckligt presterande vid operationer med stora datablokker. Särskilt om det finns möjlighet att sprida läs- och skrivprocesserna över tid.
Om du anser att något inte är tillräckligt utförligt, är jag redo att berätta mer. Vi föreslår att ni delar med er av er erfarenhet eller diskuterar om ni inte håller med om något.
Källa: habr.com
