

Enligt , data engineer är för närvarande ett yrke vars efterfrågan växer snabbare än något annat. En data engineer spelar en kritiskt viktig roll inom organisationer – de skapar och underhåller pipelines och databaser som används för att bearbeta, transformera och lagra data. Vilka färdigheter behövs främst av yrkesverksamma inom detta område? Skiljer sig listan från de krav som ställs på data scientists? Om allt detta får du veta i min artikel.
Jag har analyserat jobbannonser för positionen data engineer i den form de har i januari 2020, för att förstå vilka tekniska färdigheter som är mest eftertraktade. Sedan jämförde jag resultaten med statistiken över jobbannonser för positionen data scientist – vilket ledde till några intressanta skillnader.
Utan långa inledningar – här är topp tio teknologier som oftast nämns i jobbannonser:
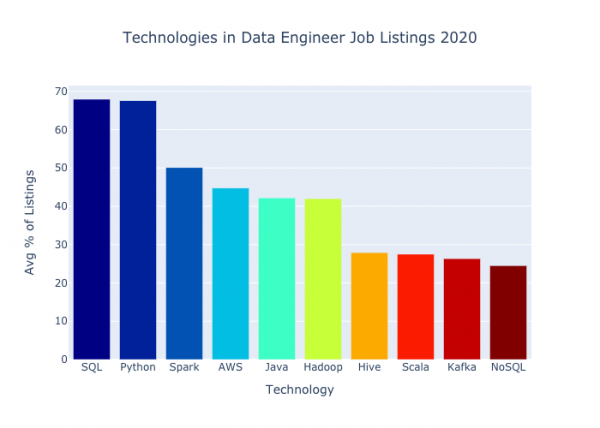
Nämnanden av teknologier i jobbannonser för positionen data engineer år 2020
Låt oss reda ut detta.
Ansvarsområden för data engineer
I dag har det arbete som data engineers utför en enorm betydelse för organisationer – det är dessa personer som ansvarar för att lagra information och omvandla den till ett format som andra anställda kan arbeta med. Data engineers bygger pipelines för att ställa in hämtningen av data, antingen i flöden eller i paket, från många källor. Därefter utför dessa pipelines operationer för extraktion, transformation och inladdning (det vill säga ETL-processer) för att göra datan mer användbar för vidare användning. Efter detta överlämnas datan till analytiker och data scientists för djupare bearbetning. Slutligen avslutar datan sin resa på informationspaneler, i rapporter och modeller för maskininlärning.
Jag sökte information för att dra slutsatser om vilka teknologier som är mest efterfrågade för data engineers för närvarande.
Metoder
Jag samlade information från tre jobbannonseringssajter – , och och undersökte vilka nyckelord som förekommer tillsammans med "data engineer" i jobbtexter riktade till invånare i USA. För den här uppgiften använde jag två Python-bibliotek – och Jag inkluderade nyckelord både från den tidigare listan för analys av jobbannonser för positionen som data scientist och de som jag valde manuellt genom att läsa jobbannonser för data engineers. LinkedIn var inte en av källorna eftersom jag blev avstängd där efter mitt förra försök att samla in data.
För varje nyckelord räknade jag procentandelen träffar av det totala antalet texter på varje webbplats för sig, och sedan beräknade jag medelvärdet från de tre källorna.
Resultat
Nedan presenteras trettio tekniska termer inom data engineering med de högsta värdena från alla tre jobb webbplatser.
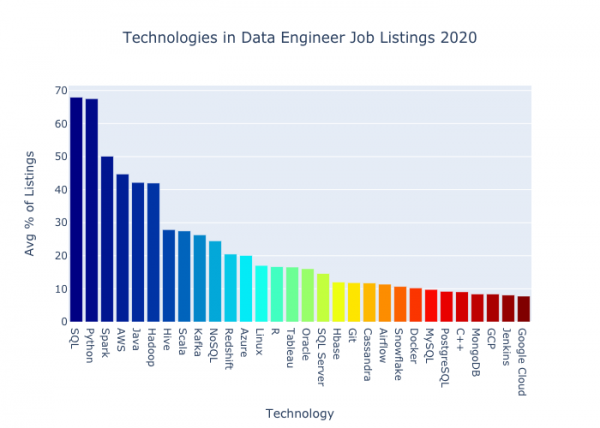
Här är samma siffror, men presenterade i tabellformat:
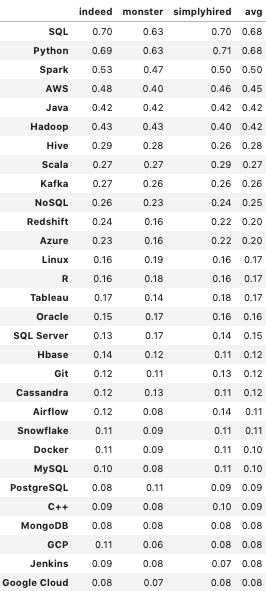
Låt oss gå i ordning.
Översikt av resultaten
Både SQL och Python förekommer i mer än två tredjedelar av de granskade jobbannonserna. Det är dessa två teknologier som har mest mening att studera först. – ett mycket populärt programmeringsspråk som används för att arbeta med data, skapa webbplatser och skriva skript. står för Structured Query Language (strukturerat frågespråk); det innebär en standard som genomförs av en grupp språk och används för att extrahera data från relationella databaser. Det har funnits länge och har visat sig vara mycket stabilt.
Spark nämns i ungefär hälften av jobben. – en "förenad analytisk motor för behandling av stora data med inbyggda moduler för strömning, SQL, maskininlärning och grafbehandling". Det är särskilt populärt bland dem som arbetar med stora databaser.
AWS nämns i ungefär 45% av jobbannonserna. Det är en molnberäkningsplattform som tillverkas av Amazon; den har den största marknadsandelen bland alla molnplattformar.
Därefter kommer Java och Hadoop – liite över 40% var. – ett allmänt förekommande, beprövat språk, som i hamnade på tionde plats bland språk som ger programmerare ångest. I kontrast visade sig Python vara det näst mest älskade språket. Språket Java kontrolleras av Oracle, och allt som behöver veta om det kan förstås härifrån, skärmdumpen från officiella sidan från januari 2020.
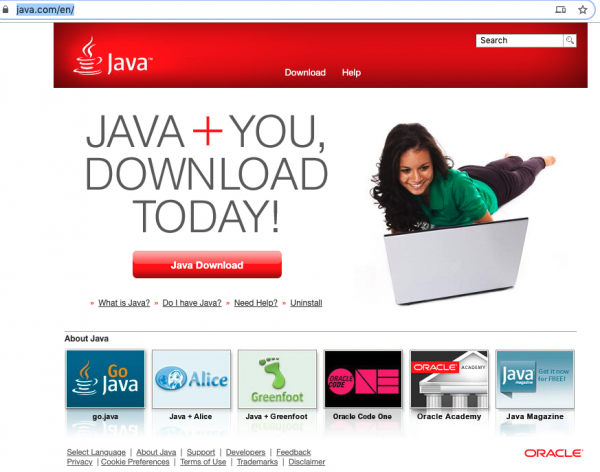
Som om jag åkt tillbaka i tiden
använder en programmodell av MapReduce med serverkluster för stora datamängder. Denna modell avfärdas allt oftare.
Här ser vi Hive, Scala, Kafka och NoSQL – var och en av dessa teknologier nämns i en fjärdedel av de annonserade jobben. Apache Hive är ett datalagringsprogram som "förenklar läsning, skrivning och hantering av stora dataset som ligger i distribuerade lagringssystem med hjälp av SQL. – ett programmeringsspråk som används aktivt för arbete med stora datamängder. Specifikt skapades Spark på Scala. I den nämnda listan över skrämmande programmeringsspråk placerar sig Scala på elfte plats. – en distribuerad plattform för hantering av strömmande meddelanden. Mycket populär som ett verktyg för datastreaming.
ställer sig i kontrast till SQL. De skiljer sig åt genom att de inte är relationella, inte strukturerade och har horisontell skalbarhet. NoSQL har vunnit viss popularitet, men den febrila entusiasmen för denna metod, ända till profetior om att den skulle ersätta SQL som den dominerande lagringsparadigmen, verkar nu vara förbi.
Jämförelse med termer i jobben för data scientist
Här är trettio teknologiska termer som är mest förekommande bland arbetsgivare inom data science. Denna lista fick jag på samma sätt som jag beskrev ovan för data engineering.
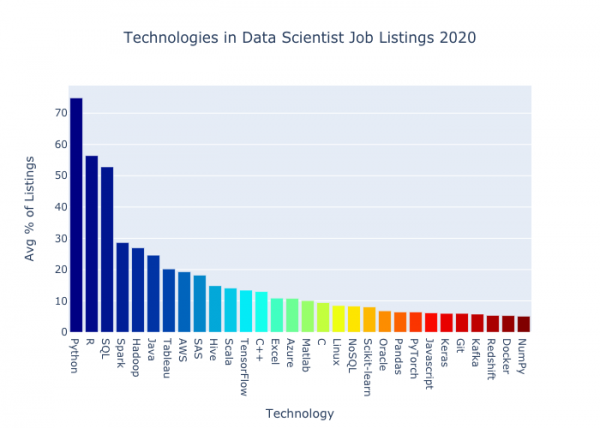
Nämnanden av teknologier i jobben för data scientist under 2020
Om vi pratar om det totala antalet visade det sig att det fanns fler annonser, 28% fler (12 013 mot 9396). Låt oss titta på vilka teknologier som förekommer i jobben för data scientists mindre ofta än för data engineers.
Mer populära inom data engineering
I diagrammet nedan visas nyckelord med ett genomsnittligt avvikelse, antingen över 10% eller under -10%.
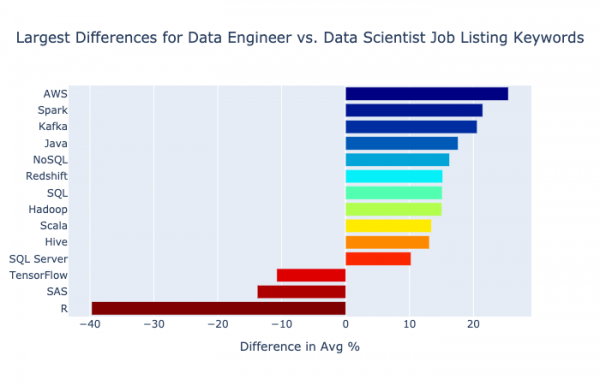
De största skillnaderna i frekvensen av nyckelord hos data engineer och data scientist
Den mest betydelsefulla ökningen ses för AWS: inom data engineering dyker det upp 25% oftare än inom data science (ungefär 45% och 20% av det totala antalet jobb respektive). Skillnaden är märkbar!
Här är samma data i en något annan presentation – i diagrammet placeras resultaten för samma nyckelord i jobben för data engineer och data scientist sida vid sida.
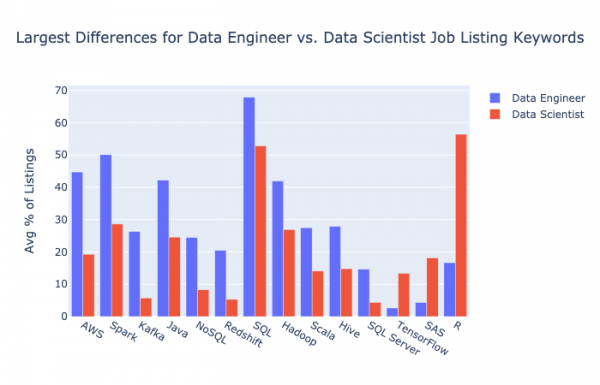
De största skillnaderna i frekvensen av nyckelord hos data engineer och data scientist
Den nästa största ökningen jag har noterat är hos Spark – dataingenjörer arbetar ofta med stora datamängder. har också ökat med 20%, alltså nästan fyra gånger jämfört med resultaten för jobb i data science. Datatransfer är en av de viktigaste uppgifterna för en dataingenjör. Slutligen visade antalet omnämningar på 15% mer inom data engineering för Java, NoSQL, Redshift, SQL och Hadoop.
Mindre populära inom data engineering
Låt oss nu se vilka teknologier som är mindre populära i jobben för dataingenjörer.
Den mest dramatiska nedgången jämfört med data science-skiktet inträffade hos : där syntes den i ungefär 56% av jobben, här – endast 17%. Imponerande. R är ett programmeringsspråk som är populärt bland forskare och statistiker och ligger på åttonde plats i en skrämmande ranking av språk.
finns också i jobben för dataingenjörer avsevärt mindre – skillnaden är 14%. SAS är ett patenterat språk avsett för arbete med statistik och data. En intressant punkt: enligt resultaten från , har det på sistone förlorat mark ordentligt – mer än någon annan teknik.
Eftertraktade både inom data engineering och data science
Det är värt att notera att åtta av de tio bästa positionerna i båda uppsättningarna överensstämmer. SQL, Python, Spark, AWS, Java, Hadoop, Hive och Scala finns i toppen för både data engineering och data science. I diagrammet nedan kan du se femton av de mest populära teknologierna bland arbetsgivare för dataingenjörer, och bredvid dem deras siffror för jobb i data science.
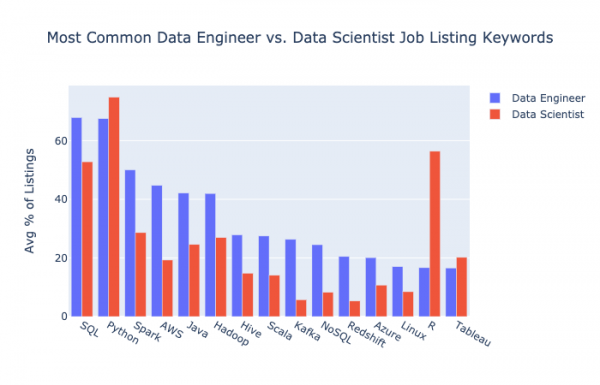
Rekommendationer
Om du vill arbeta med data engineering, skulle jag rekommendera att du lär dig följande teknologier – jag listar dem i ordning efter ungefärligt prioritet.
Lär dig SQL. Jag rekommenderar PostgreSQL, eftersom det har öppen kod, stor popularitet inom samhället och är i en tillväxtfas. Hur man använder språket kan du ta reda på från boken My Memorable SQL – dess pilotversion är tillgänglig .
Behärska Python, även om du inte går in på den mest hardcore nivån. Boken My Memorable Python är just för nybörjare. Den kan köpas på , elektronisk kopia eller fysisk, beroende på ditt val, eller så kan du ladda ner den i pdf- eller epub-format .
Så snart du har bekantat dig med Python, gå vidare till pandas – Python-biblioteket som används för att rensa och bearbeta data. Om du siktar på att arbeta i ett företag där kunskap om Python krävs (vilket de flesta företag gör), kan du vara säker på att kunskaper i pandas kommer att förutsättas som standard. Jag håller för tillfället på att avsluta en introduktionsguide för att arbeta med pandas – du kan , för att inte missa lanseringen.
Lär dig AWS. Om du vill bli dataingenjör är det viktigt att ha en molnplattform i verktygslådan, och AWS är den mest populära av dem. Kurserna , när jag studerade , tror jag att de även har bra material för AWS.
Om du redan har behärskat hela denna lista och vill växa ytterligare i arbetsgivarens ögon som dataingenjör, föreslår jag att du lägger till Apache Spark för att arbeta med stordata. Även om min undersökning om data science-jobb visade på en minskad efterfrågan, syns intresset för dataingenjörer nästan i varje annan jobbannons.
Avslutningsvis
Hoppas att denna översikt över de mest eftertraktade teknologierna för dataingenjörer har varit till nytta. Om du är intresserad av hur det ser ut med jobben för analytiker, läs . Lycka till med ingenjörsjobbet!
Källa: habr.com
